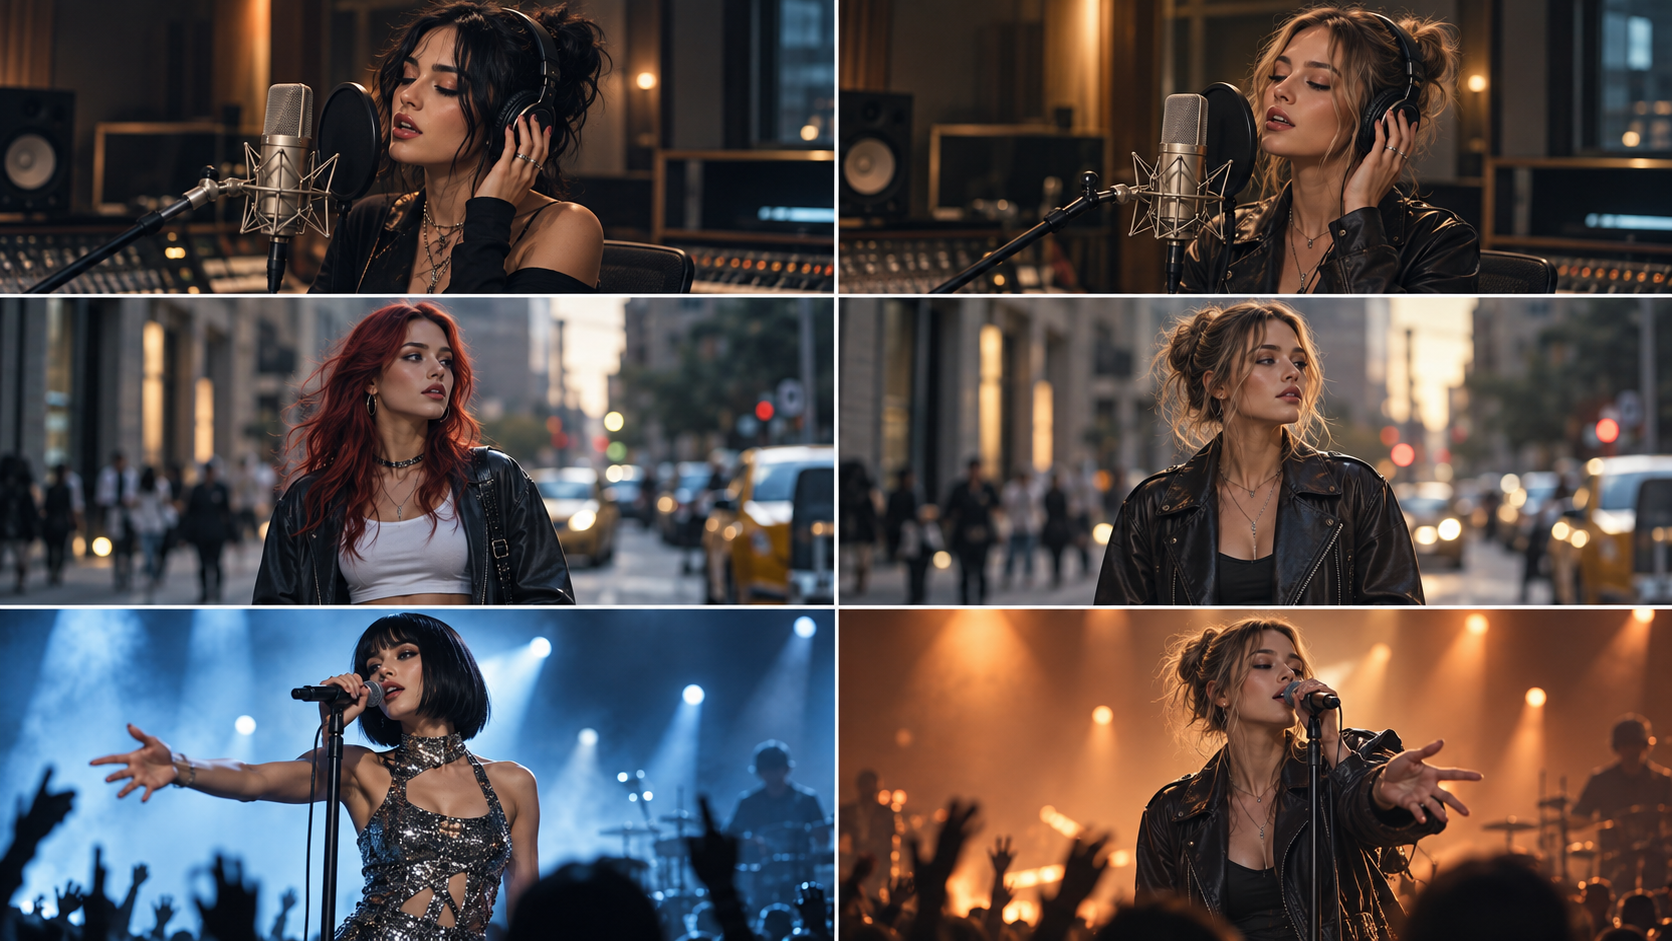
适合唱歌与表演视频的最佳口型同步 AI 音乐视频生成器
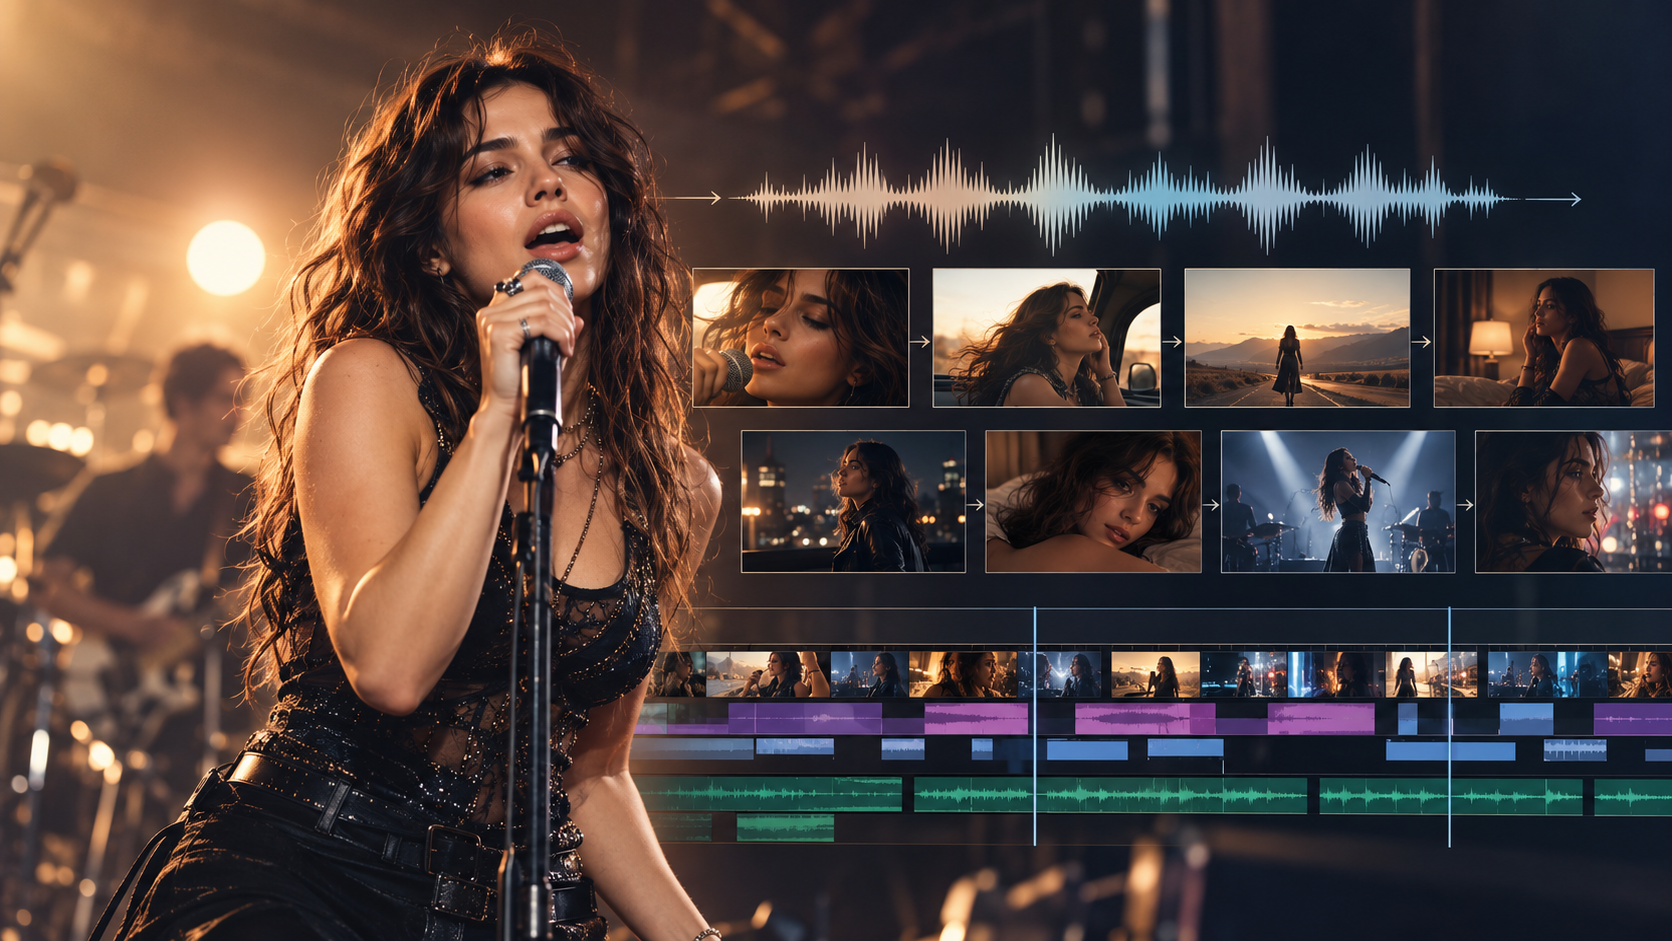
歌手站在舞台上,并不是表演音乐视频真正有说服力的原因。
难点在于,让这位表演者真正感觉和歌曲连在一起。
嘴巴需要跟上人声。表情需要贴合演唱方式。镜头换角度时,同一位艺人还得能被认出来。同样重要的是,视频还要知道什么时候不该让他们唱歌。
所以,选择一款带口型同步的 AI 音乐视频生成器,和选择一款普通 AI 视频生成器,并不是一回事。
有些工具很擅长让一张肖像唱起来。有些能把角色同步到长达几分钟的音频。更少的一部分,能把口型同步和场景规划、角色一致性、懂音乐的剪辑,以及完整的多场景音乐视频工作流结合在一起。
如果你已经有一首完成的曲目,想看看这些环节如何一起运转, BeatViz AI 音乐视频生成器 是围绕完整的歌曲到视频制作来设计的,而不是孤立的 AI 片段。
这份指南会对比目前七款面向 AI 唱歌视频和表演音乐视频的选择,包括 BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen 和 Hedra。
目标不只是问:
这个工具能不能让角色的嘴动起来?
更好的问题是:
这个工具能不能帮你把那场表演做成一支真正的音乐视频?
哪些 AI 音乐视频生成器支持口型同步?
如今已有多款 AI 视频平台,支持某种形式的唱歌或人声口型同步。
真正重要的差别,是口型同步如何融入其余的制作流程。
| 工具 | 口型同步 | 完整音乐视频工作流 | 最适合 |
|---|---|---|---|
| BeatViz | 是,片段级 | 是 | 有场景级控制的完整表演 MV |
| Neural Frames | 是,通过 Vocal Video | 是 | 带选定唱歌场景的音乐响应视频 |
| Freebeat | 是,Singing MV 模式 | 是 | 快速自动生成的唱歌音乐视频 |
| Revid | 是 | 是 | 把歌词、节拍时序和歌手结合在一起的快速音乐视频 |
| Kaiber | 是,图片和视频口型同步 | 部分 / 模块化 | 有创意的单个表演片段 |
| HeyGen | 是 | 以表演者为中心 | 让一张肖像或虚拟形象唱起来 |
| Hedra | 是 | 以角色为中心 | 更长的音频驱动角色表演 |
这个差别很重要,因为 AI 唱歌视频和一支完整的表演音乐视频,并不一定是同一件事。
例如,HeyGen 可以让一张肖像跟着歌曲动起来,Kaiber 则可以把音频驱动的口型同步应用到图片或已有视频上。BeatViz、Neural Frames、Freebeat 和 Revid 则更进一步,把唱歌镜头放进更完整的音乐视频工作流里。
口型同步、节拍同步、歌词同步:它们不是一回事
AI 音乐视频工具容易让人困惑的一个原因,是口型同步、节拍同步和歌词同步这些说法,常常被当成同一件事。
它们并不是。
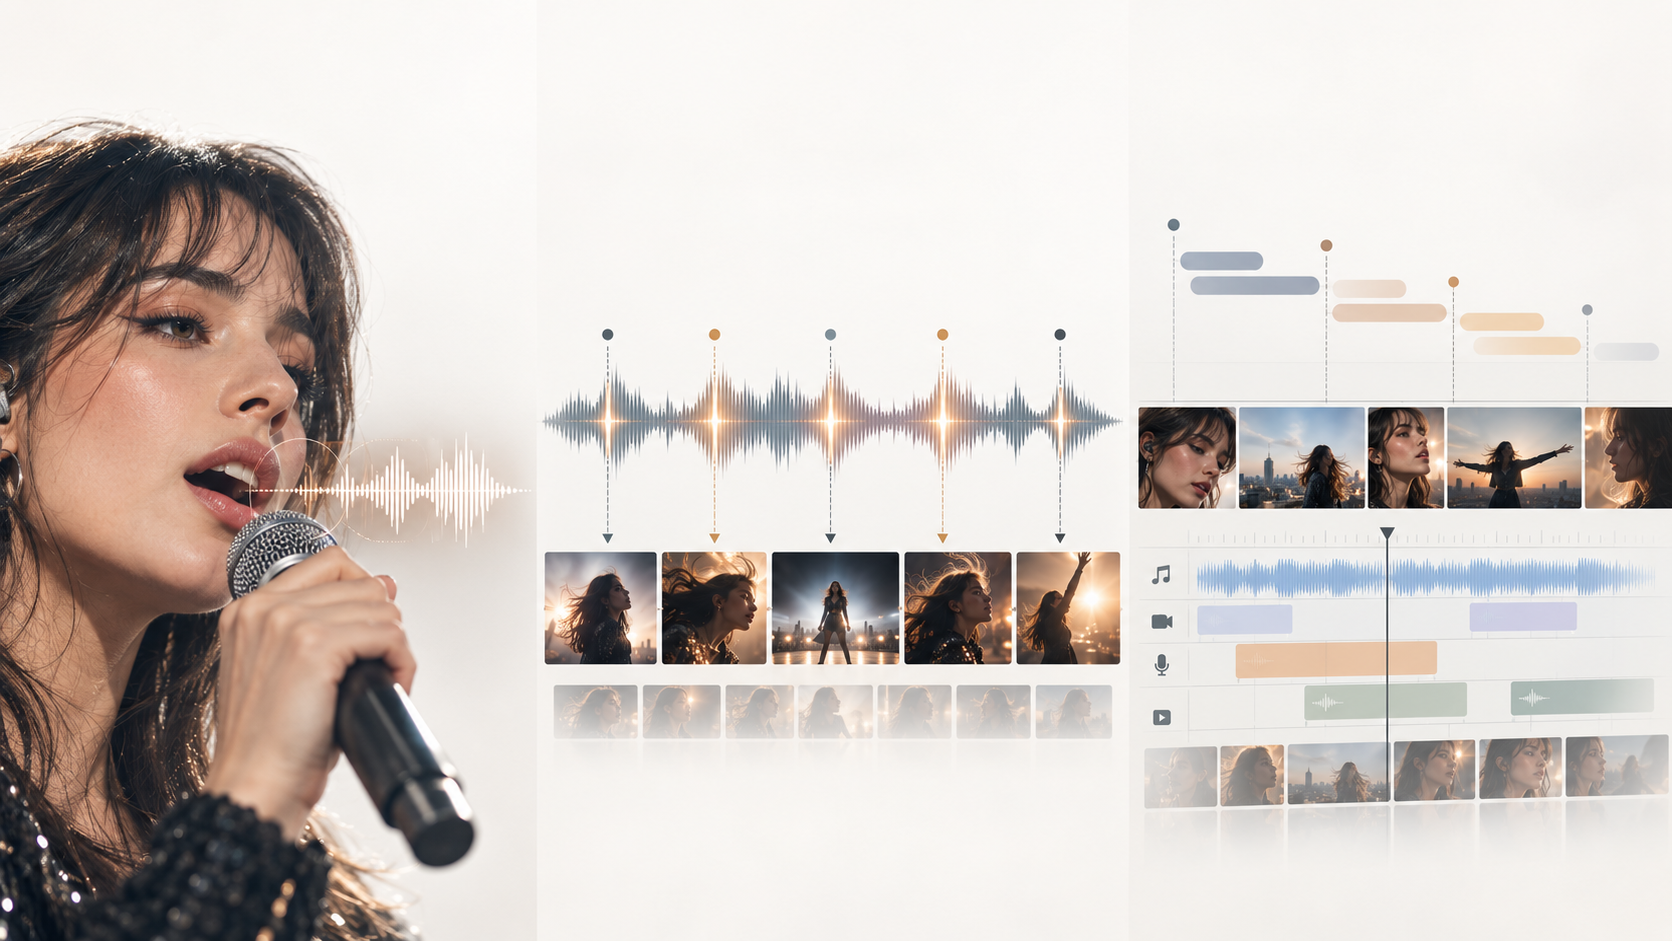
口型同步
口型同步控制的是人声音频和表演者嘴巴之间的关系。
如果歌手发出一个闭唇辅音开头的词,画面里的表演就应该在差不多正确的时刻反映出这个声音。
但有说服力的演唱,远不止嘴型。
特写表演镜头还取决于:
- •面部表情
- •眼神运动
- •头部动作
- •呼吸与乐句
- •身体动作
- •情绪表达
嘴巴在技术上对上了,如果周围一切都像冻住了,看起来仍然会假。
节拍同步
节拍同步影响的是剪辑,而不是歌手的脸。
切镜、转场、镜头切换、视觉效果和场景时长,都可以跟着音乐节奏走。
快的副歌可能会用更短的镜头。
慢的桥段可能会把一个镜头拉得更长。
一次 drop 可能会触发场景转换。
即便画面里没有人,这样也能让视频感觉和音乐连在一起。
歌词同步
歌词同步关注的是文字、字幕或视觉概念,与实际歌词之间的时序关系。
它可以简单到卡拉 OK 式字幕。
也可以意味着围绕某一句歌词的含义来设计场景。
例如 Revid 目前就会在音乐视频工作流里,把歌词时序、节拍时序和可选的歌手口型同步分开处理。
最强的表演视频,往往三者都会用到。
口型同步控制表演者。节拍同步控制剪辑。歌词同步则帮助把画面和歌曲在说什么连起来。
我们如何对比带口型同步的 AI 音乐视频生成器
这不是一次受控的实验室评测,并没有把同一位歌手、同一首歌、同一个种子、同一条提示词和同一套 GPU 条件放到每个平台上测试。
相反,这次对比关注的是各产品当前文档中的工作流,以及音乐人在选择时会问的实际问题:
- •口型同步是怎么应用的?
- •你能不能决定哪些场景里要唱歌?
- •同一位表演者能不能出现在多个镜头里?
- •工具能不能处理一整首歌,而不只是一小段?
- •能不能替换一段失败的表演镜头,而不用把一切推倒重来?
- •平台是理解音乐结构,还是只是根据音频文件让一张脸动起来?
对完整的表演 MV 来说,这些差别比对一个简单的“支不支持口型同步”复选框更重要。
7 款最好的口型同步 AI 音乐视频生成器
1. BeatViz — 最适合把口型同步做进完整表演音乐视频
BeatViz 把口型同步当作更大音乐视频制作工作流里的一环。
它不是从一张脸开始,再让这张脸唱完整首歌,而是可以从音乐本身出发。
平台目前提供三种相互衔接的方式:
- •Workflow:一步步搭起完整视频。
- •AI Director:通过对话来发展音乐视频。
- •Editor:直接掌控时间轴和片段级调整。
这个区分,对表演视频尤其有用。
一首三分钟的歌,很少需要三分钟连续不断的口型同步。
你可能希望第一段副歌用特写表演,第二段主歌切到叙事画面,桥段再回到歌手,最后用一场更大的表演收尾。
这意味着,口型同步更适合作为导演决策,而不是全局效果。
从表演者开始,而不是从嘴巴开始
好的口型同步,在进入口型同步阶段之前就已经开始了。
如果艺人在镜头之间换了身份,嘴唇对得再准也救不了这支视频。
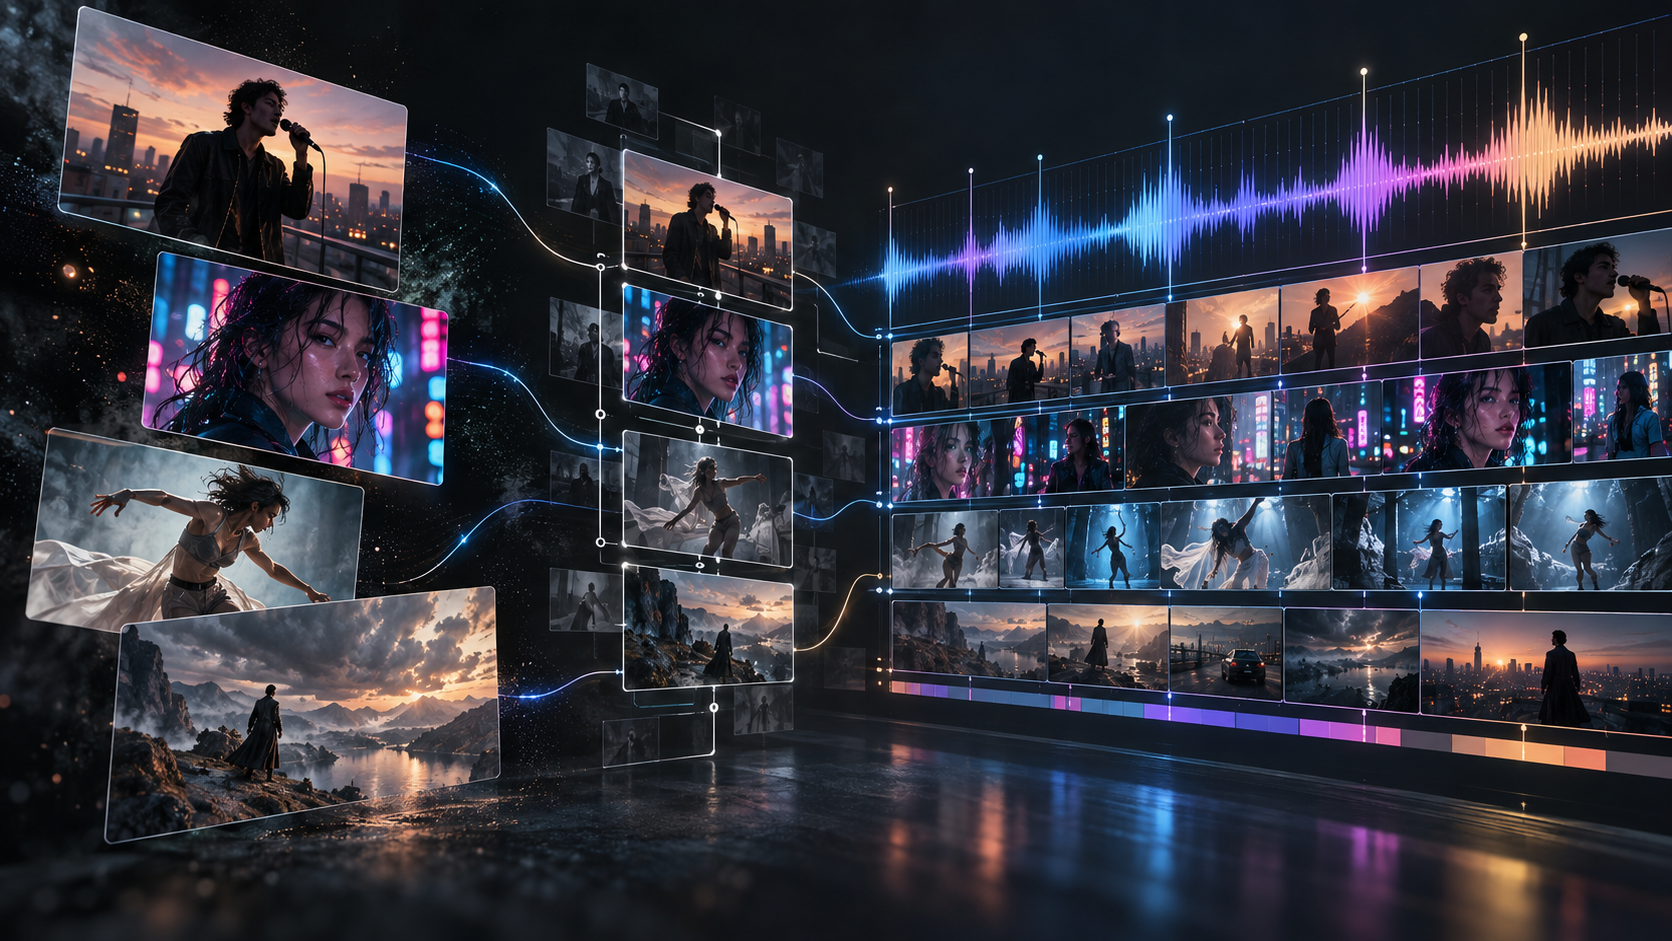
在 BeatViz Workflow 里,你可以在最终视频生成之前,先确定歌曲、视觉方向、角色、场景、镜头和首帧。
这样更容易把表演者当成反复出现的角色,而不是每次切镜都生成一个新人。
如果角色连续性才是你的主要问题,可以看我们另一篇关于 角色一致性最好的 AI 音乐视频生成器 的指南。

用 AI Director 来导演这场表演
表演 MV 也需要创意决策。
例如:
第一段主歌保持电影感和故事驱动。副歌用直视镜头的表演。最后的 hook 再回到特写表演。
这类方向,可以通过 BeatViz AI Director 来发展,而不必把每一个创意决定都手动翻译成单独的生成提示词。
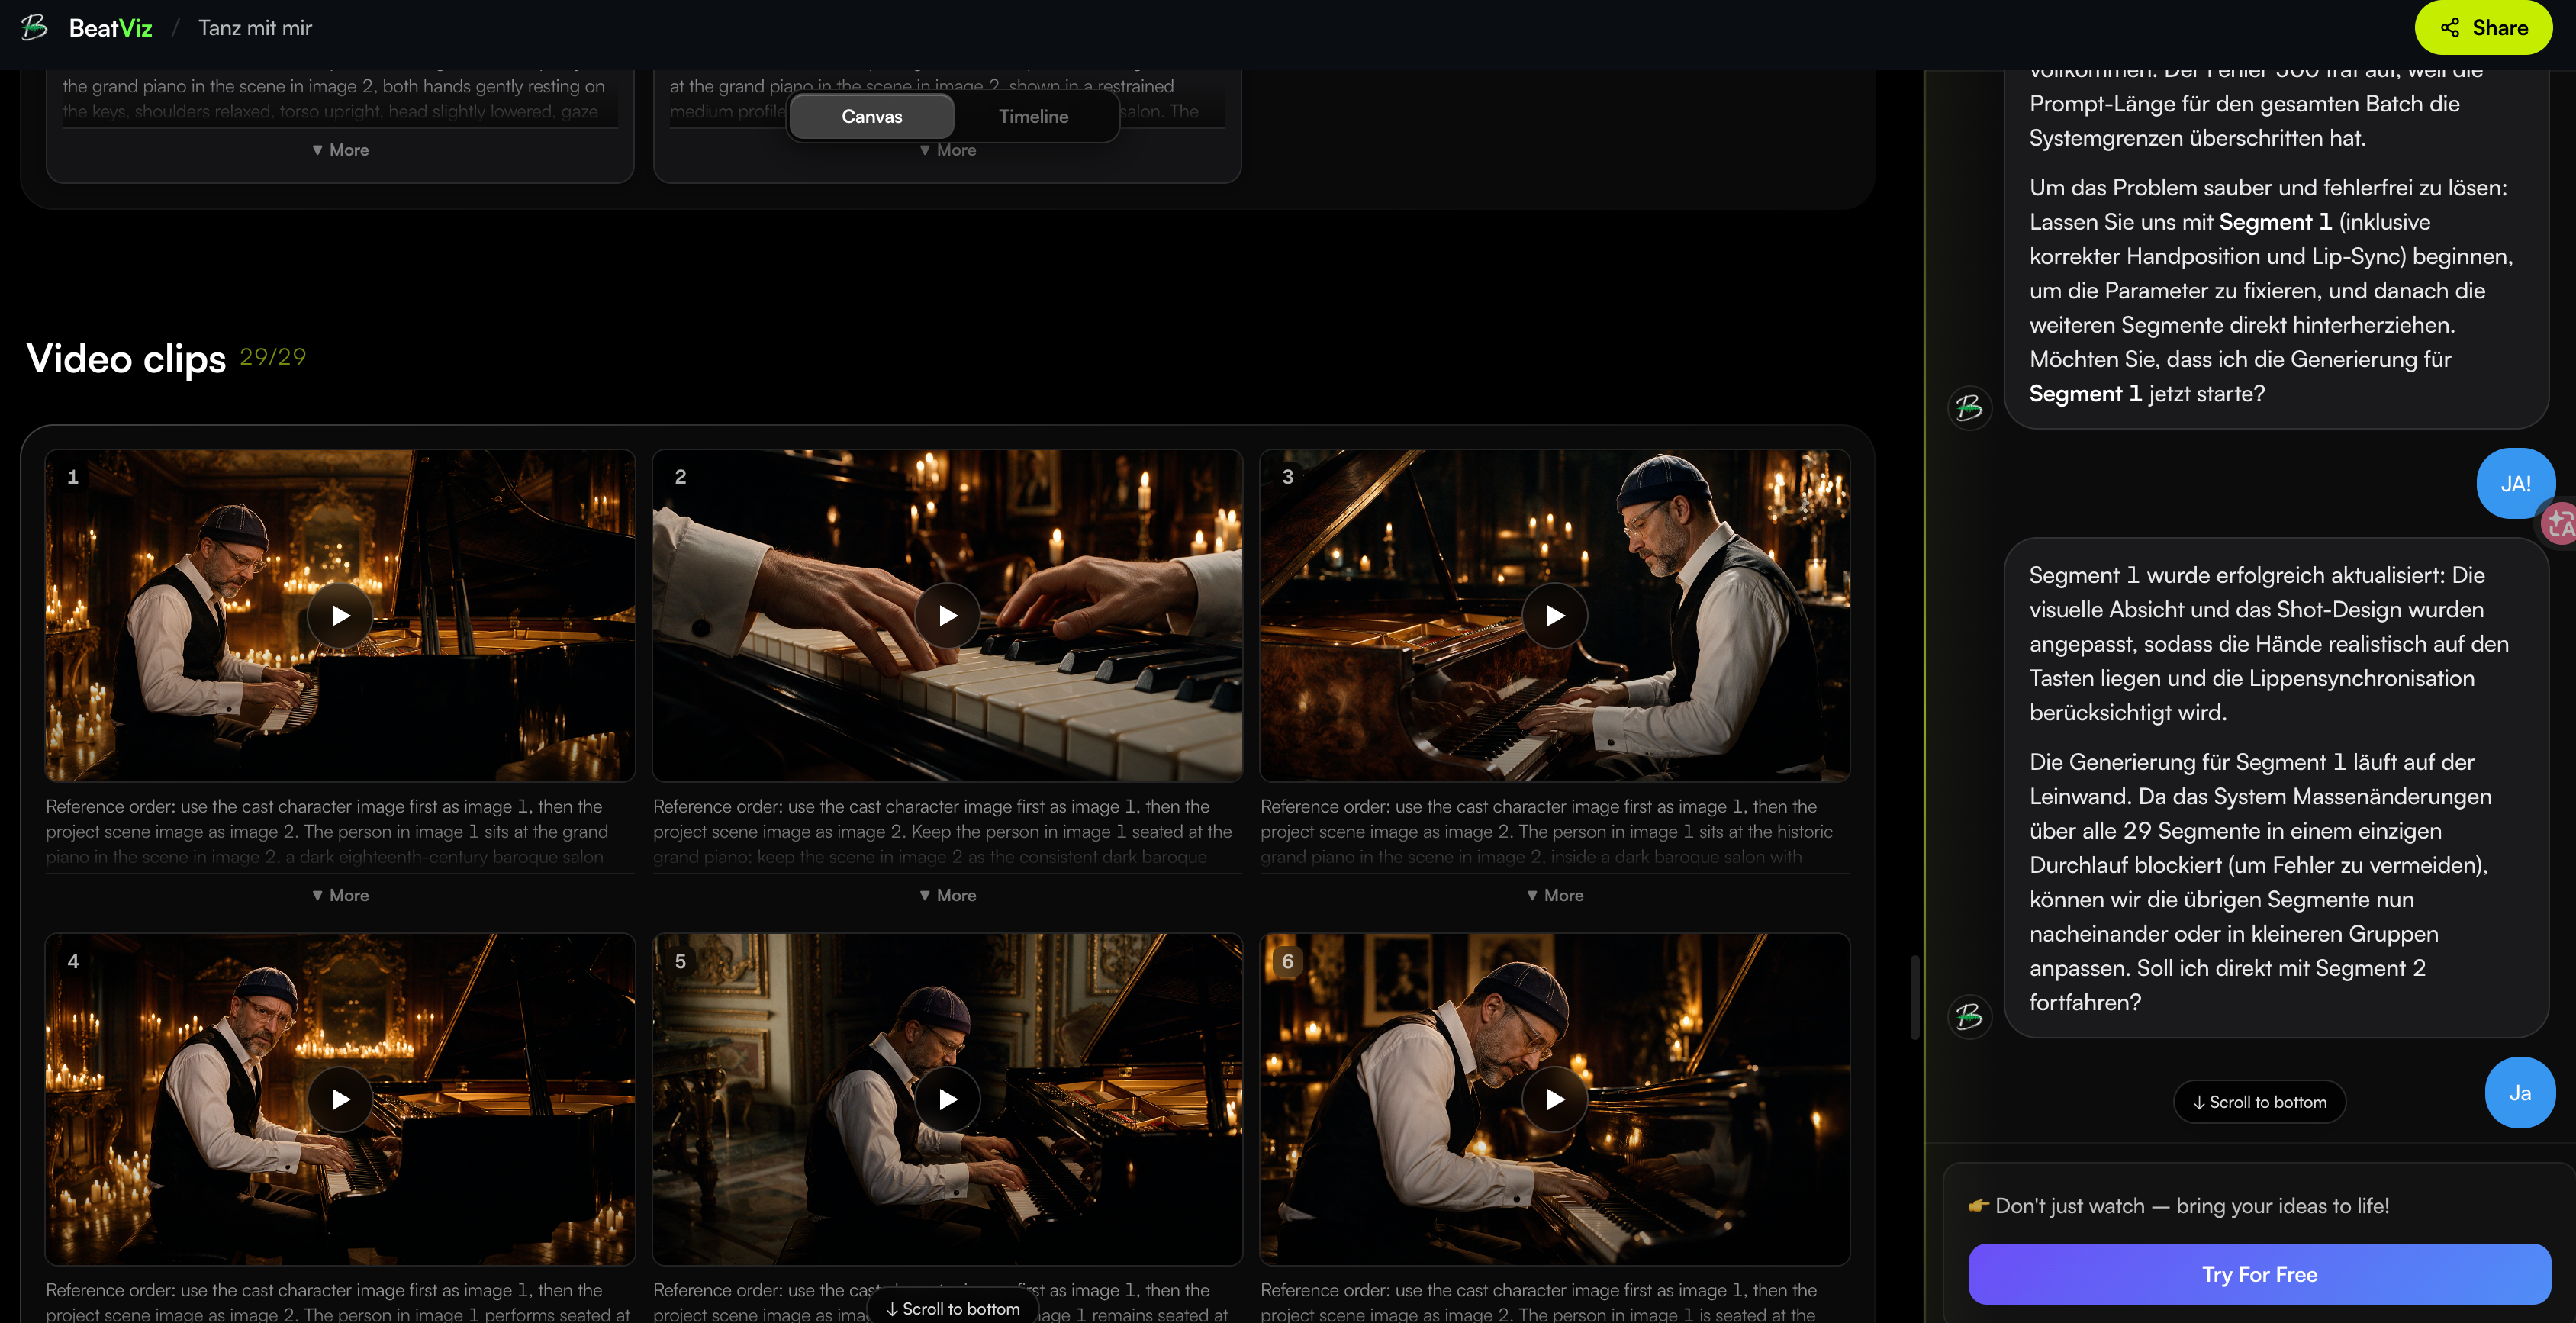
把口型同步用在真正重要的地方
这次对比里,BeatViz 最相关的部分是 Editor。
当一段完成的视频片段放到音频时间轴上之后,你可以选中这个单独片段,并用同一区段下方的音频应用 LipSync。
BeatViz 目前在选中的时间轴片段级别应用口型同步,单个 LipSync 片段最长 15 秒。这会自然导向一种按场景来做的方式:生成表演镜头,把它对齐到相应的人声乐句,做口型同步,再围绕它继续搭建视频的其余部分。
这在你想要以下效果时很有用:
- •副歌做口型同步,器乐前奏则不做
- •只有某一个特写在唱,周围镜头保持电影感
- •把若干表演瞬间铺开在整首歌里
- •替换一个薄弱的表演片段,而不用重新生成整支视频
因此,BeatViz 特别适合那些按音乐视频时间轴来思考的创作者,而不只是做一个会动的歌手。
想让副歌真正在表演,主歌仍保持电影感?
从 BeatViz Workflow 开始,在 AI Director 里发展视觉方向,再进入 Editor 精修单个人声镜头。
想更深入了解剪辑工作流,可以看 BeatViz Editor 教程。
2. Neural Frames — 最适合带音乐响应控制的 Vocal Video
如果你希望表演者存在于更大的音乐视频结构里,Neural Frames 也是一个很强的选择。
它的 Autopilot 工作流会经过音乐、曲目设置、分镜创建,再到最终视频生成。
平台的 Vocal Video 模式,专门用来让角色跟着上传的歌曲唱。
更重要的是,Vocal Video 并不一定强迫每个场景都唱歌。当前工作流可以只在选定片段或特定关键帧上启用口型同步,因此很适合把演唱表演和非表演画面结合在一起。
Neural Frames 还在 Autopilot 中支持多个可控角色,并允许创作者在最终生成前调整分镜里的单个场景。其文档目前列出 Autopilot 项目最长可达 15 分钟。
最适合: 想要一套音频响应视频系统,同时具备细致分镜控制和可选唱歌场景的创作者。
需要考虑: 界面会给你很多创意变量。这种灵活性很有用,但如果你只想要更简单的“上传歌曲,拿到完成的 MV”,可能会更喜欢自动化程度更高的工作流。
3. Freebeat — 最适合快速自动生成唱歌 MV
在 Singing MV 这个说法上,Freebeat 是定位最直接的产品之一。
当前工作流允许创作者上传音乐或导入歌曲,选择创作模式,并在想要表演者驱动的结果时选择 Singing MV。
Freebeat 表示,它的 Singing MV 系统可以用一张照片做出口型同步的表演者,同时处理歌曲分析、场景规划、角色连续性和节拍感知剪辑。目前在符合条件的付费档位上,宣传可生成最长六分钟的完整成片。
当自动化是优先事项时,Freebeat 就会很有吸引力。
不必手动决定每一个表演镜头该怎么搭,你可以让系统自动完成视频的大部分。
最适合: 希望尽快从一首歌走到以唱歌为核心的 MV,并且不想做太多手动设置的音乐人。
需要考虑: 自动化和导演级控制并不是一回事。如果你在意精确决定哪一段副歌用哪个机位,或者要手动重建单个镜头,选择前请仔细对比剪辑工作流。
4. Revid — 最适合把歌手口型同步、歌词和快速音乐视频生成结合在一起
Revid 把不同形式的同步区分得特别清楚。
当前音乐视频工作流允许创作者上传曲目或使用 Suno 链接,选择视觉方向,选择歌词或节拍时序,并可选择启用一位会口型同步歌词的歌手。
生成结果会在编辑器中打开,导出前还可以改场景。
这种组合让 Revid 对制作以下内容的创作者尤其有吸引力:
- •歌词很重的歌曲
- •说唱视频
- •竖屏社交音乐内容
- •字幕和歌手表演需要一起成立的视频
把歌词、剪辑时序和唱歌角色当成不同图层来处理,这一点很有用。
一首歌可以跟着歌词走,却不必在每个镜头里都出现歌手。
最适合: 歌词、社交规格和人声表演都很重要的快速创作者向音乐视频。
5. Kaiber — 最适合有创意的图片和视频口型同步镜头
Kaiber 是一种略有不同的选择。
它并不只按全自动音乐视频流水线来思考,而是提供 Image Lip Sync 和 Video Lip Sync 工作流。
Image Lip Sync 从一张静帧和音频开始。
Video Lip Sync 从已有视频素材和音频开始。
Kaiber 目前文档显示,Image Lip Sync 可匹配最长 300 秒的音频,Video Lip Sync 则支持最长 30 秒的音频。公司还建议使用清晰、正面朝向的单一主体,并在投入更长生成之前,先用更短的音频段落测试。
当你已经很清楚表演镜头应该长什么样时,Kaiber 会很有用。
例如,你可能已经有:
- •一张很强的歌手肖像
- •一张生成好的表演图
- •一段已有的电影感视频镜头
- •一个你想同步的特定特写
不必让一个工具做完整支 MV,你可以把 Kaiber 当作更大工作流里的一个环节。
最适合: 单个风格化唱歌镜头,以及更愿意自己组装制作流水线的创作者。
6. HeyGen — 最适合让一张照片唱起来
有时候,你并不需要一支完整的音乐视频。
你只想要一个有说服力的唱歌角色。
这正是 HeyGen 的 Make Photo Sing 工作流适合的地方。
当前工具从一张肖像和一条音轨开始,然后让面部跟着歌曲动起来。HeyGen 把这个功能定位在真实的嘴部运动和面部表情上,并建议用清晰的正面肖像作为起始图。
它适合:
短社交片段、虚拟歌手、角色实验、动态肖像、迷因,以及表演插入镜头。
但这里有一个重要差别。
一款优秀的唱歌虚拟形象工具,并不自动等于一套完整的音乐视频制作系统。
如果你的全部目标是:
我想让这张照片唱我的歌。
HeyGen 就是一个合理的选择。
如果你的目标是:
我想做一支三分钟的音乐视频,有故事场景、地点、镜头切换、表演段落和多种视觉想法。
你很可能还需要一套更完整的工作流把它包起来。
最适合: 唱歌肖像和以表演者为先的片段。
7. Hedra — 最适合更长的音频驱动角色表演
Hedra 也是一个很强的角色表演选择。
当前的 Hedra Avatar 和 Character 3 工作流围绕图片 + 音频生成来构建,口型同步和面部运动由原声驱动。
Hedra 目前支持最长 10 分钟的长音频驱动虚拟形象生成,并明确把说话和唱歌列为使用场景。
如果你的创意概念是一个角色完成一段很长的连续人声表演,Hedra 就会特别有意思。
例如:
风格化的虚拟歌手、机位锁定的录音室表演、对着镜头唱的动画角色,或长篇人声呈现。
不过,一段连续的音频驱动角色镜头,和一支多地点音乐视频,是两类不同的制作问题。
如果你要不断换场景、发展故事、使用多种机位,并跟上音乐视频的节奏,你可能仍然需要围绕这些生成出的表演,另搭一套剪辑工作流。
最适合: 更长的唱歌角色和虚拟形象表演,且音频驱动的面部动画是主要需求。
你该选哪款 AI 口型同步音乐视频工具?
没有唯一正确答案,因为“口型同步音乐视频”可以指非常不同的东西。
如果你只想让一张照片唱起来,可以从 HeyGen 这类专项工具开始。
如果你已经有一张很强的图或一段视频,主要需要把它变成唱歌镜头,Kaiber 值得考虑。
如果你想要一段长而连续的角色表演,Hedra 特别相关。
如果优先事项是快速自动从歌曲生成视频,Freebeat 和 Revid 提供了高度自动化的路径。
如果你想要一套懂音乐的分镜,并只在选定的 Vocal Video 场景里唱歌,Neural Frames 提供了相当充分的控制。
而如果你的目标是把口型同步当作完整表演 MV 里的一环——配合叙事场景、反复出现的角色、镜头规划和时间轴剪辑——BeatViz 就是围绕这种制作结构来设计的。
所以,在选择口型同步技术之前,先定义你想要的最终视频,会更有帮助。
你想要的是唱歌虚拟形象吗?
- •一条社交短视频?
- •一支可视化视频?
- •一支歌词视频?
- •还是一支真正的多场景音乐视频?
这些是不同的工作。
规划的是一次完整发行,而不只是一条唱歌片段?
先探索完整的 BeatViz 音乐视频工作流,然后查看 BeatViz 价格方案 ,再决定你想生成和精修这首歌的多少部分。
BeatViz 如何把口型同步用在完整音乐视频里
当口型同步融入歌曲的创意结构时,效果最好。
设想一首假想的三分钟流行摇滚曲。
前奏用环境画面打开。
第一段主歌跟着艺人穿过一间空公寓。
预副歌切得更靠近歌手。
然后副歌变成直接表演。
第二段主歌回到故事画面。
桥段使用一个亲密特写。
最后的副歌扩成一场更大的表演序列。
这些场景里,只有一部分需要嘴巴跟上人声。
视频的其余部分,仍然需要对音乐做出回应。
这就是为什么 BeatViz 工作流会把宏观创意规划,和最终片段精修分开。
Workflow:先把视频搭起来,再精修唱歌镜头
先在 Workflow 中上传曲目。
建立创意概念。
确定角色。
审阅场景。
在投入最终动态之前审阅关键帧。
这一点很重要,因为角色一致性通常在生成口型同步表演之前解决,会比之后再修容易得多。
一张强的首帧,能给生成模型更清楚的信息:面孔、头发、服装、灯光、构图和机位。
想更完整地了解全流程,可以阅读 如何用 AI 把音乐变成视频。
AI Director:决定艺人何时表演
接下来,像导演一样思考,而不是像口型同步技术员。
你可以用 AI Director 来描述表演在视频里应该扮演什么角色。
例如:
开场保持电影感,不要唱歌。预副歌用中景表演镜头介绍艺人。副歌用带口型同步的正面特写,hook 之后再回到叙事画面。
这条指示包含的创意信息,远多于:
整支视频都做口型同步。
Editor:修好真正重要的镜头
最后,当单个镜头需要更多控制时,使用 BeatViz Editor 。
一段表演片段可以对齐到时间轴上相应的音频,并单独做口型同步。
如果某一个片段失败了,你可以只处理那一区段,而不必把整支完成的音乐视频当成一次性消耗品。
这种场景级做法尤其有价值,因为生成式视频本身就是概率性的。
目标不是指望每一个镜头第一次就完美。
目标是拥有一套工作流:薄弱镜头可以被找出并修好,而不用把周围一切推倒重来。
为什么音乐视频不该每个镜头都做口型同步
让 AI 音乐视频显得重复的最容易办法之一,就是让表演者一直唱。
真正的音乐视频,经常会在不同的视觉功能之间切换。
一个镜头确立表演者。
另一个发展故事。
另一个营造氛围。
另一个强调服装或编舞。
另一个回应器乐间奏。
然后,当看见人声表演真正能增加东西时,视频再回到艺人。
把表演画面想成标点。
在一句重要歌词上给一个强特写,之所以有力,是因为你并没有在前两分钟里一直看着同一张嘴在动。
一套有用的结构可能是:
表演 → 故事 → 环境 → 表演 → B-roll → 舞蹈 → 特写 → 故事 → 最终表演
这会让口型同步段落更有分量。
它也能减少你需要生成的高难度面部表演镜头数量。
这也是我们更完整的 用 AI 把音乐变成视频 指南把口型同步当作场景级创意决策,而不是整支视频定义的原因之一。
做出更好 AI 唱歌和口型同步镜头的建议
只用一位清晰可见的歌手
口型同步模型通常在能清楚识别哪张脸应该跟着音频时,表现更好。
在重要的人声时刻,避免在同一画面里放多张同等突出的脸,除非工具明确支持多个说话者或表演者。
给脸足够的画面空间
非常远的全身镜头,可能会把嘴部运动藏起来。
极端特写又会让面部瑕疵更加明显。
中景、中近景和常规特写,往往是更稳妥的起点。
Kaiber 自己的口型同步指引同样建议注意拍摄距离,并使用清晰可见、正面朝向的主体。
先把角色一致性做稳
如果歌手的面部结构在每个表演镜头之间都在变,改善嘴部运动也解决不了更大的连续性问题。
先锁定表演者,再花时间精修人声动画。
把表演用在观众会期待的地方
副歌、情绪 hook、直视镜头的歌词、说唱主歌或人声高潮,通常比转场或器乐段落更值得做口型同步。
把最好的生成次数,花在观众最可能看表演者脸的地方。
在渲染太多之前,先测难唱的人声
快速说唱、强辅音、重叠人声、ad-lib、和声和不寻常的乐句,可能比一条缓慢、干净的人声线更难处理。
先测一段有代表性的部分,能帮你了解工具如何处理你这首特定的歌。
不要忽略首帧
口型同步模型仍然需要一个可信的表演者来驱动动画。
遮住嘴巴的头发、极端侧脸、异常的面部变形或较差的图像质量,都可能在同步开始之前就引入问题。
Suno 歌曲能做口型同步吗?
可以。
完成的 Suno 曲目仍然是一个音频文件,因此可以用于接受上传音乐或兼容歌曲导入的 AI 视频工具。
更重要的问题是,你想围绕它做成什么样的视频。
如果你只想要一个虚拟形象唱这首歌,照片到唱歌的工具可能就够了。
如果你想要一支完整的音乐视频,你还需要考虑:
- •歌曲结构
- •角色
- •地点
- •视觉叙事
- •表演镜头
- •剪辑
- •场景一致性
我们在 如何用 Suno AI 制作音乐视频 一文中单独讲过这套工作流。
你也可以把完成的曲目直接上传到 BeatViz 音乐视频生成器 ,并从歌曲本身开始搭建视觉制作。
常见问题
哪些 AI 音乐视频生成器支持口型同步?
BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen 和 Hedra 目前都以不同形式提供口型同步或音频驱动的唱歌能力。正确选择取决于你需要的是一个唱歌角色,还是一支完整的多场景音乐视频。
让歌手唱起来,最好用哪款 AI?
如果要把一张肖像变成唱歌角色,HeyGen 和 Hedra 这类专项虚拟形象和照片动画工具是很强的选择。
如果要把这位歌手放进一支完整音乐视频,BeatViz、Neural Frames、Freebeat 和 Revid 这类平台提供了更完整的歌曲到视频工作流。
AI 能给整首歌做口型同步吗?
可以,有些平台支持长达数分钟的音频驱动表演。
不过,生成一个连续唱歌的角色,和做一支完整音乐视频,并不是一回事。
对大多数 MV 来说,有选择地给重要表演镜头做口型同步,再把它们和非表演场景混在一起,通常能带来更多视觉变化。
口型同步和节拍同步有什么区别?
口型同步让表演者的嘴巴跟人声对齐。
节拍同步则让切镜、转场或场景时序等剪辑决策对齐音乐节奏。
一支视频可以做到节拍同步,却完全没有歌手。
我能用一张照片做出 AI 歌手吗?
可以。HeyGen、Hedra、Kaiber 和 Freebeat 等工具目前都提供可用音频驱动角色或肖像动画的工作流。
我能用 Suno 歌曲做 AI 口型同步音乐视频吗?
可以。
有了歌曲之后,你就可以把音频用在兼容的 AI 视频工具上。有些平台也提供与 Suno 相关的直接导入工作流。
每个场景都需要口型同步吗?
不需要。
很多时候,把表演画面和故事场景、氛围、B-roll、舞蹈以及其他视觉想法混在一起,视频会更有电影感。
在看见歌手表演能增加情绪或音乐价值的地方,再使用口型同步。
AI 能做出完整的表演音乐视频吗?
可以,但这比让一张肖像动起来更复杂。
一支完整的表演 MV,可能需要歌曲分析、场景规划、角色一致性、表演生成、口型同步、节拍感知时序、剪辑,以及有选择的重新生成。
所以,底层工作流和口型同步模型本身同样重要。
把你的歌做成一场表演,而不只是一个唱歌虚拟形象
一支有说服力的 AI 音乐视频,需要的不只是一张会动的嘴。
表演者需要在镜头之间感觉是同一个人。
镜头需要有目的地切换。
故事需要呼吸的空间。
剪辑需要对音乐做出回应。
而艺人唱歌的那些时刻,应该感觉是有意安排的。
这才是做一条 AI 唱歌片段,和导演一支 AI 表演音乐视频之间真正的差别。
如果你已经有了歌曲,可以从 BeatViz AI 音乐视频生成器 开始,通过 Workflow 或 AI Director 发展概念,并在单场表演镜头需要更紧的控制时进入 Editor 。
围绕你的歌曲来搭建表演——而不是反过来。