歌唱・パフォーマンス動画向け、リップシンクに強いAIミュージックビデオジェネレーター
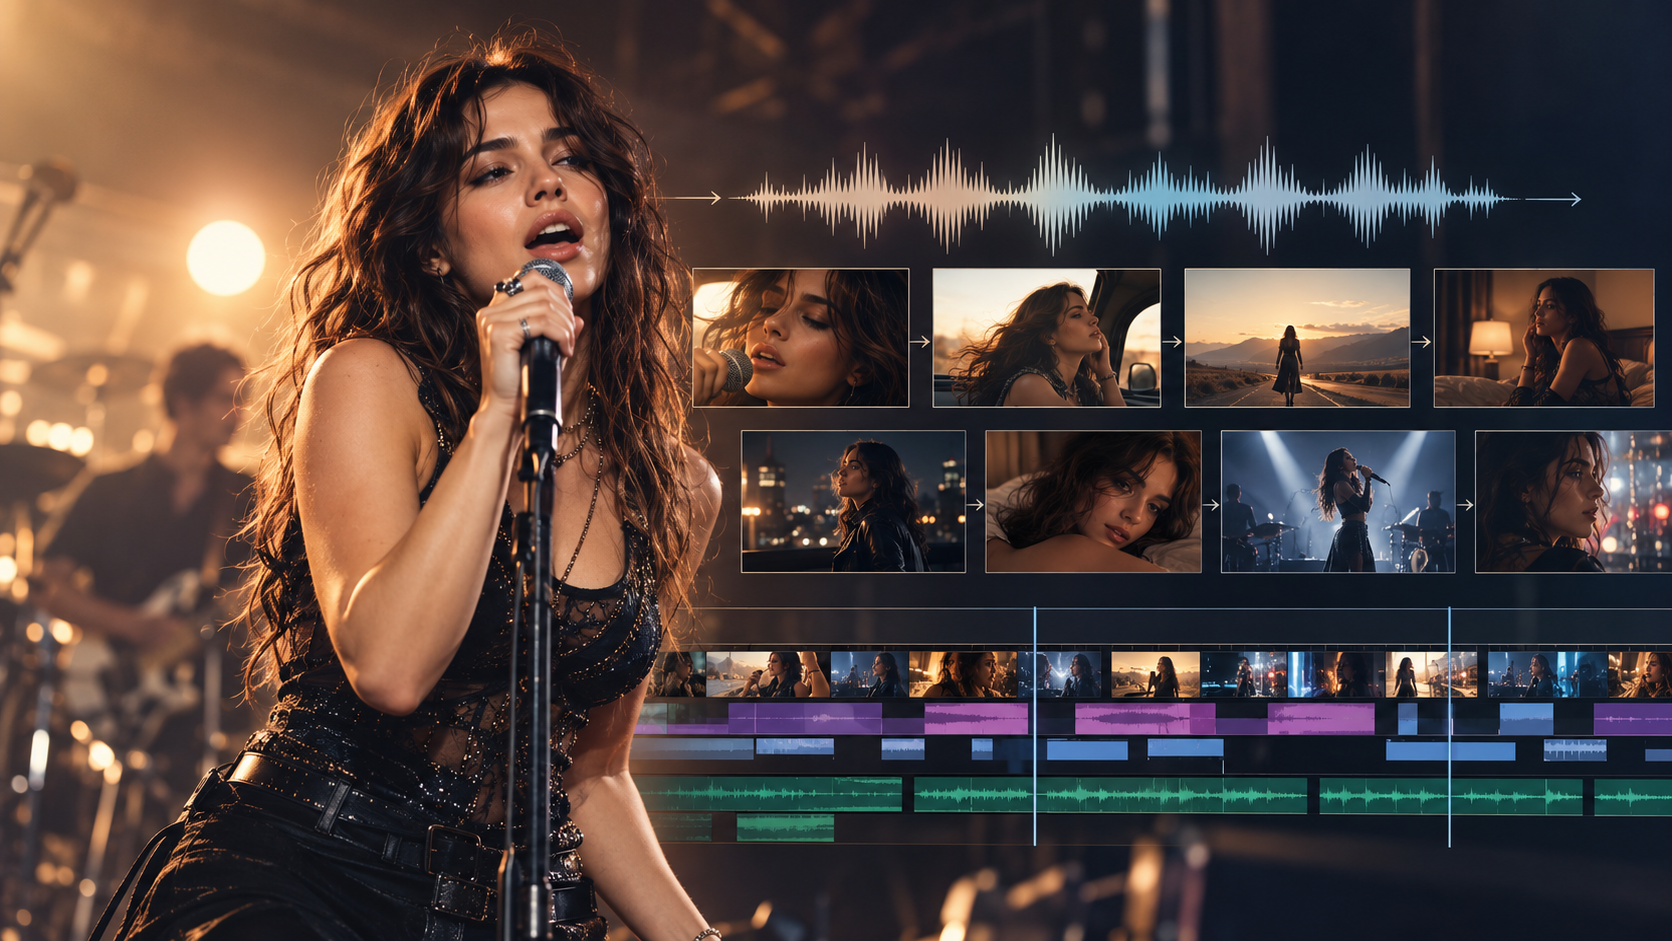
ステージに立つシンガーがいるだけでは、パフォーマンスミュージックビデオは説得力を持ちません。
難しいのは、そのパフォーマーを楽曲と本当につながって感じさせることです。
口はボーカルに沿う必要があります。表情は歌い方に合う必要があります。カメラの角度が変わっても、同じアーティストだと見分けられる必要があります。そして同じくらい重要なのが、歌っていない瞬間をビデオが知っていることです。
だから、リップシンク対応のAIミュージックビデオジェネレーターを選ぶことは、通常のAIビデオジェネレーターを選ぶこととは違います。
ポートレート1枚を歌わせるのが得意なツールもあれば、数分の音声にキャラクターを同期できるツールもあります。リップシンクと、シーン企画、キャラクターの一貫性、音楽を理解した編集、完結したマルチシーンのミュージックビデオワークフローを組み合わせられるのは、さらに少数です。
すでに完成したトラックがあり、これらの要素がどう組み合わさるかを見たいなら、 BeatViz AIミュージックビデオジェネレーター は、単発のAIクリップではなく、楽曲からビデオまでの完結した制作を軸に設計されています。
このガイドでは、歌唱動画とパフォーマンスミュージックビデオ向けの現行オプション7つ——BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen、Hedra——を比較します。
目的は、単に次を問うことではありません。
このツールは、キャラクターの口を動かせるか?
より良い問いは、次です。
このツールは、そのパフォーマンスを本物のミュージックビデオにできるか?
リップシンクに対応しているAIミュージックビデオジェネレーターは?
いくつかのAIビデオプラットフォームは、いま歌唱やボーカルのリップシンクに対応しています。
重要な違いは、そのリップシンクが制作プロセスのどこに収まるかです。
| ツール | リップシンク | フルのミュージックビデオワークフロー | 向いている用途 |
|---|---|---|---|
| BeatViz | あり(クリップ単位) | あり | シーン単位の制御がある、フルのパフォーマンスMV |
| Neural Frames | あり(Vocal Video経由) | あり | 歌唱シーンを選べる、音楽連動ビデオ |
| Freebeat | あり(Singing MVモード) | あり | 高速な自動歌唱ミュージックビデオ |
| Revid | あり | あり | 歌詞、ビートタイミング、シンガーを組み合わせた速いミュージックビデオ |
| Kaiber | あり(画像・動画のリップシンク) | 部分的/モジュール型 | クリエイティブな個別パフォーマンスクリップ |
| HeyGen | あり | パフォーマー中心 | ポートレートやアバターを歌わせる |
| Hedra | あり | キャラクター中心 | 長尺の音声駆動キャラクターパフォーマンス |
この区別が重要なのは、AIの歌唱動画と、完成したパフォーマンスミュージックビデオが、必ずしも同じものではないからです。
たとえばHeyGenはポートレートを楽曲に合わせて動かせます。Kaiberは画像や既存動画に、音声駆動のリップシンクを適用できます。BeatViz、Neural Frames、Freebeat、Revidはさらに進んで、歌唱ショットを、より広いミュージックビデオワークフローの中に置けます。
リップシンク、ビートシンク、歌詞シンクは、同じものではない
AIミュージックビデオツールがわかりにくくなる理由のひとつは、リップシンク、ビートシンク、歌詞シンクといった言葉が、同じ意味のように扱われがちなことです。
そうではありません。
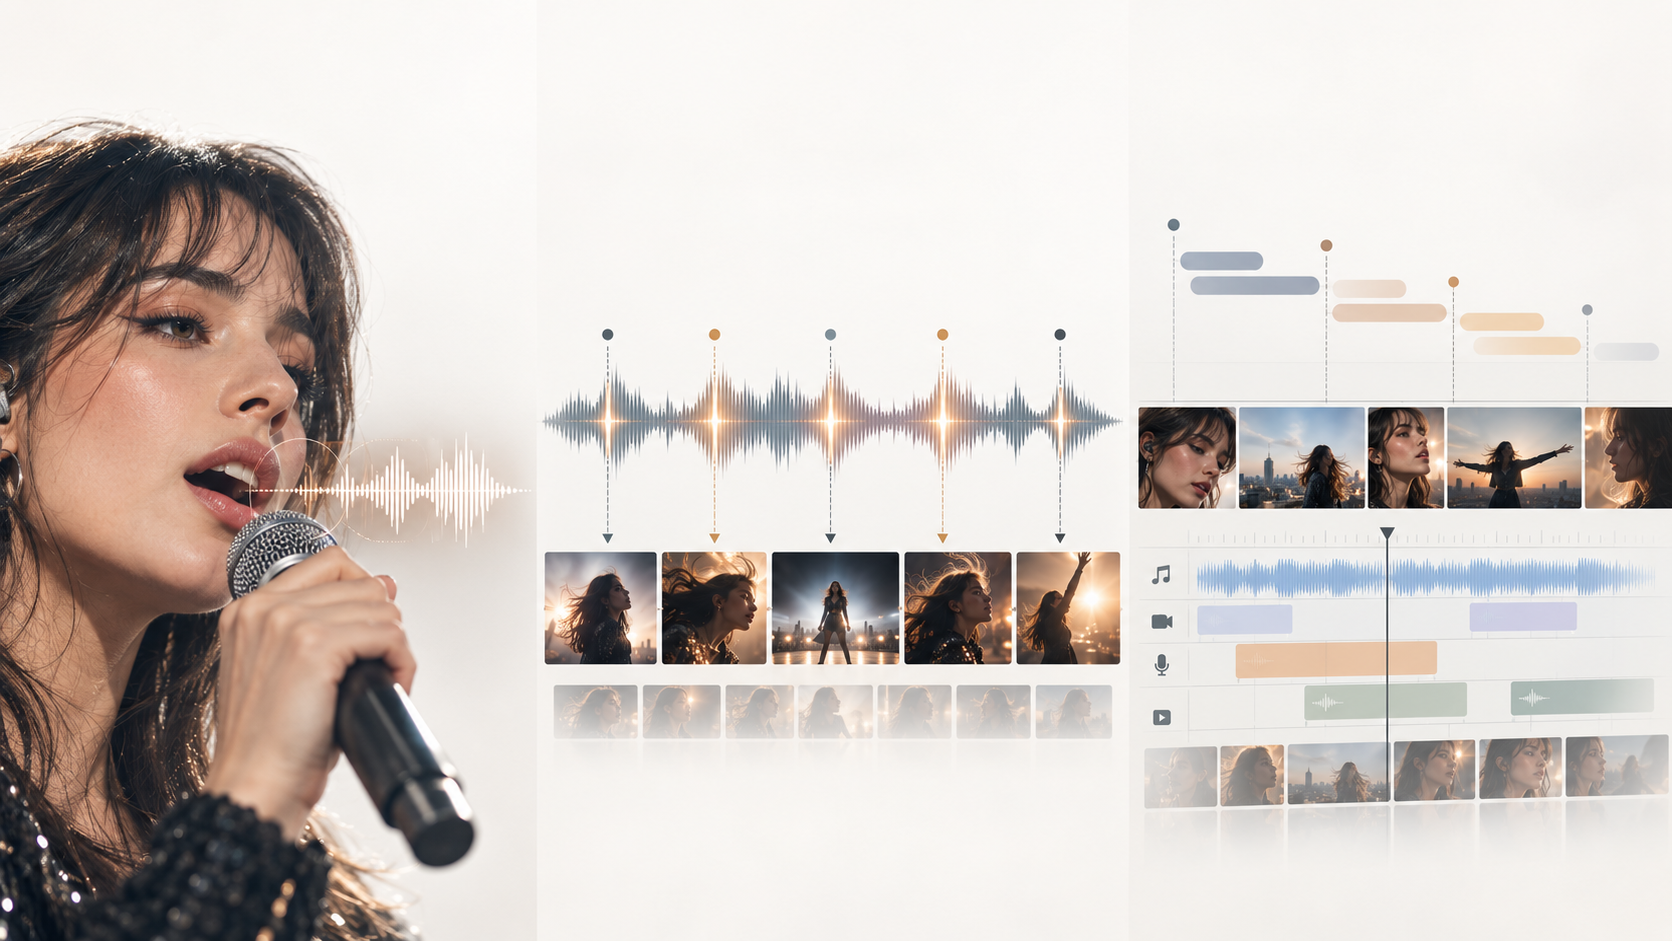
リップシンク
リップシンクは、ボーカル音声とパフォーマーの口の関係を制御します。
シンガーが閉じた口の子音で始まる単語を歌うなら、映像のパフォーマンスも、ほぼ同じタイミングでその音を反映するべきです。
しかし、説得力のある歌唱は、口の形だけではありません。
クローズアップのパフォーマンスショットは、次にも依存します。
- •表情
- •目の動き
- •頭の動き
- •呼吸とフレージング
- •体の動き
- •感情の出し方
口が技術的に同期していても、まわりが固まっていれば、まだ不自然に見えます。
ビートシンク
ビートシンクが影響するのは、シンガーの顔ではなく、編集です。
カット、トランジション、カメラの切り替え、視覚効果、シーンの長さは、音楽のリズムに沿えます。
速いコーラスでは、カットを短くできます。
遅いブリッジでは、1つのショットをより長く保てます。
ドロップで、シーン転換を起こせます。
画面に誰も写っていなくても、ビデオが音楽とつながって感じられることがあります。
歌詞シンク
歌詞シンクは、実際の歌詞に対する、言葉、字幕、ビジュアルコンセプトのタイミングに関わります。
カラオケ風のキャプションのように単純なこともあります。
特定の歌詞の意味を軸に、シーンを設計することを意味することもあります。
たとえばRevidは現行ワークフローで、歌詞のタイミング、ビートのタイミング、任意のシンガーリップシンクを分けています。
いちばん強いパフォーマンスビデオは、しばしば3つすべてを使います。
リップシンクはパフォーマーを制御します。ビートシンクは編集を制御します。歌詞シンクは、ビジュアルを楽曲が伝えていることへつなぎます。
リップシンク対応のAIミュージックビデオジェネレーターを、どう比較したか
これは、同じシンガー、楽曲、シード、プロンプト、GPU条件をすべてのプラットフォームで試した、管理された実験室ベンチマークではありません。
代わりに、各製品の現行の公開ワークフローと、ミュージシャンが選ぶときに実際に問う実践的な問いを軸に比較します。
- •リップシンクはどう適用されるか?
- •どのシーンで歌うかを決められるか?
- •同じパフォーマーを、複数のショットに登場させられるか?
- •短いクリップ1本ではなく、楽曲全体を扱えるか?
- •悪いパフォーマンスショットを、すべて作り直さずに差し替えられるか?
- •そのプラットフォームは音楽構成を理解しているか、それとも音声ファイルから顔を動かしているだけか?
フルのパフォーマンスMVでは、リップシンクがあるかないかのチェックボックスより、これらの違いのほうが重要です。
リップシンクに強いAIミュージックビデオジェネレーター7選
1. BeatViz — フルのパフォーマンスミュージックビデオにリップシンクを組み込むのに最適
BeatVizは、リップシンクを、より大きなミュージックビデオ制作ワークフローの一部として扱います。
顔から始めて、トラック全体を歌わせるのではなく、音楽そのものから始められます。
現行プラットフォームには、つながった3つのアプローチがあります。
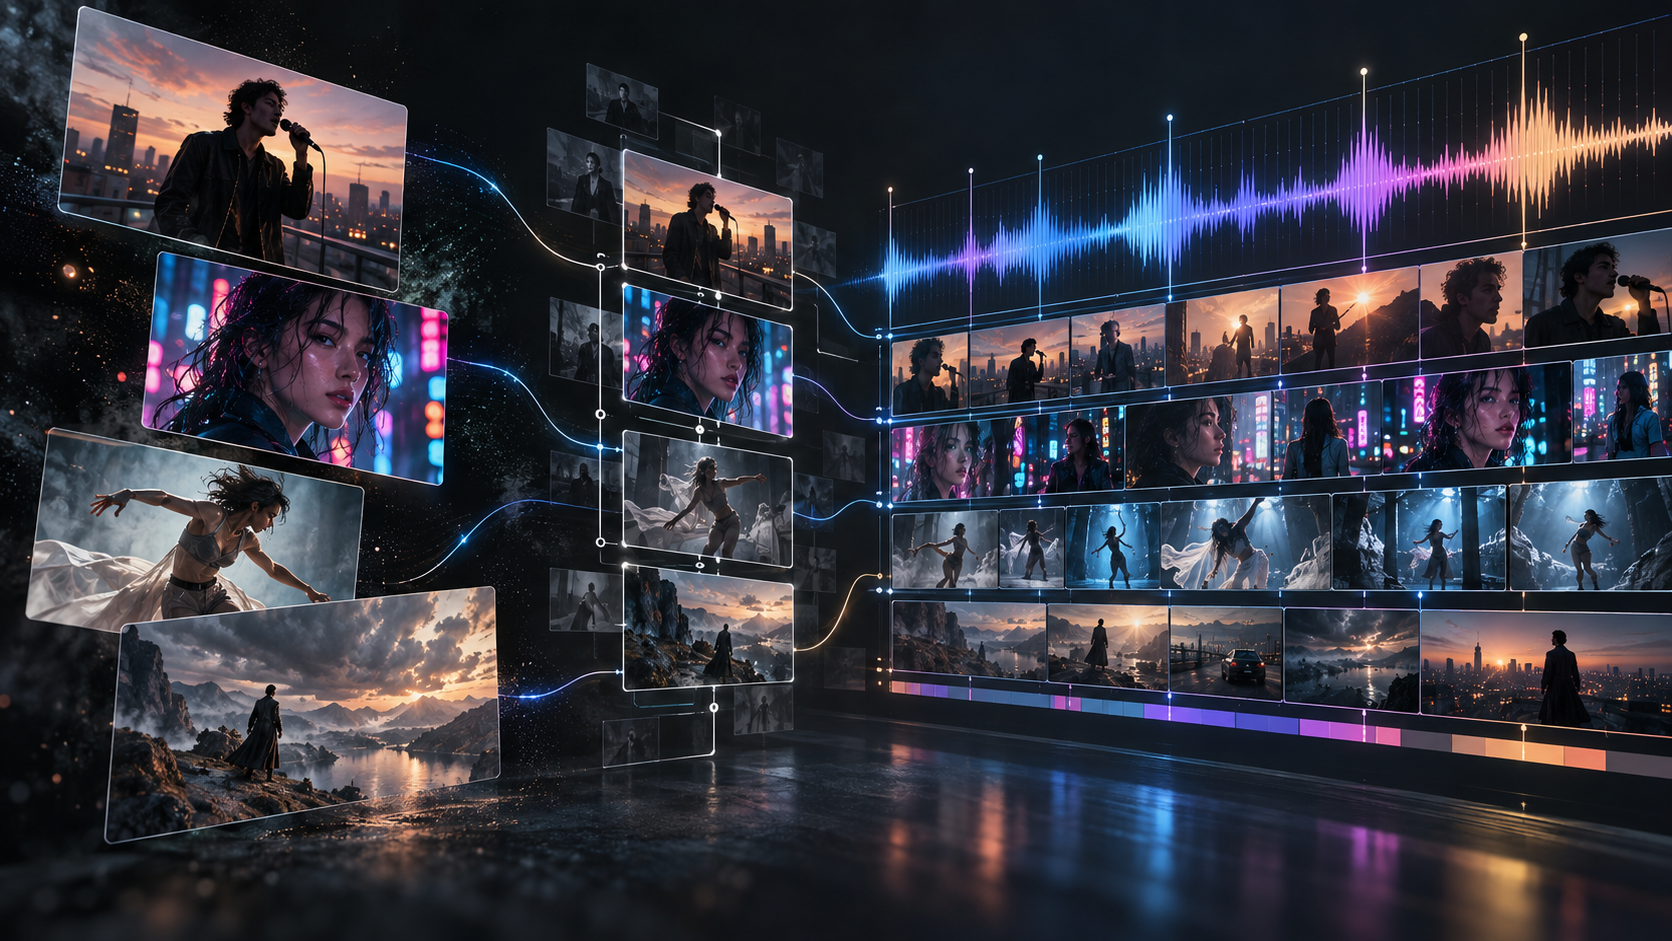
- •完成ビデオをステップごとに組み立てるWorkflow。
- •会話を通じてミュージックビデオを育てるAI Director。
- •タイムラインとクリップ単位を直接制御するEditor。
この区別は、パフォーマンスビデオで特に役立ちます。
3分の楽曲に、3分ずっと続くリップシンクが必要なことは、ほとんどありません。
最初のコーラスではクローズアップのパフォーマンス、ヴァース2では物語の映像、ブリッジでシンガーに戻り、最後はより大きなパフォーマンスシーケンス、という使い方ができます。
つまりリップシンクは、全体にかかる効果よりも、演出の判断として使ったほうがうまくいきます。
口ではなく、パフォーマーから始める
良いリップシンクは、リップシンクの段階より前に始まります。
ショットごとにアーティストのアイデンティティが変われば、口が完璧に同期していても、ビデオは救えません。
BeatViz Workflowでは、最終的なビデオ生成の前に、楽曲、ビジュアル方向性、キャラクター、シーン、ショット、ファーストフレームを固められます。
パフォーマーを、カメラが切れるたびに新しい人物として作るのではなく、繰り返し登場するキャラクターとして扱いやすくなります。
キャラクターの継続性がいちばんの課題なら、別ガイドの キャラクターの一貫性に強いAIミュージックビデオジェネレーターをご覧ください。

AI Directorで、パフォーマンスを演出する
パフォーマンスMVには、クリエイティブな判断も必要です。
たとえば、こうです。
最初のヴァースはシネマティックで物語寄りに。コーラスではカメラ目線のパフォーマンスショットを使う。最後のフックでは、クローズアップのパフォーマンスに戻る。
そうした演出は、 BeatViz AI Directorを通じて育てられます。すべてのクリエイティブ判断を、別々の生成プロンプトに手動で訳す必要はありません。
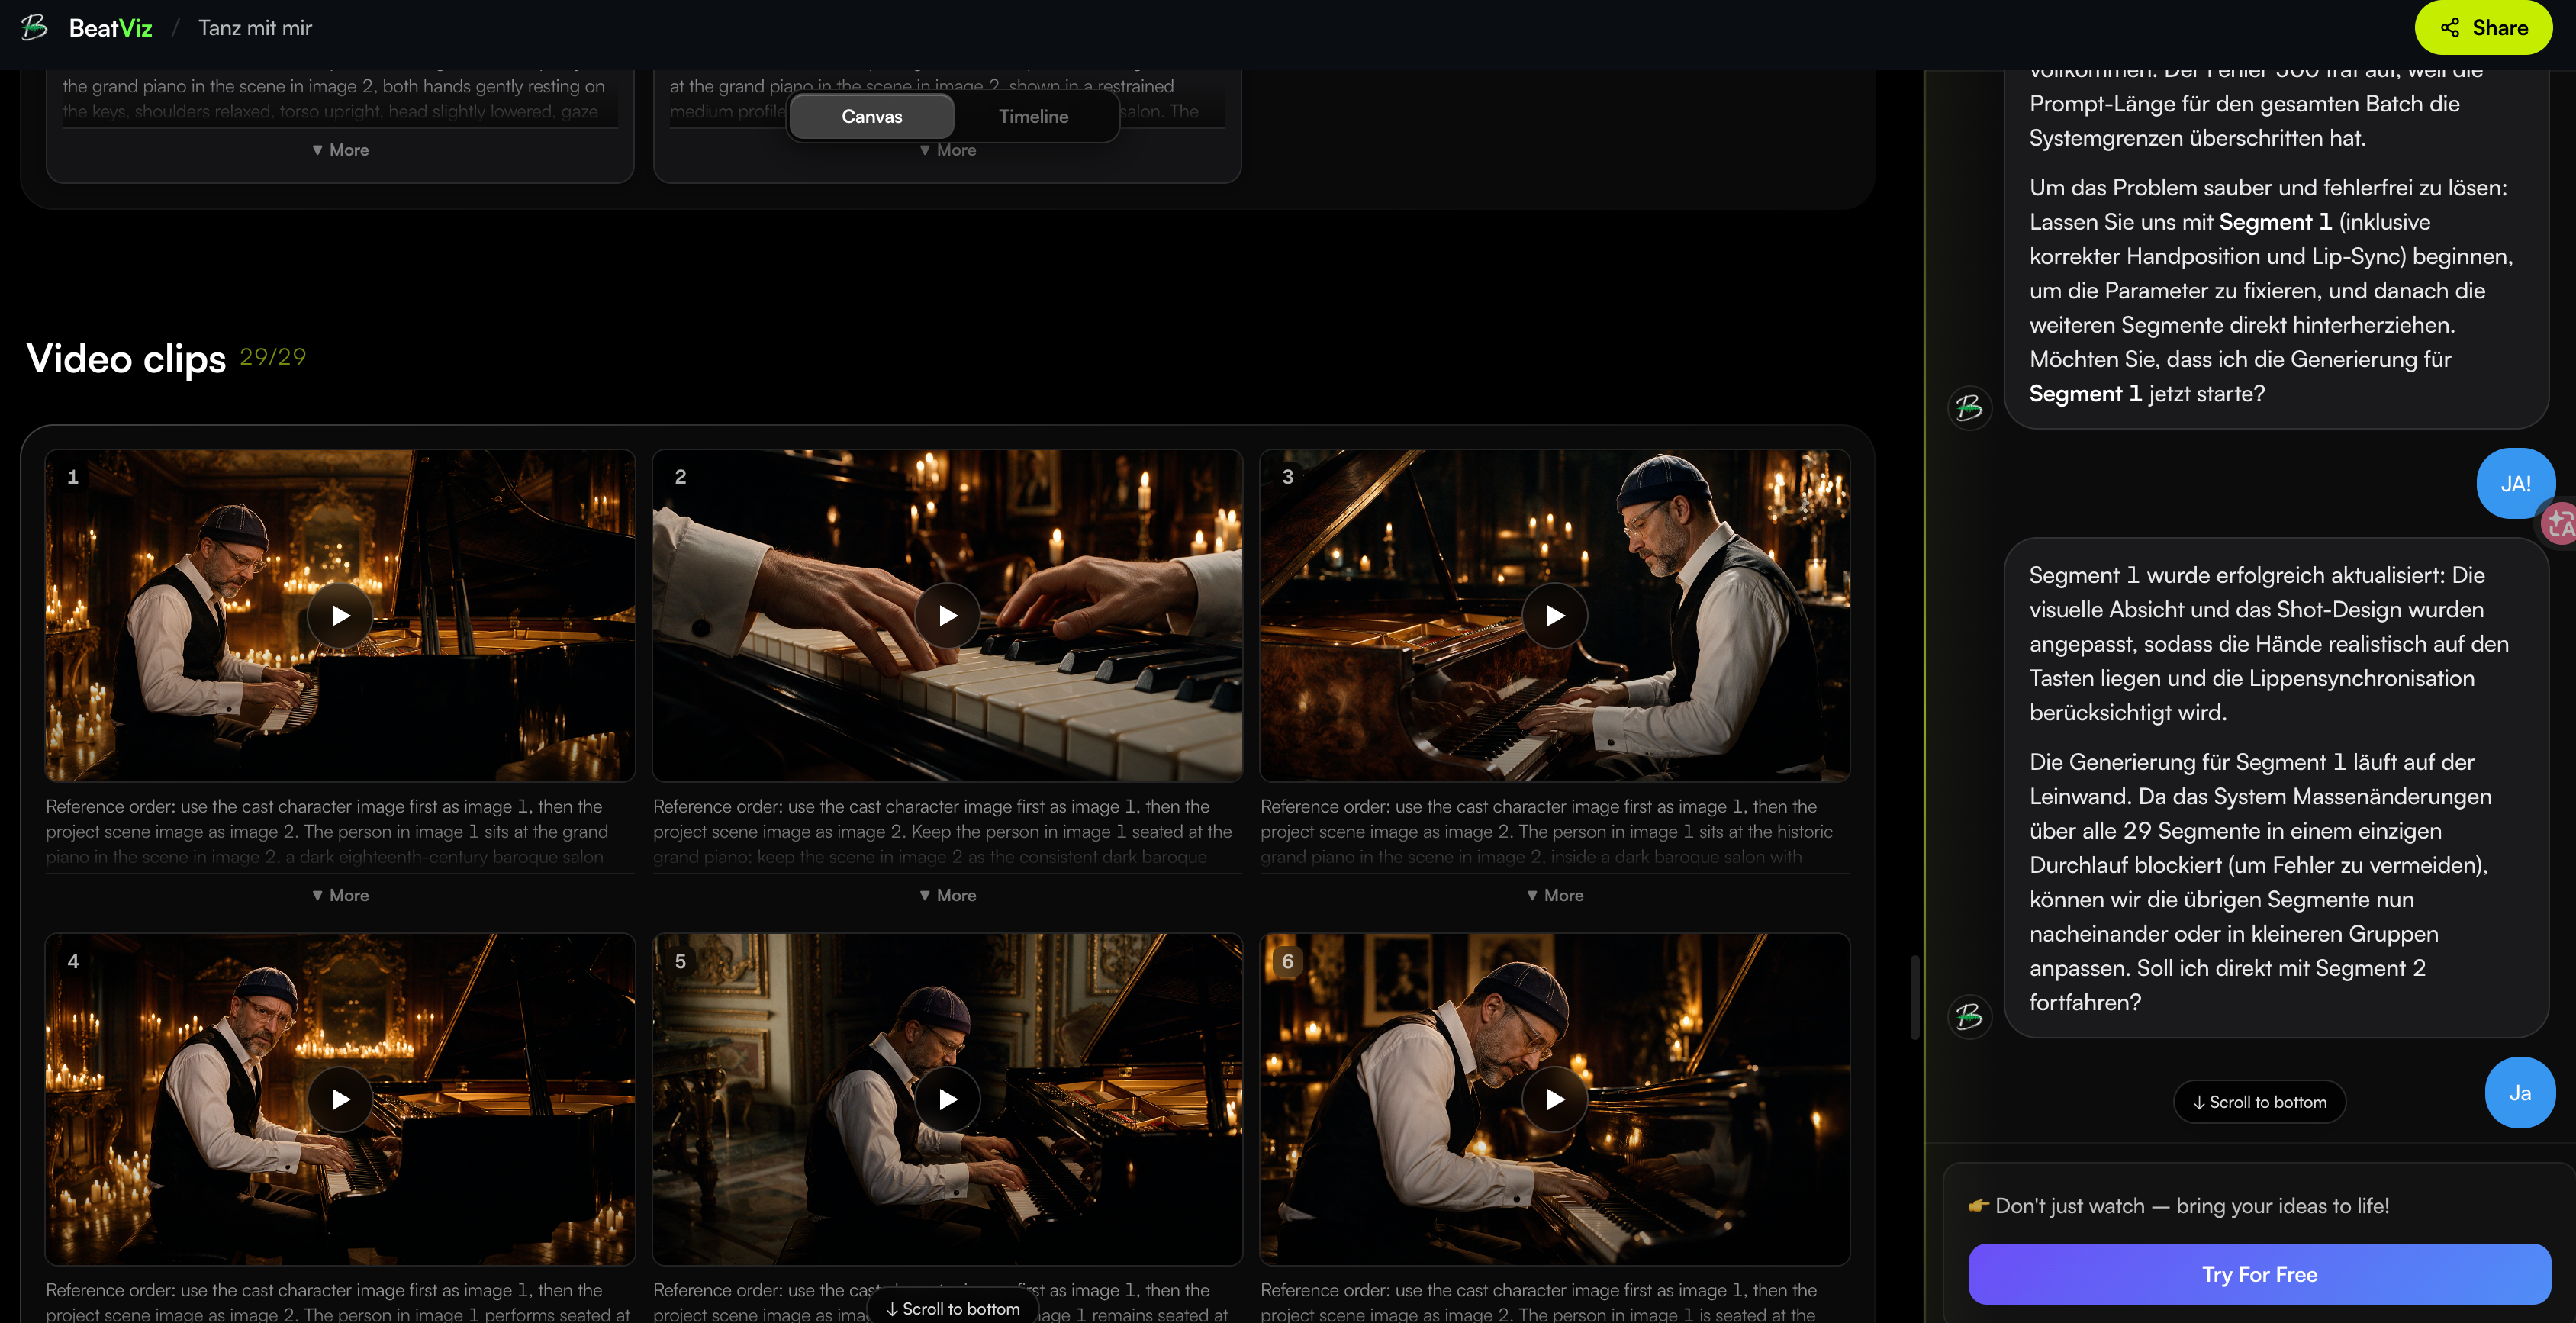
本当に必要なところへ、リップシンクを適用する
この比較でもっとも重要なBeatVizの部分は、 Editorです。
完成したビデオクリップを音声タイムラインに置いたら、そのクリップを選び、同じ区間の下にある音声を使ってLipSyncを適用できます。
BeatVizは現在、選択したタイムラインクリップ単位でリップシンクを適用し、個別のリップシンククリップは15秒までです。そのため自然と、シーン単位の進め方になります。パフォーマンスショットを生成し、該当するボーカルフレーズに合わせ、リップシンクし、そのまわりに残りのビデオを組み立てていく、という流れです。
次のようなときに役立ちます。
- •コーラスではリップシンクし、インストゥルメンタルのイントロではしない
- •特定のクローズアップだけを歌わせ、まわりのショットはシネマティックなままにする
- •1曲全体に、いくつかのパフォーマンスの瞬間を散らす
- •弱いパフォーマンスクリップ1本だけを差し替え、ビデオ全体は再生成しない
だからBeatVizは、動かされたシンガーだけでなく、ミュージックビデオのタイムラインとして考えるクリエイターに特に向いています。
コーラスはパフォーマンス、ヴァースはシネマティックのままにしたいですか?
まず BeatViz Workflowから始め、 AI Directorでビジュアル方向性を育て、 Editorで個別のボーカルショットを磨き込みましょう。
編集ワークフローの詳しい手順は、 BeatViz Editorチュートリアルをご覧ください。
2. Neural Frames — 音楽連動の制御があるVocal Videoに最適
パフォーマーを、より大きなミュージックビデオの構造の中に置きたいとき、Neural Framesも有力な選択肢です。
Autopilotワークフローは、音楽、トラック設定、ストーリーボード作成、最終ビデオ生成へと進みます。
プラットフォームのVocal Videoモードは、アップロードした楽曲に合わせてキャラクターが歌えるように設計されています。
さらに重要なのは、Vocal Videoが、すべてのシーンで歌わせるわけではないことです。現行ワークフローでは、選んだクリップや特定のキーフレームでリップシンクを有効にできるため、ボーカルパフォーマンスと、パフォーマンス以外の映像を組み合わせやすいです。
Neural FramesはAutopilotで、制御できるキャラクターを複数扱え、最終生成の前にストーリーボードの個別シーンを調整できます。現行のドキュメントでは、Autopilotプロジェクトは最大15分とされています。
こんな方におすすめ: 詳細なストーリーボード制御と、歌唱シーンを選べるオーディオリアクティブなビデオシステムが欲しいクリエイター。
検討しておきたい点: インターフェースには、クリエイティブな変数が多くあります。その柔軟さは役立ちますが、「曲をアップロードして完成MVを得る」という、より簡単な体験が欲しい人は、より自動化されたワークフローの方が合うことがあります。
3. Freebeat — 高速な自動歌唱MVに最適
Freebeatは、Singing MVという言い方に、いちばん直接的に位置づけられた製品のひとつです。
現行ワークフローでは、音楽をアップロードするか楽曲を取り込み、制作モードを選び、パフォーマー中心の結果が欲しいときにSinging MVを選べます。
Freebeatによると、Singing MVシステムは写真からリップシンクのパフォーマーを作れるほか、楽曲分析、シーン企画、キャラクターの継続性、ビートを意識した編集も扱えます。現行では、対象の有料プランで最大6分のフル尺生成を案内しています。
自動化が優先なら、Freebeatは魅力的です。
すべてのパフォーマンスショットを、どう組み立てるかを手動で決める代わりに、ビデオの多くをシステムに自動で作らせられます。
こんな方におすすめ: 手動の準備をあまりせず、楽曲から歌唱中心のMVへすばやく進みたいミュージシャン。
検討しておきたい点: 自動化と、演出のコントロールは同じではありません。どのコーラスにどのカメラアングルを入れるかを正確に決めたい、個別ショットを手動で作り直したい、という場合は、選ぶ前に編集ワークフローをよく比較してください。
4. Revid — シンガーのリップシンク、歌詞、速いミュージックビデオ生成の組み合わせに最適
Revidは、同期の種類の違いを特にはっきり示します。
現行のミュージックビデオワークフローでは、トラックをアップロードするかSunoリンクを使い、ビジュアル方向性を選び、歌詞またはビートのタイミングを選び、歌詞にリップシンクするシンガーを任意で有効にできます。
生成結果はエディターで開き、書き出し前にシーンを変更できます。
この組み合わせは、次を作るクリエイターにとって特に興味深いです。
- •歌詞の比重が大きい楽曲
- •ラップ動画
- •縦型のソーシャル音楽コンテンツ
- •キャプションとシンガーのパフォーマンスを同時に活かしたいビデオ
歌詞、編集のタイミング、歌うキャラクターを別のレイヤーとして扱えるのは役立ちます。
すべてのショットにシンガーを出さなくても、楽曲は歌詞に沿えます。
こんな方におすすめ: 歌詞、ソーシャル向けフォーマット、ボーカルパフォーマンスがすべて重要な、速いクリエイター向けミュージックビデオ。
5. Kaiber — クリエイティブな画像・動画のリップシンクショットに最適
Kaiberは、少し違う種類の選択肢です。
完全自動のミュージックビデオパイプラインだけを考えるのではなく、KaiberはImage Lip SyncとVideo Lip Syncのワークフローを提供しています。
Image Lip Syncは、静止画と音声から始まります。
Video Lip Syncは、既存のビデオ映像と音声から始まります。
Kaiberの現行ドキュメントでは、Image Lip Syncは最大300秒の音声に合わせられ、Video Lip Syncは最大30秒の音声に対応します。また、はっきり前を向いた被写体1人を使い、長い生成に進む前に短い音声区間で試すことを推奨しています。
パフォーマンスショットがどう見えるべきかを、すでに正確にわかっているときに、Kaiberは役立ちます。
たとえば、すでに次がある場合です。
- •強いシンガーのポートレート
- •生成済みのパフォーマンス画像
- •既存のシネマティックなビデオショット
- •同期させたい特定のクローズアップ
1つのツールにMV全体を作らせるのではなく、より大きなワークフローの1段階としてKaiberを使えます。
こんな方におすすめ: 個別のスタイリッシュな歌唱ショットと、自分で制作パイプラインを組みたいクリエイター。
6. HeyGen — 写真を歌わせるのに最適
完成したミュージックビデオが、いつも必要なわけではありません。
説得力のある歌うキャラクターが欲しいだけのこともあります。
そこに合うのが、HeyGenのMake Photo Singワークフローです。
現行ツールはポートレートと音声トラックから始まり、顔を楽曲に合わせて動かします。HeyGenはこの機能を、リアルな口の動きと表情を軸に位置づけ、開始画像にははっきり前を向いたポートレートを推奨しています。
次に役立ちます。
短いソーシャルクリップ、バーチャルシンガー、キャラクター実験、動くポートレート、ミーム、パフォーマンスの挿入。
しかし、重要な区別があります。
優れた歌うアバターのツールが、そのままフルのミュージックビデオ制作システムになるわけではありません。
目標全体が次なら、
この写真に、自分のトラックを歌わせたい。
HeyGenは妥当な選択肢です。
目標が次なら、
物語のシーン、ロケーション、カメラの切り替え、パフォーマンス区間、複数のビジュアルアイデアがある、3分のミュージックビデオが欲しい。
そのまわりに、より広いワークフローが必要になるでしょう。
こんな方におすすめ: 歌うポートレートと、パフォーマー起点のクリップ。
7. Hedra — 長尺の音声駆動キャラクターパフォーマンスに最適
Hedraも、キャラクターパフォーマンスに強い選択肢です。
現行のHedra AvatarとCharacter 3のワークフローは、画像+音声の生成を軸に組み立てられており、リップシンクと顔の動きはサウンドトラックが駆動します。
Hedraは現在、最大10分の長尺音声駆動アバター生成に対応し、用途として会話と歌唱を明示しています。
1人のキャラクターが、長く続くボーカルパフォーマンスを届けるコンセプトなら、Hedraは特に興味深いです。
たとえば、こうです。
スタイリッシュなバーチャルシンガー、カメラ固定のスタジオパフォーマンス、カメラに向かって歌うアニメーションキャラクター、長尺のボーカルプレゼンテーション。
ただし、連続した音声駆動のキャラクターショットと、複数ロケーションのミュージックビデオは、別の制作課題です。
絶え間ないシーンの切り替え、物語の展開、複数のカメラセットアップ、ミュージックビデオの間合いが欲しいなら、生成したパフォーマンスのまわりに、別の編集ワークフローを組む必要があるかもしれません。
こんな方におすすめ: 音声駆動の顔アニメーションがいちばんの要件である、長めの歌唱キャラクターとアバターのパフォーマンス。
どのAIリップシンク・ミュージックビデオツールを選ぶべきか?
「リップシンク・ミュージックビデオ」はまったく違うものを指し得るので、ただひとつの正解はありません。
写真1枚を歌わせたいなら、HeyGenのような専門ツールから始めましょう。
すでに強い画像や動画があり、それを歌唱ショットにしたいだけなら、Kaiberは検討する価値があります。
長く続くキャラクターパフォーマンスが欲しいなら、Hedraが特に関連します。
優先が、速い自動の楽曲からビデオ生成なら、FreebeatとRevidは高度に自動化されたアプローチを提供します。
選んだVocal Videoシーンがある、音楽を理解したストーリーボードが欲しいなら、Neural Framesは十分なコントロールを提供します。
そして、物語のシーン、繰り返し登場するキャラクター、ショット企画、タイムライン編集があるフルのパフォーマンスMVの中で、リップシンクをひとつの要素として扱いたいなら、BeatVizはその制作構造を軸に設計されています。
だから、リップシンク技術を選ぶ前に、欲しい完成ビデオを定義しておくと役立ちます。
欲しいのは、歌うアバターですか?
- •ソーシャルクリップ?
- •ビジュアライザー?
- •歌詞動画?
- •それとも、本物のマルチシーンミュージックビデオ?
それは、別の仕事です。
歌唱クリップ1本ではなく、フルのリリースを企画していますか?
完結した BeatVizのミュージックビデオワークフローを見てから、 BeatVizの料金 を確認し、楽曲のどこまでを生成・磨き込むかを決めましょう。
フルのミュージックビデオの中で、BeatVizはどうリップシンクを使うか
リップシンクは、楽曲のクリエイティブな構造に組み込まれているとき、いちばん効果的です。
仮の3分のポップロックを想像してください。
イントロは、環境のイメージで開く。
最初のヴァースは、無人のアパートをアーティストが歩く。
プレコーラスで、シンガーへ寄る。
そしてコーラスは、真正面のパフォーマンスになる。
ヴァース2は、物語の映像に戻る。
ブリッジは、親密なクローズアップ1本を使う。
最後のコーラスは、より大きなパフォーマンスシーケンスへ広がる。
口をボーカルに合わせる必要があるのは、これらのシーンの一部だけです。
残りのビデオは、それでも音楽に反応する必要があります。
だからBeatVizのワークフローは、広いクリエイティブ企画と、最終的なクリップの磨き込みを分けています。
Workflow:歌唱ショットを磨く前に、ビデオを組み立てる
まず、 Workflowにトラックをアップロードして始めましょう。
クリエイティブコンセプトを作る。
キャラクターを固める。
シーンを確認する。
最終的なモーションに進む前に、キーフレームを確認する。
これが重要なのは、キャラクターの一貫性は、リップシンクしたパフォーマンスを生成したあとより、その前のほうが解きやすいからです。
強いファーストフレームは、顔、髪、衣装、照明、構図、カメラアングルについて、生成モデルにより明確な情報を与えます。
全工程のより詳しい説明は、 AIで音楽をビデオにする方法をお読みください。
AI Director:アーティストがいつパフォーマンスするかを決める
次は、リップシンクの技術者ではなく、監督のように考えましょう。
AI Director を使って、パフォーマンスがビデオの中で果たすべき役割を説明できます。
たとえば、こうです。
オープニングは歌唱なしのシネマティックに。プレコーラスで、ミディアムのパフォーマンスショットとしてアーティストを登場させる。コーラスはリップシンク付きの真正面クローズアップ、フックのあとは物語の映像に戻る。
その指示には、次よりずっと役立つクリエイティブ情報が含まれています。
ビデオ全体をリップシンクにする。
Editor:重要なショットを直す
最後に、個別ショットにもっとコントロールが必要なときは、 BeatViz Editor を使いましょう。
パフォーマンスクリップは、タイムライン上の該当音声に合わせ、独立してリップシンクできます。
クリップ1本が失敗しても、完成したミュージックビデオ全体を捨てるのではなく、その区間だけに取り組めます。
このシーン単位の進め方が特に価値を持つのは、生成ビデオが確率的だからです。
目標は、すべてのショットが1回目で完璧だと期待することではありません。
目標は、弱いショットを見つけ、まわりを全部作り直さずに直せるワークフローを持つことです。
ミュージックビデオのすべてのショットをリップシンクすべきではない理由
AIミュージックビデオを単調に感じさせる、いちばん簡単な方法のひとつが、パフォーマーにずっと歌わせ続けることです。
本物のミュージックビデオは、しばしば異なる視覚的な役割のあいだを移動します。
あるショットは、パフォーマーを確立します。
別のショットは、物語を進めます。
別のショットは、雰囲気を作ります。
別のショットは、衣装や振り付けを強調します。
別のショットは、インストゥルメンタルのブレイクに反応します。
そして、ボーカルパフォーマンスを見ることが本当に何かを足すときに、ビデオはアーティストへ戻ります。
パフォーマンス映像は、句読点だと考えましょう。
重要な歌詞での強いクローズアップが力を持つのは、直前の2分間、同じ口が動き続けるのを見ていないからです。
役立つ構成は、たとえば次です。
パフォーマンス → ストーリー → 環境 → パフォーマンス → Bロール → ダンス → クローズアップ → ストーリー → ファイナルパフォーマンス
これで、リップシンク区間により重みが出ます。
生成が難しい顔のパフォーマンスショットの数を、減らせることもあります。
だからこそ、より広いガイド AIで音楽をビデオにする方法 では、リップシンクをビデオ全体の定義ではなく、シーン単位のクリエイティブ判断として扱っています。
より良いAI歌唱・リップシンクショットのためのヒント
はっきり見えるシンガーを1人にする
リップシンクモデルは、どの顔が音声に従うべきかをはっきり識別できるとき、一般により良く働きます。
重要なボーカルの瞬間では、ツールが複数の話者やパフォーマーに対応しているのでなければ、同じフレームに同じくらい目立つ顔を何人も置かないようにしましょう。
顔に、十分な画面スペースを与える
とても広い全身ショットでは、口の動きが隠れることがあります。
極端なクローズアップは、顔のアーティファクトをずっと目立ちやすくします。
ミディアムショット、ミディアムクローズアップ、通常のクローズアップは、しばしばより安全な出発点です。
Kaiber自身のリップシンク案内も、カメラ距離に注意し、はっきり見える前向きの被写体を使うことを推奨しています。
まずキャラクターの一貫性を固める
パフォーマンスショットごとにシンガーの顔の骨格が変われば、口の動きを改善しても、より大きな継続性の問題は解けません。
ボーカルアニメーションを磨く時間を使う前に、パフォーマーを固定しましょう。
視聴者が期待するところで、パフォーマンスを使う
コーラス、感情的なフック、カメラ目線の歌詞、ラップのヴァース、ボーカルのクライマックスは、通常、トランジションやインストゥルメンタルよりリップシンクの恩恵が大きいです。
いちばん良い生成は、視聴者がパフォーマーの顔をいちばん見そうなところに使いましょう。
多くをレンダリングする前に、難しいボーカルを試す
速いラップ、強い子音、重なるボーカル、アドリブ、ハーモニー、変わったフレージングは、ゆっくりきれいなボーカルラインより負荷が大きくなり得ます。
まず代表的な区間を試すと、そのツールが自分のトラックをどう扱うかを理解しやすくなります。
ファーストフレームを無視しない
リップシンクモデルにも、動かすに足る、信じられるパフォーマーが必要です。
口を覆う髪、極端な横顔、不自然な顔の歪み、低い画像品質は、同期が始まる前に問題を持ち込めます。
Sunoの楽曲でリップシンクは使えるか?
はい。
完成したSunoのトラックも音声ファイルなので、アップロードした音楽や互換のある楽曲取り込みを受け付けるAIビデオツールで使えます。
より重要な問いは、そのまわりにどんなビデオを作りたいかです。
アバター1人がトラックを歌うだけでよければ、写真から歌唱へのツールで足りることがあります。
フルのミュージックビデオが欲しいなら、次も考える必要があります。
- •楽曲構成
- •キャラクター
- •ロケーション
- •ビジュアルストーリーテリング
- •パフォーマンスショット
- •編集
- •シーンの一貫性
そのワークフローは、 Suno AIでミュージックビデオを作る方法で別に解説しています。
完成したトラックを BeatVizミュージックビデオジェネレーター に直接アップロードして、楽曲そのものからビジュアル制作を組み立てることもできます。
よくある質問
リップシンクに対応しているAIミュージックビデオジェネレーターは?
BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen、Hedraはいずれも現在、形は違えどリップシンクまたは音声駆動の歌唱機能を提供しています。適切な選択は、歌うキャラクター1人が必要か、マルチシーンのミュージックビデオ全体が必要かによって変わります。
シンガーを歌わせるのに最適なAIは?
ポートレート1枚を歌うキャラクターにするなら、HeyGenやHedraのような専用のアバター・写真アニメーションツールが有力です。
そのシンガーを完成したミュージックビデオに組み込むなら、BeatViz、Neural Frames、Freebeat、Revidのようなプラットフォームが、より広い楽曲からビデオまでのワークフローを提供します。
AIは楽曲全体をリップシンクできるか?
はい。数分の音声駆動パフォーマンスに対応するプラットフォームもあります。
ただし、連続して歌うキャラクターを1人生成することと、フルのミュージックビデオを作ることは違います。
ほとんどのMVでは、重要なパフォーマンスショットを選んでリップシンクし、パフォーマンス以外のシーンと混ぜたほうが、ビジュアルの変化は通常大きくなります。
リップシンクとビートシンクの違いは?
リップシンクは、パフォーマーの口をボーカルに同期します。
ビートシンクは、カット、トランジション、シーンのタイミングといった編集判断を、音楽のリズムに合わせます。
シンガーがまったく写っていなくても、ビデオはビートシンクできます。
写真1枚からAIシンガーを作れるか?
はい。HeyGen、Hedra、Kaiber、Freebeatのようなツールは現在、音声を使ってキャラクターやポートレートを動かせるワークフローを提供しています。
Sunoの楽曲を、AIリップシンクのミュージックビデオに使えるか?
はい。
楽曲が手元にあれば、互換のあるAIビデオツールでその音声を使えます。Suno関連の直接取り込みワークフローを提供するプラットフォームもあります。
すべてのシーンにリップシンクは必要か?
いいえ。
多くの場合、パフォーマンス映像を物語のシーン、雰囲気、Bロール、ダンス、そのほかのビジュアルアイデアと混ぜたほうが、ビデオはよりシネマティックになります。
シンガーのパフォーマンスを見ることが、感情的または音楽的な価値を足すところで、リップシンクを使いましょう。
AIはフルのパフォーマンスミュージックビデオを作れるか?
はい。ただし、これはポートレートを動かすより複雑な仕事です。
完成したパフォーマンスMVには、楽曲分析、シーン企画、キャラクターの一貫性、パフォーマンス生成、リップシンク、ビートを意識したタイミング、編集、選択的な再生成が必要になることがあります。
だから、土台のワークフローは、リップシンクモデルそのものと同じくらい重要です。
歌うアバターではなく、パフォーマンスへ楽曲を変える
説得力のあるAIミュージックビデオに必要なのは、動く口だけではありません。
パフォーマーは、ショットからショットまで同じ人物だと感じられる必要があります。
カメラは、意図を持って変わる必要があります。
物語には、息をする余地が必要です。
編集は、音楽に反応する必要があります。
そして、アーティストが歌う瞬間は、意図的だと感じられるべきです。
それが、AIの歌唱クリップを作ることと、AIのパフォーマンスミュージックビデオを演出することの、本当の違いです。
すでに楽曲があるなら、 BeatViz AIミュージックビデオジェネレーターから始め、 Workflow または AI Directorでコンセプトを育て、個別のパフォーマンスショットをもっと精密に制御したいときは Editor へ進めます。
楽曲のまわりにパフォーマンスを組み立てましょう。逆ではありません。