YouTube 上的 AI 音乐视频,创作者都在用什么工具?
在 YouTube 上看多了 AI 音乐视频,你可能也会开始想同一件事:
这些创作者到底在用什么工具?
答案通常比「Kling」或「Runway」更复杂。
目前并没有可靠的公开数据,能证明某一种 AI 工具包办了 YouTube 上的大多数音乐视频。而在实际操作里,很多创作者根本不是只用一个工具。
他们用的是一套工具栈。
一个工具负责做歌。另一个帮忙发展视觉概念。图像生成器创建歌手或首帧。视频模型让镜头动起来。再有一个工具处理口型同步。最后,一切会在 CapCut、Premiere Pro、DaVinci Resolve,或音乐优先的 AI 视频平台里组装起来。
一套典型工作流可能是这样的:
Suno → ChatGPT → OpenArt → Kling → CapCut
另一位创作者可能会用:
已有歌曲 → Midjourney → Veo → Premiere Pro
而想减少工具切换的人,可能会用音乐优先平台,例如BeatViz AI 音乐视频生成器,在同一个相连项目里完成更多规划、场景生成和剪辑。
所以,这篇指南不会给十个工具排个名,然后假装某一个「最好」。我们会拆开制作的每一个阶段,看创作者分别用哪些 AI 音乐视频工具——以及每个工具真正在做什么。
简短回答:大多数 AI 音乐视频用的是一套工具栈
「AI 音乐视频工具」可以指完全不同的几类产品。
一个能生成五秒漂亮电影感镜头的工具,和一套能分析三分钟歌曲、规划场景、同步剪辑并导出成片的软件,做的根本不是同一件事。
这个区别很重要。
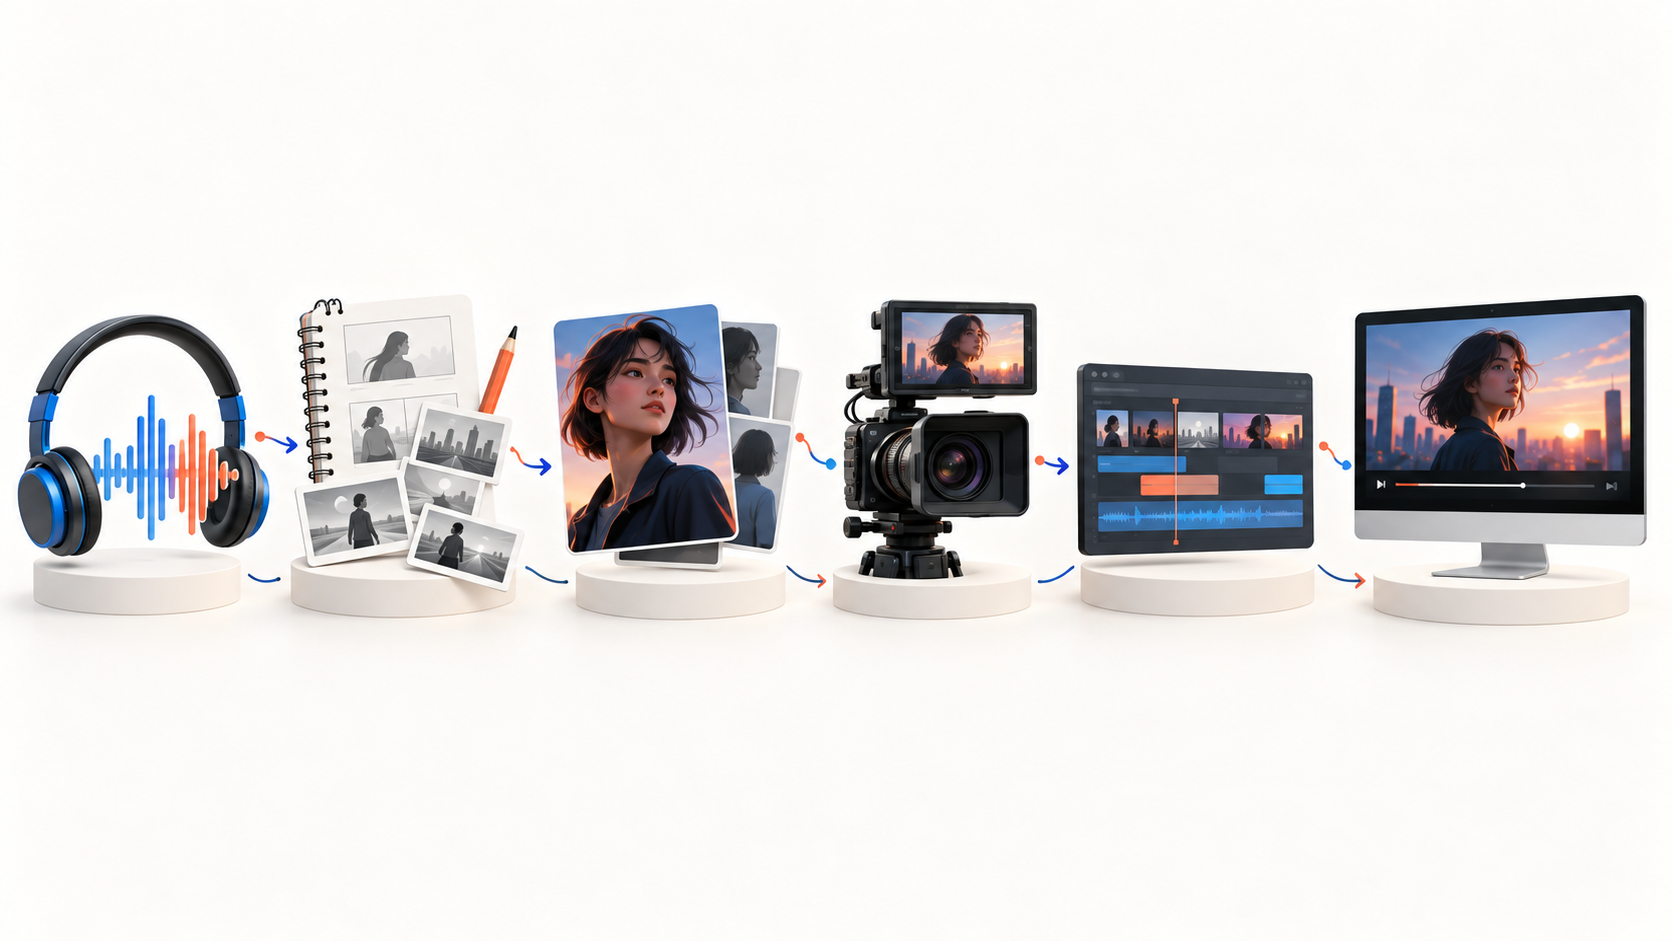
一套实用的 AI 音乐视频工作流,往往包含下面这些阶段中的若干环:
| 阶段 | 创作者需要什么 | 常见工具类型 |
|---|---|---|
| 音乐 | 创作或完成歌曲 | Suno、Udio、DAW |
| 规划 | 故事、视觉概念、分镜想法 | ChatGPT 及其他大语言模型 |
| 角色与首帧 | 一致的人物、地点、首帧 | OpenArt、Midjourney、GPT Image 及其他图像生成器 |
| 视频生成 | 把图像或提示词变成动态镜头 | Kling、Veo、Runway、Wan 及类似视频模型 |
| 表演 | 演唱、口型同步、舞蹈、乐器表演 | 视频模型和专门的口型同步工作流 |
| 剪辑 | 排布镜头、同步音乐、剪掉薄弱场景 | CapCut、Premiere Pro、DaVinci Resolve |
| 完整音乐视频工作流 | 把其中多个阶段连起来 | BeatViz 及其他音乐优先平台 |
这也解释了,为什么问「这支音乐视频是哪个 AI 生成的?」往往没有简单答案。
一支三分钟的视频,可能包含好几个不同模型产出的镜头。
最终效果不取决于某一个神奇模型,而取决于创作者如何把这些工具连起来。
1. 音乐生成:许多 AI 音乐视频的起点
对一部分创作者来说,音乐已经有了。
对另一部分人来说,在生成任何一帧视频之前,AI 就已经介入了。
Suno
Suno 已经成为许多创作者尝试 AI 生成歌曲时熟悉的起点。创作者可以在这里发展歌词、曲风方向、人声和完成的曲目,再把音频带进另一套视觉工作流。
这就是为什么你经常会在 AI 音乐视频教程的开头看到 Suno,而不是在视频生成那个阶段。
关键区别在于:
做歌和做音乐视频,是两件不同的制作问题。
歌做完之后,创作者仍然需要决定它该长什么样。
如果你的歌从 Suno 开始,请阅读我们的指南:如何把 Suno 歌曲做成 AI 音乐视频,里面更详细地讲解了这一步过渡。
Udio
Udio 在更广泛的 AI 音乐生态里扮演类似角色。
创作者可能在那里生成歌曲,导出完成的音频,再进入视觉规划和视频制作。
如果你已经有自己的歌呢?
那你可以完全跳过 AI 音乐生成这一步。
对已经有完成曲目的音乐人、制作人、唱片公司或艺人来说,真正的工作流从这里开始:
歌曲 → 视觉概念
这听起来很显然,但它会改变你真正需要哪些工具。
如果你的目标只是把已有曲目视觉化,再去付费订阅另一个音乐生成平台,对工作流可能毫无帮助。
2. 生成片段之前,先规划音乐视频
这是 AI 视频创作里最不炫的部分之一——也是最重要的部分之一。
很多 AI 音乐视频看起来弱,并不是因为视频模型差。
真正的原因是:从来没有一个清晰的视觉计划。
在把 Credits 花在视频生成上之前,创作者常常会用 ChatGPT 或其他语言模型来回答这些问题:
- •主角是谁?
- •视频发生在哪里?
- •副歌时应该发生什么?
- •哪些视觉元素应当重复出现?
- •哪些段落需要表演镜头?
- •视频该在哪里放慢?
- •运镜该在哪里变得更有能量?
- •第一段主歌和第二段主歌之间,有什么变化?
例如,不要立刻提示:
霓虹城市里一个女人在唱歌。
创作者可能先定义:
一位孤独的女歌手,在主歌里走过午夜后安静的东京街道。每一段副歌都进入拥挤的霓虹街机厅,世界变得更亮、更有能量。最终副歌发生在日出时的屋顶。
现在,视频有了视觉结构。
单个提示词会好写得多,因为每一个镜头都属于同一个想法。
把歌曲结构变成分镜结构
听整首歌,标出主要段落:
前奏 → 主歌 → 预副歌 → 副歌 → 主歌 → 副歌 → 桥段 → 最终副歌
然后问:它们之间,画面上该发生什么变化。
你不需要每五秒换一个全新地点。
事实上,重复几个有力的地点,往往让音乐视频更有意图。
副歌回到同一个舞台、俱乐部、屋顶、公寓或表演环境,能形成视觉身份,而不是让重复听起来像局限。
先规划,也能省钱。
一个糟糕的想法还只是一句话时就否掉它,远比从它生成二十个视频片段之后再否掉便宜得多。
3. 创建角色和首帧
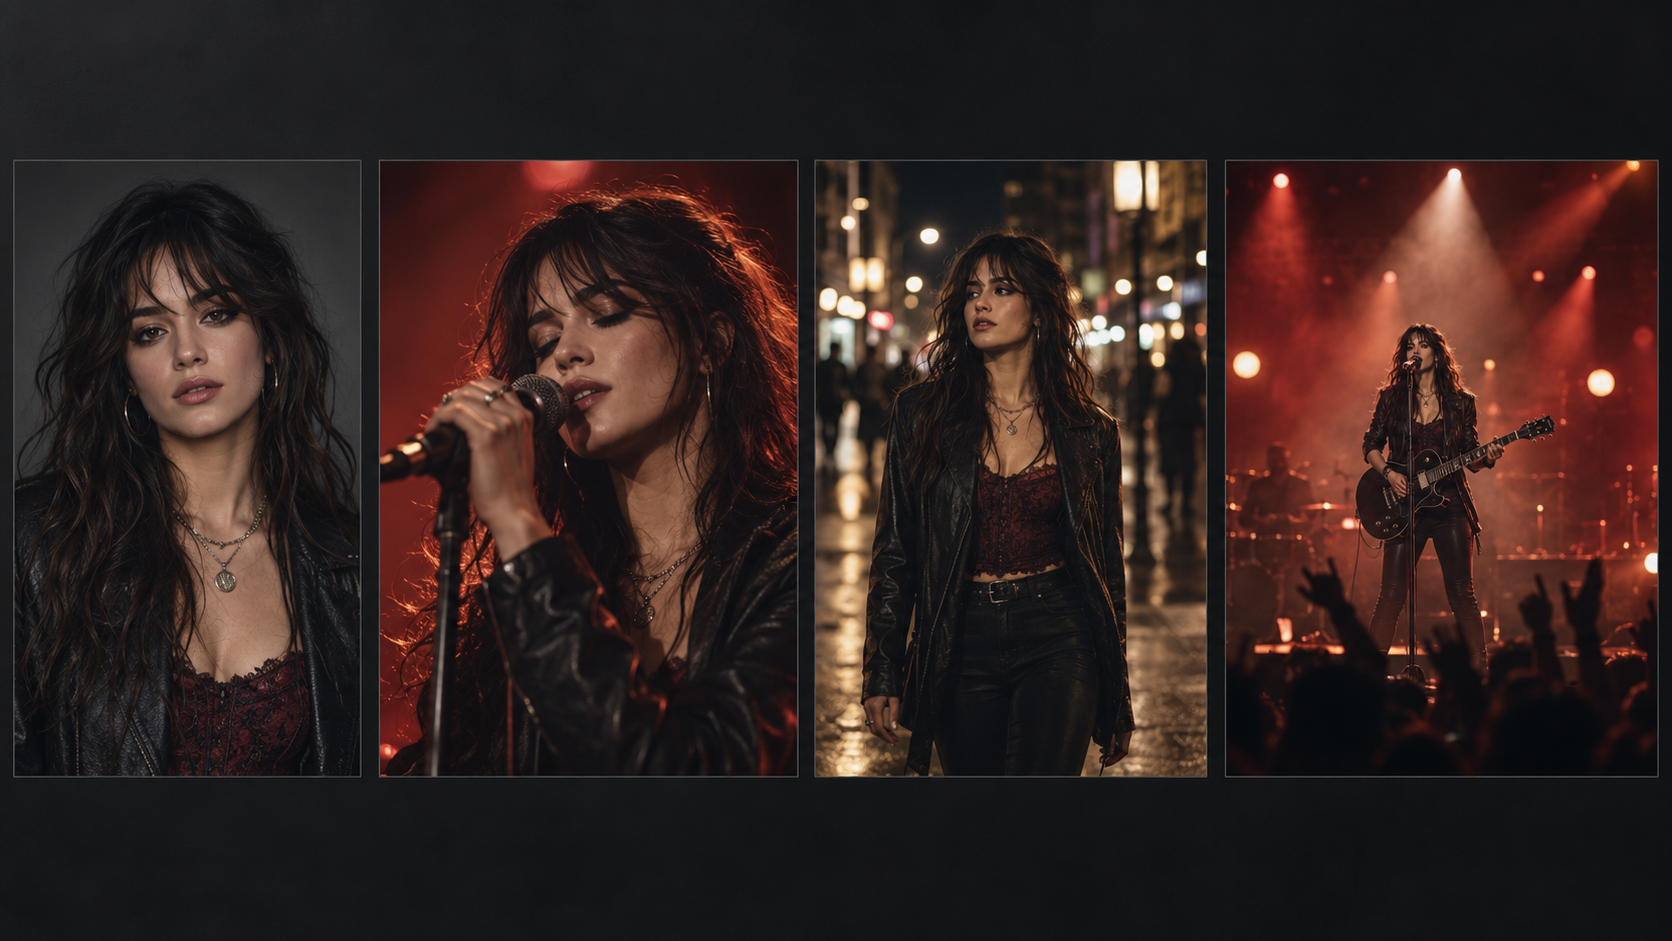
创意方向清楚之后,许多创作者会在视频生成之前先做图像生成。
这就是为什么 OpenArt、Midjourney、GPT Image 以及类似模型,会频繁出现在 AI 音乐视频工作流里。
目标不一定是做出完成的艺术品。
这张图,往往成为视频模型的视觉基准。
为什么图生视频如此常见
想象一下,你希望同一位女表演者出现在十个场景里。
如果用文生视频,每一次新生成都得重新理解这样的描述:
24 岁女性,黑色长发,红色皮夹克,银色项链……
即使提示词很详细,脸、头发、服装和身体比例仍然可能漂移。
一张参考图,能给视频模型更多可依据的视觉信息。
因此,一套实用工作流可能是:
- 1.设计角色。
- 2.把第一个场景生成为静帧。
- 3.检查脸、服装、地点、光线和镜头角度。
- 4.如果有问题,先修好静帧。
- 5.然后再让它动起来。
这对音乐视频尤其有用,因为视频生成往往是更贵的阶段之一。
如果首帧里已经是错的人、错的造型或错的构图,把它变成一段八秒视频,很少能把这个问题修好。
4. 许多 YouTube 音乐视频背后的 AI 视频模型
现在才轮到人们通常最先想到的那些工具。
Kling。Veo。Runway。Wan。以及越来越多其他视频模型。
这些工具能做出令人印象深刻的画面,但通常应当把它们想成镜头生成器,而不是自动当成完整的音乐视频制作系统。
Kling
Kling 经常出现在创作者的工作流里,用于图生视频、电影感运动、表演镜头和以角色为主的场景。
创作者可能在别处生成角色图,导入 Kling,生成五秒或八秒动画,下载结果,再对下一个场景重复这个过程。
这可以非常有效。
代价是管理成本。
一首三分钟的歌可能需要几十个可用片段,而每一次生成最终都要找到它在成片时间轴上的正确位置。
Google Veo
当画面质感和电影感生成很重要时,Veo 是创作者会考虑的另一个选项。
对音乐视频来说,高质量模型尤其适合核心镜头:
- •戏剧性的建立镜头
- •表演特写
- •大型电影感环境
- •视觉上关键的副歌瞬间
但同样,一个漂亮镜头只是音乐视频的一部分。
歌曲仍然需要结构、节奏、连贯性和剪辑。
Runway
对已经习惯以电影人或剪辑师方式思考的创作者来说,Runway 往往很有吸引力。
当你想产出单段素材,并保留更多控制权,决定这些素材如何进入更完整的制作流程时,它会很有用。
这对已经计划在剪辑软件里完成项目的创作者来说很合理。
Wan 和其他视频模型
可用的 AI 视频模型名单变化很快。
这也是不要把整套工作流绑在某一个模型名字上的另一个原因。
今天最适合某一种运动的模型,之后可能被更强的选项取代。
更好的问题是:
这个镜头需要完成什么任务?
也许一个模型给你更好的运镜。
另一个更擅长特写。
再一个能做出更可信的舞蹈。
还有一个对转场场景更划算。
有经验的创作者越来越像电影人对待镜头或摄影机那样对待 AI 视频模型:
为这个镜头选对的那一个。
5. 口型同步、演唱、舞蹈和表演镜头
一个人走在街上的电影感镜头,对错误相对宽容。
歌手唱副歌的特写,则不是。
一旦角色需要唱歌、说话、跳舞或演奏乐器,观众对错误会敏感得多。
口型同步会改变难度
一个有说服力的表演镜头,需要的不只是大概对上的嘴部运动。
观众同时在看:
- •口型
- •时机
- •面部表情
- •头部运动
- •眼睛运动
- •呼吸
- •肢体语言
如果嘴在技术上跟着歌词动,脸却像冻住了,表演仍然会显得假。
这就是为什么有些 AI 音乐视频工作流会分开处理:
电影感空镜
和
表演镜头
创作者不会给每个场景都做口型同步,而是把演唱特写留给最重要的人声段落,其他地方用叙事或氛围镜头。
乐器会带来另一个一致性问题
如果歌手拿着吉他、弹钢琴、打鼓,或与另一位表演者互动,手和物体的交互就成了镜头的一部分。
对这类场景,更简单的构图往往能产出更强的结果。
一个吉他手的中景,通常比三位乐手一边做复杂编舞、一边让镜头绕着他们转,更容易控制。
AI 视频进步很快,但好的导演仍然重要。
6. 为什么 CapCut、Premiere Pro 和 DaVinci Resolve 仍会出现在 AI 工作流里
如果 AI 能生成视频,为什么创作者还要打开传统剪辑软件?
因为生成和剪辑是不同的工作。
假设你为一首三分钟的歌生成了 35 个片段。
有些非常出色。
有些还能用。
三个完全不能用。
好几个稍微太长。
副歌需要更快的剪辑。
一个表演镜头应该晚两秒开始。
这是剪辑问题。
CapCut、Adobe Premiere Pro 和 DaVinci Resolve 这类工具,常被用来:
- •把片段对上最终音频
- •剪掉生成瑕疵
- •把镜头移到正确的音乐段落
- •控制节奏
- •替换薄弱片段
- •加转场
- •统一镜头色彩
- •加标题或字幕
- •准备最终导出
因此,常见的创作者工作流并不是:
提示词 → 完整音乐视频
而更接近:
生成 → 审阅 → 筛选 → 重新生成 → 剪辑 → 导出
这也是为什么公开教程仍然经常展示 Suno + Kling + CapCut 这样的组合,而不是从头到尾只靠一个生成工具。
BeatViz 在 YouTube AI 音乐视频工具栈里的位置
多工具工作流有一个主要优势:
灵活。
几乎每一项任务,你都可以选不同的工具。
但这种灵活,会带来一次次交接。
- •在一个平台生成图像。
- •下载。
- •上传到视频模型。
- •生成片段。
- •下载片段。
- •重命名。
- •上传到剪辑软件。
- •在歌里找到正确位置。
- •重复。
这套工作流完全说得通——尤其适合享受亲手控制制作每一环的创作者。
但它不是唯一选项。
BeatViz从相反的方向处理这个问题:
从音乐视频项目开始,再围绕歌曲连接各个生成阶段。
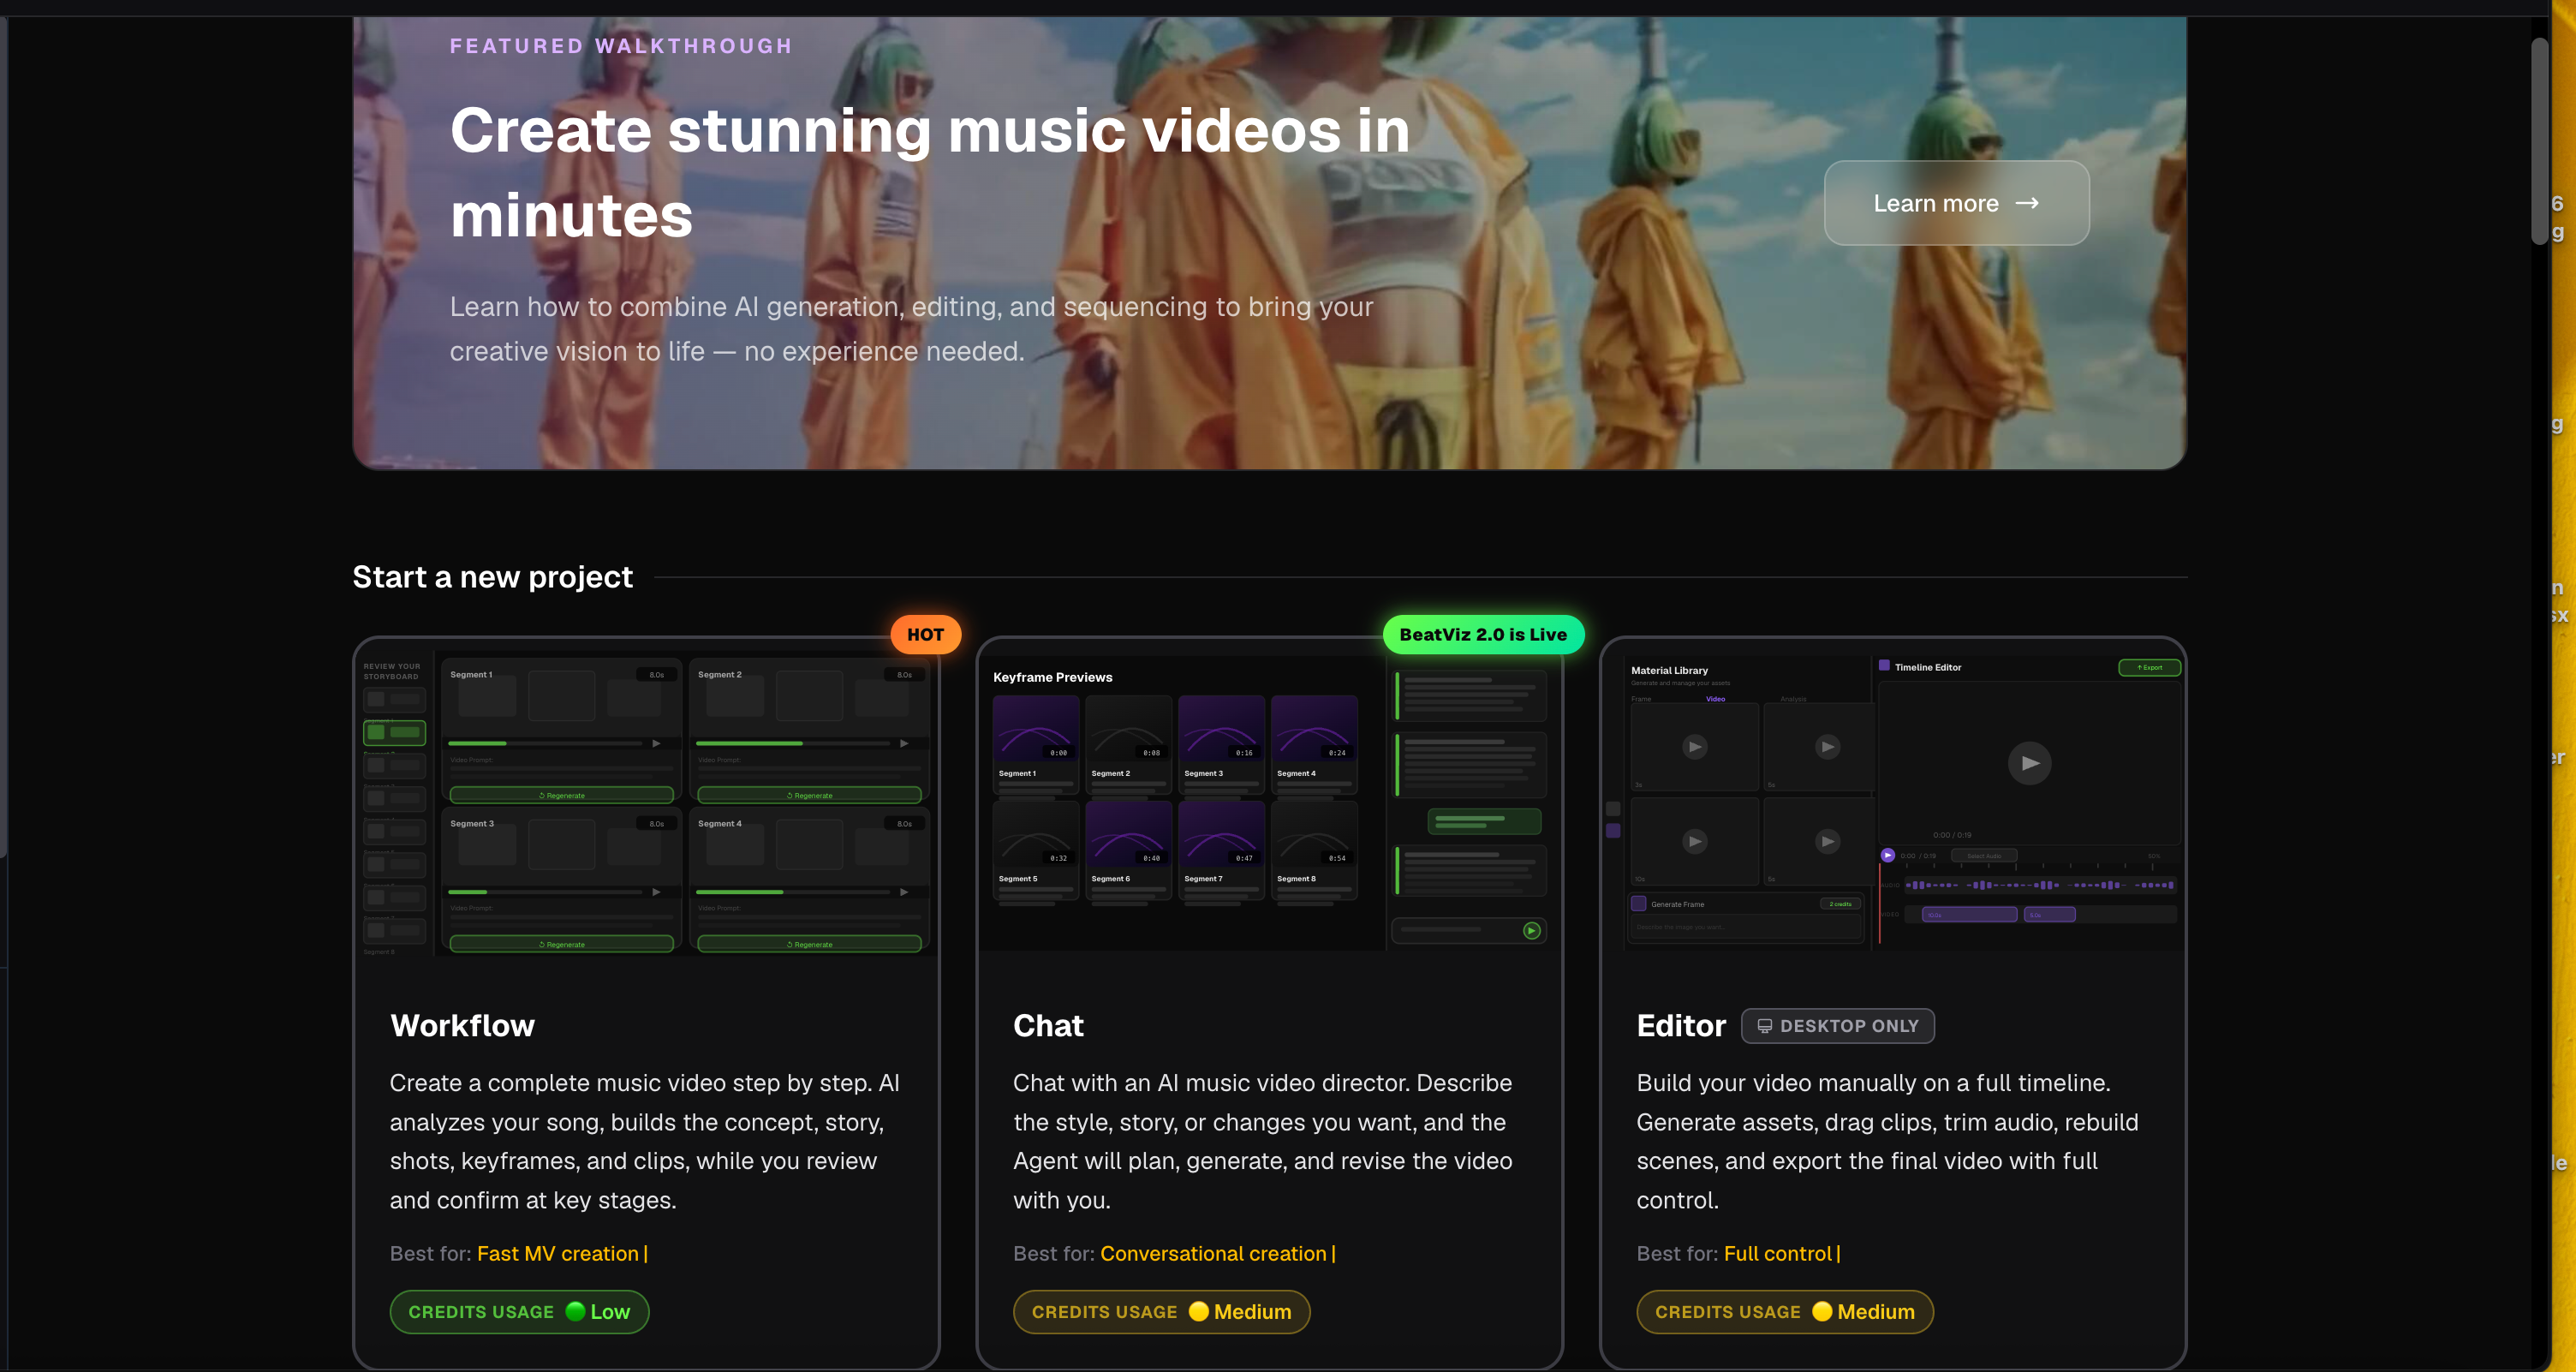
BeatViz Workflow:一步步搭建完整音乐视频
BeatViz Workflow适合歌曲已经完成、你希望 AI 帮你搭建完整制作结构的情况。
不必从空白时间轴手动创建每一个片段,流程可以走过:
音乐分析 → 视觉方向 → 故事 → 场景 → 分镜 → 首帧 → 视频 → 最终组装
重要的是,你可以在昂贵的视频生成阶段之前,先审阅关键决策。
这对更长的音乐视频尤其有用,因为管理几十个互不相干的素材会变得很难。
你可以把它理解成引导式选项。
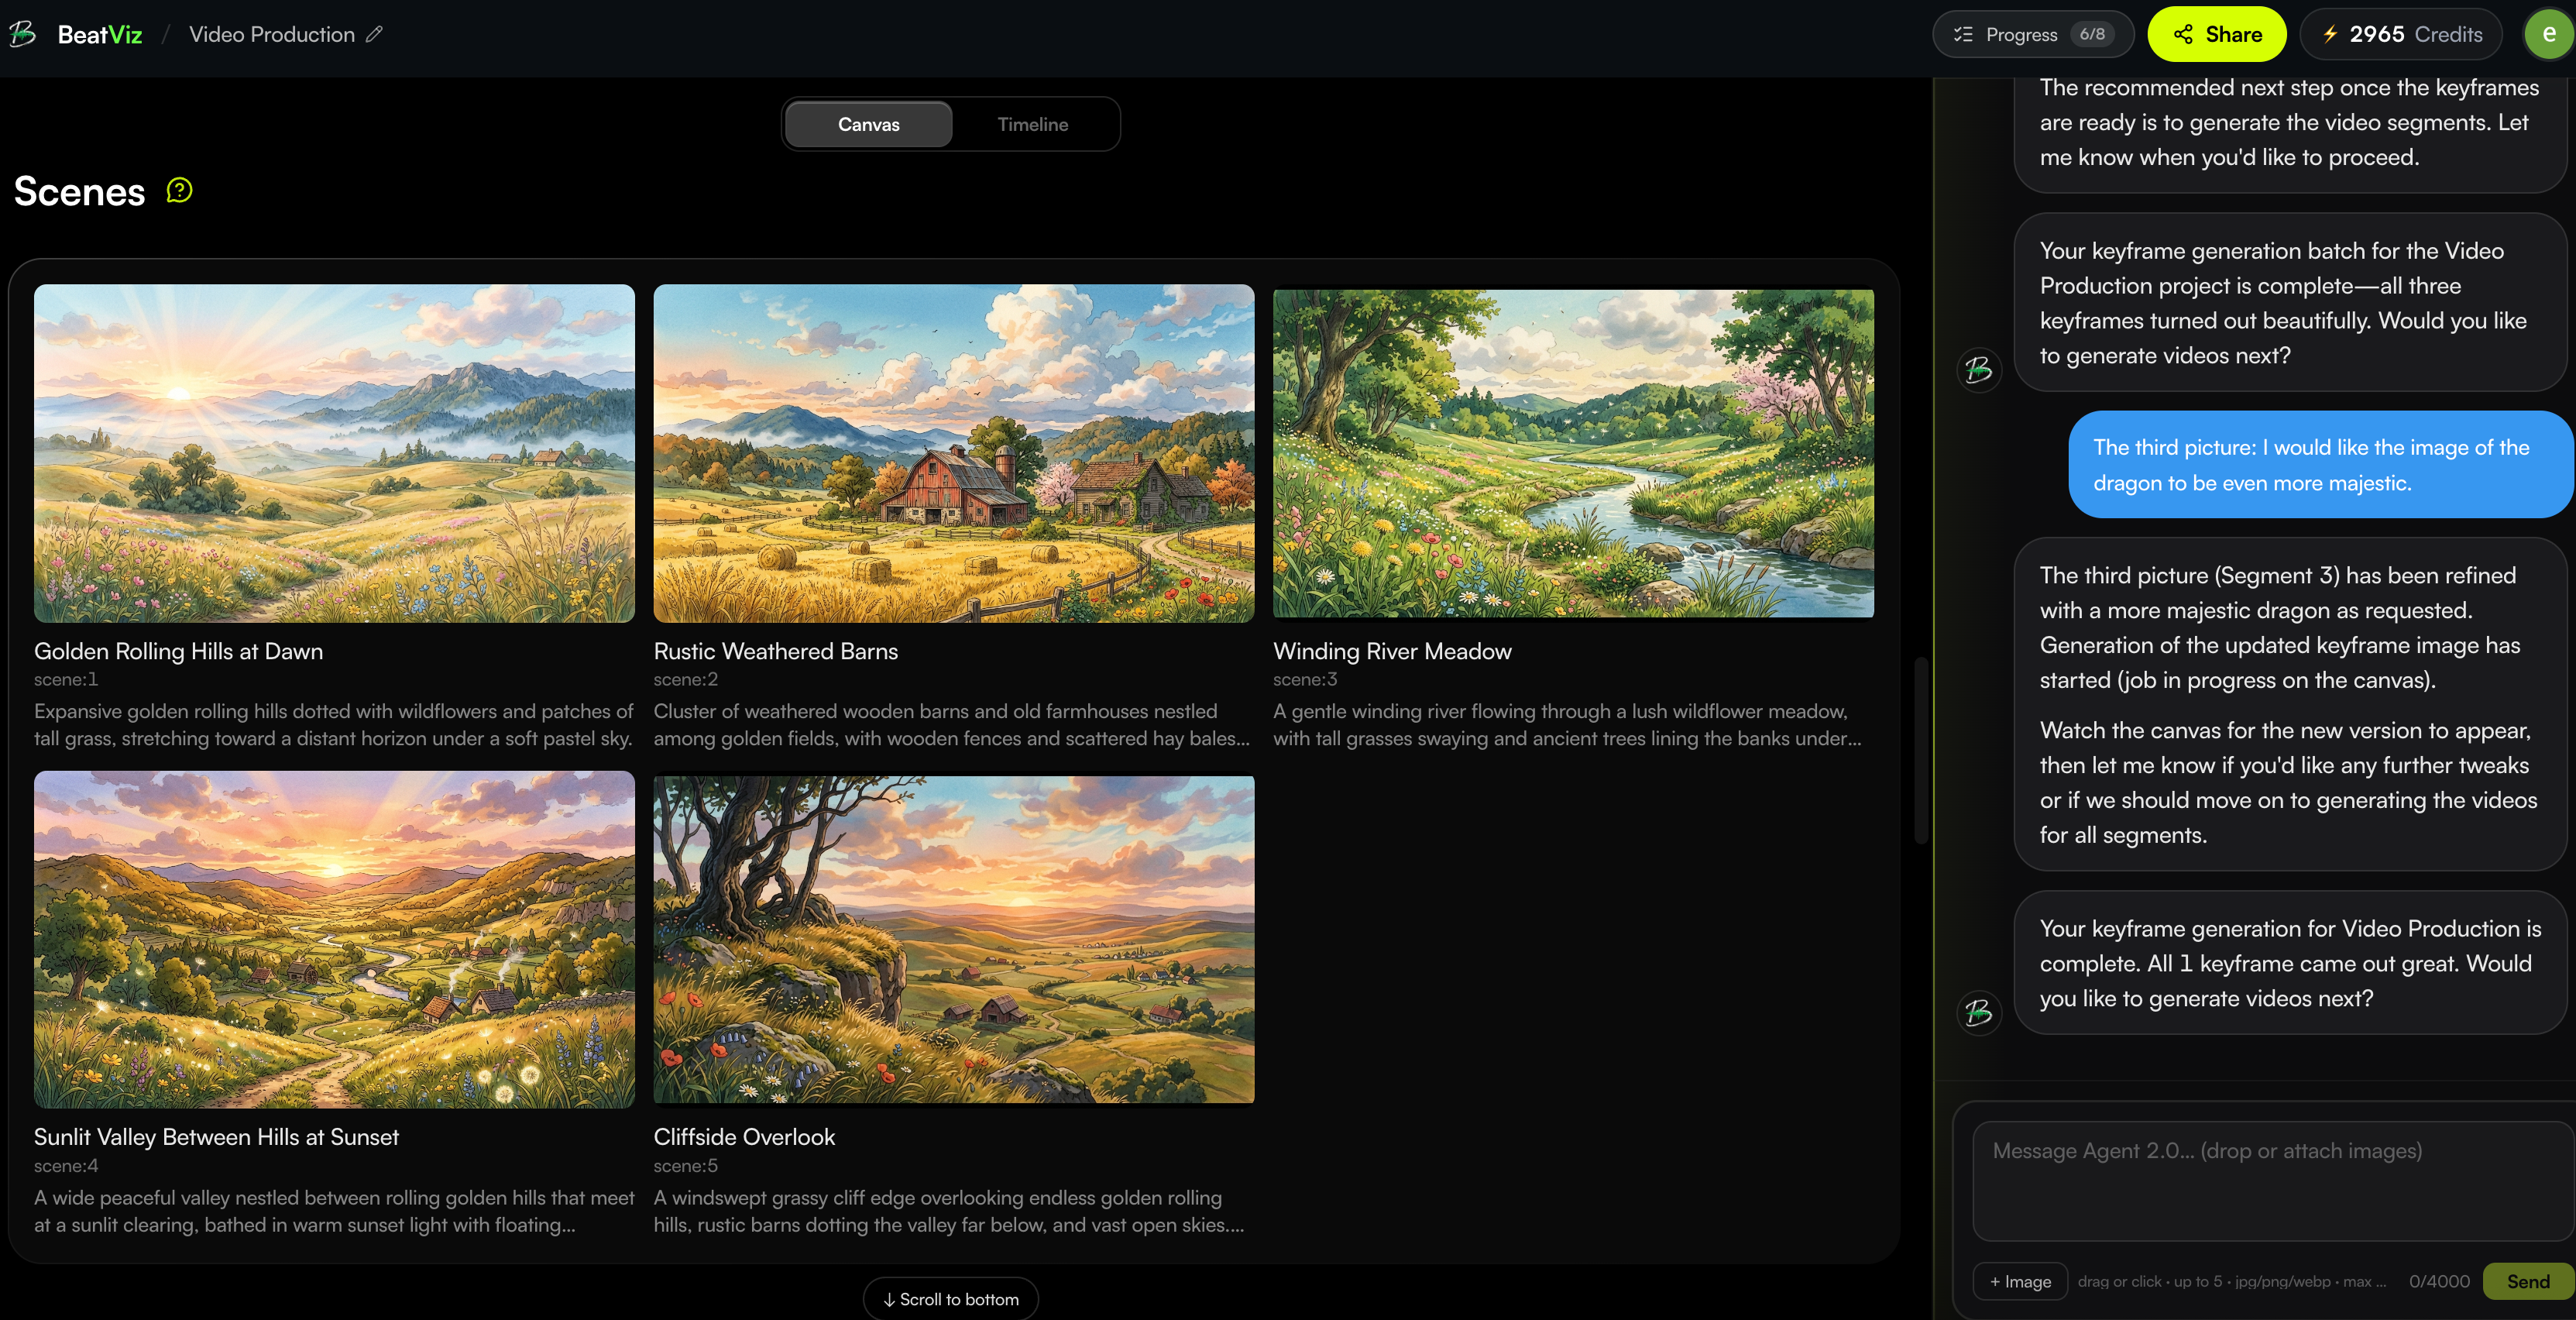
BeatViz AI Director:当你想通过对话来导演
有时你不想要固定的操作顺序。
你想说:
让第二段副歌更有能量。
或者:
把这个场景从公寓改到夜间屋顶。
或者:
保持同一位歌手,但把这个改成特写,镜头缓缓推进。
这正是BeatViz AI Director的设计出发点。
你上传音乐,通过对话和 AI 一起发展视觉计划,并随着想法演变不断精修项目。
这很重要,因为真正的创作指导很少发生在一条完美提示词里。
你做一个决定。
你看结果。
你调整它。
然后继续。
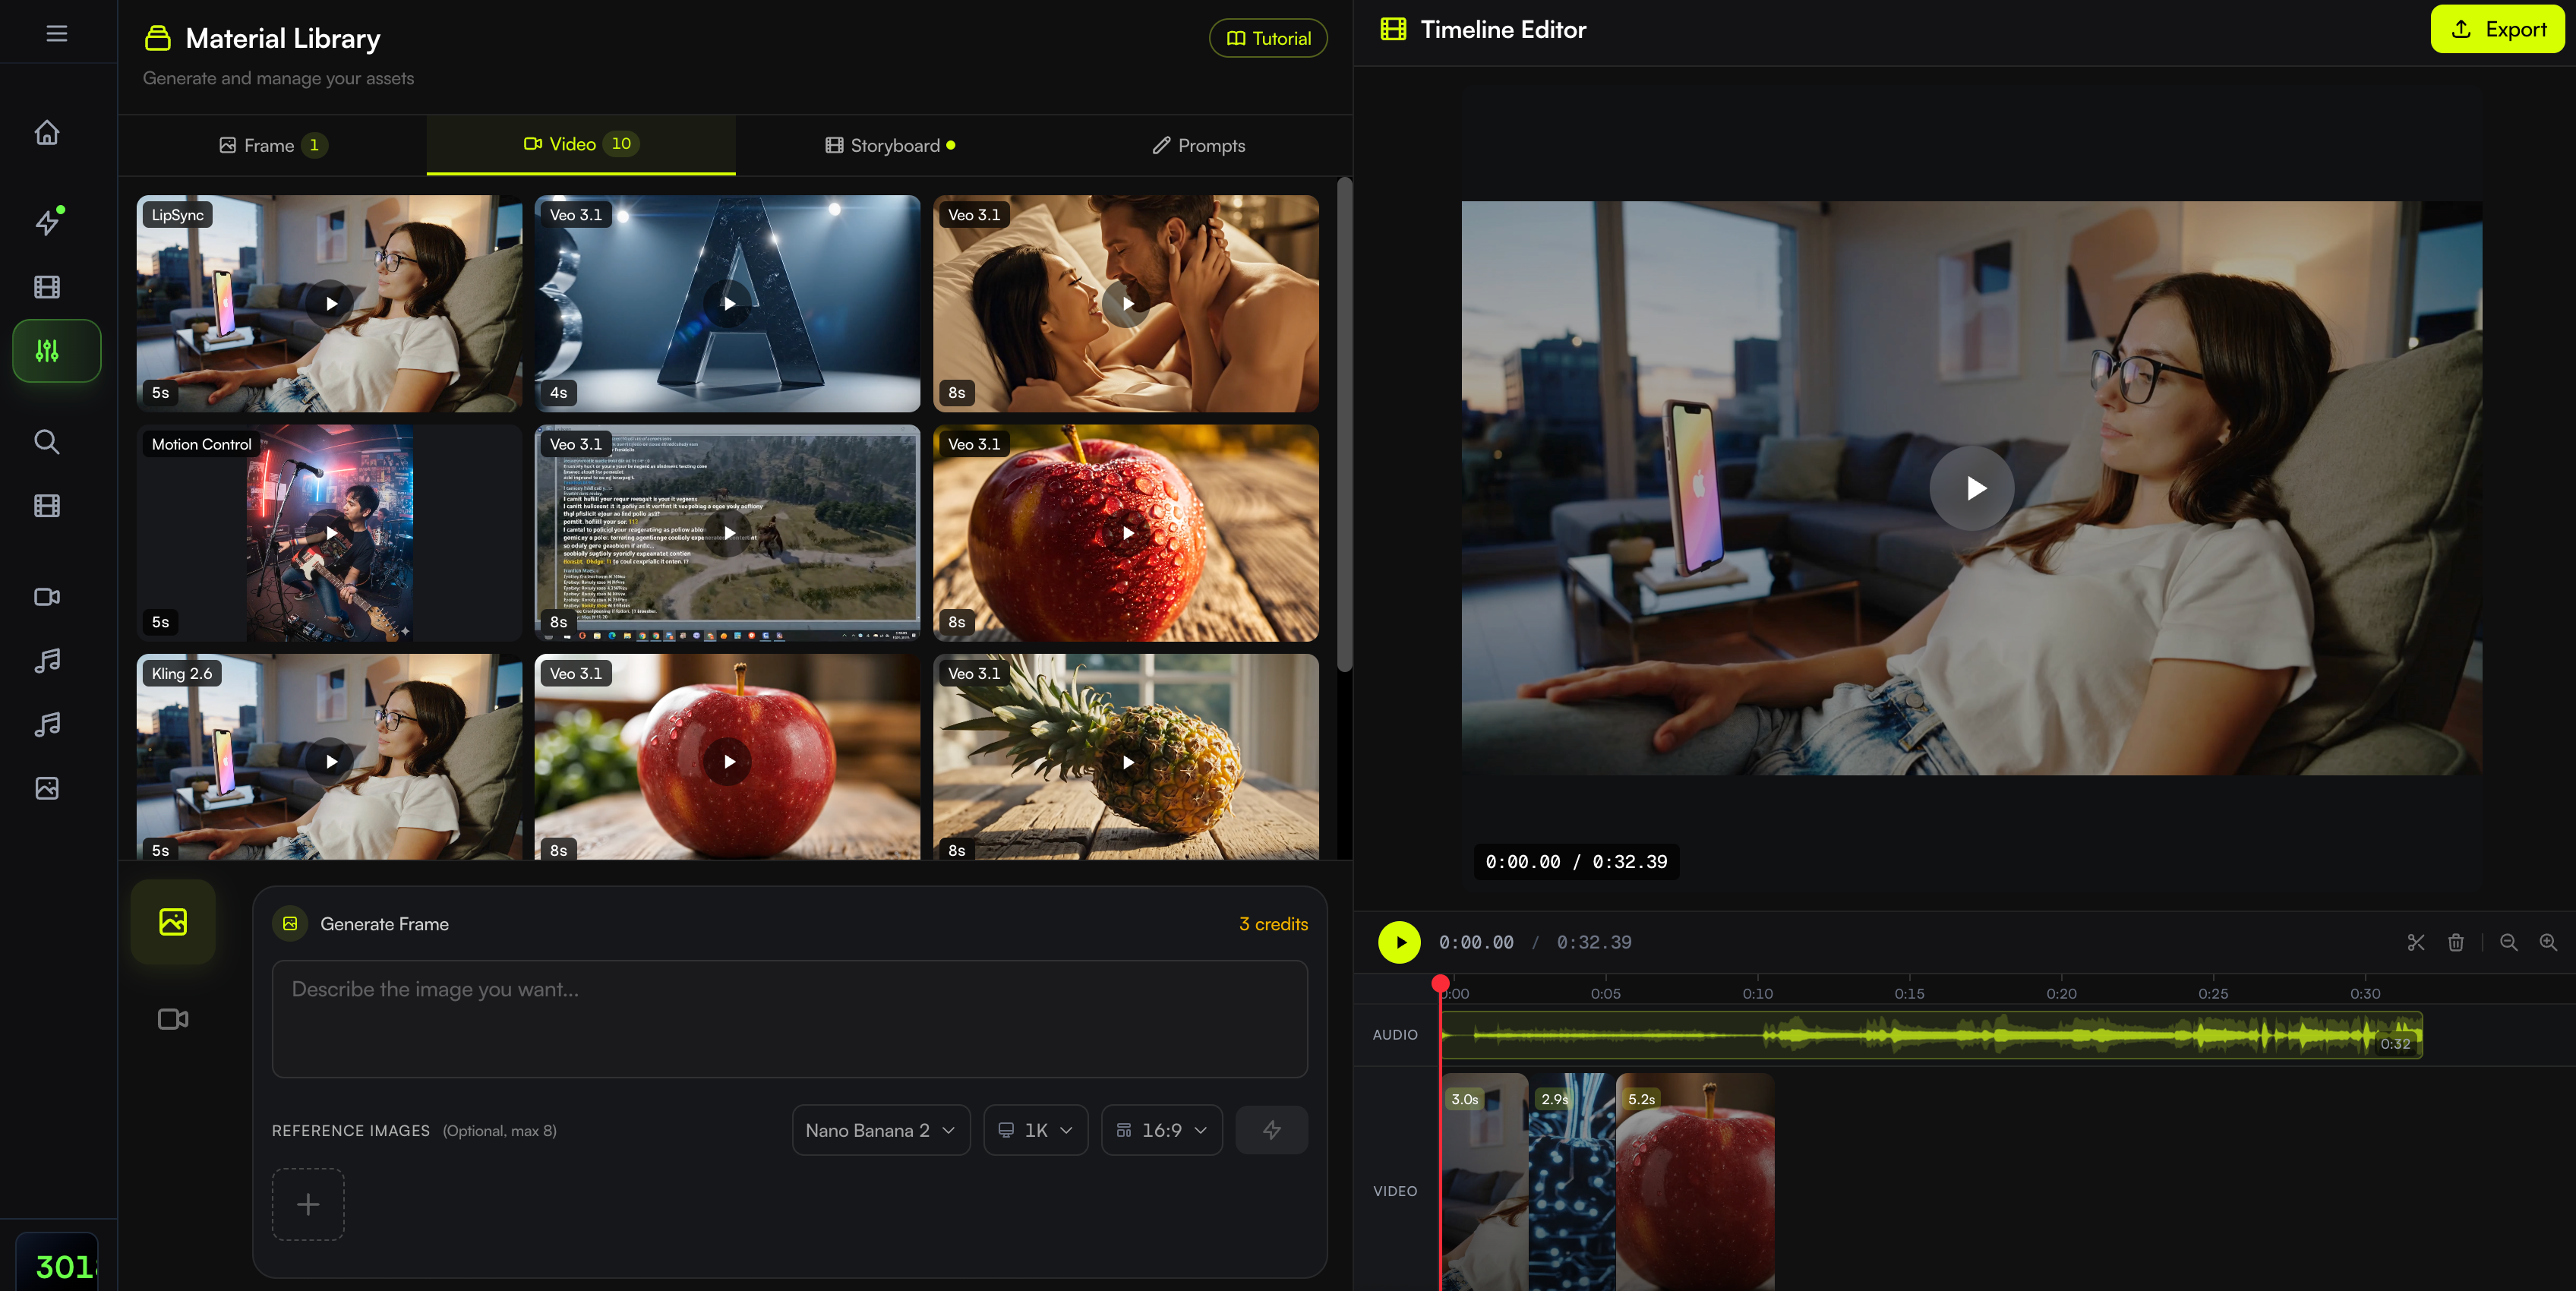
BeatViz Editor:当单个镜头需要更多控制
自动化可以帮你拿到一版有力的初剪。
但最终你可能只想修好某一个场景,而不重建整个项目。
BeatViz Editor则是更偏手动的选项。
它把生成和时间轴工作区结合在一起,让你可以处理单个场景和片段。
在这些情况下它会很有用:
- •需要替换某一张首帧
- •某个表演镜头需要口型同步
- •某个场景需要换一个视频模型
- •某个片段需要重新生成
- •时机需要调整
- •你想对最终序列有更多控制
理解这三种模式的一个有用方式是:
Workflow 帮你搭建制作。
AI Director 帮你导演制作。
Editor 帮你精修制作。
你该用哪套 AI 音乐视频配置?
没有一套对所有人都正确的工具栈。
合适的配置,取决于你想要多少控制权,以及你最在意流程的哪一部分。
如果你想要最大限度的手动控制
把工具拆开用。
例如这样的工作流:
ChatGPT → 图像生成器 → Kling/Veo/Runway → Premiere Pro 或 CapCut
让你可以为每一个阶段选择确切的模型。
代价是更多文件管理和更多手动剪辑。
如果你主要想要电影感核心镜头
把预算集中在一个强的通用视频模型上。
用 Kling、Veo、Runway,或当前最匹配你视觉方向的模型,少生成、生成得更好,再手动组装这些镜头。
如果你已经会剪辑,这种方式尤其有效。
如果你想要抽象或强音频响应的视觉
Neural Frames 这类音乐专用工具,可能比传统的角色驱动工作流更合适。
不是每支音乐视频都需要歌手或故事。
电子、氛围、迷幻和实验曲目,可以从直接响应音乐的视觉中获益。
如果歌已经做完,你想要一支完整音乐视频
这时,音乐优先的工作流会更有用。
不要想:
下一个五秒该用哪个模型生成?
而是想:
第二段副歌时该发生什么?
这个差别听起来很小,却会改变整套工作流。
BeatViz 这类平台,就是围绕第二个问题来建的。
如果视频主要是表演
优先考虑:
- •角色一致性
- •可信的口型同步
- •面部表情
- •乐器互动
- •时间轴控制
如果歌手的脸在镜头切换之间变了,再壮观的环境也救不了一个表演镜头。
若想了解如何搭建整体制作,而不是挑选单个模型,请阅读我们的指南:如何制作音乐视频:音乐人分步指南。
做一支音乐视频,需要订五份不同的 AI 订阅吗?
不一定。
但这是初学者有时会忽略的一项重要成本。
一套手动工具栈,可能需要分别支付:
- •AI 音乐生成
- •图像生成器
- •一个或多个视频模型
- •口型同步工具
- •剪辑软件
- •镜头失败时的额外生成
这并不意味着多工具方案不好。
对清楚自己想用哪些工具的专业创作者来说,分开订阅能带来极大的灵活。
但如果你主要做完整音乐视频,值得比较的是整套工作流的总成本,而不只是某一次生成的价格。
问自己:
- •我会生成多少个镜头?
- •通常有多少需要重新生成?
- •我需要口型同步吗?
- •我需要 1080p 吗?
- •我每月做一支,还是好几支?
- •我是不是在为功能重叠的工具付钱?
- •我花了多少时间在平台之间搬运素材?
如果你在考虑一体化工作流,可以把当前的BeatViz 套餐与 Credits 选项,和你原本需要的那些独立工具做个对比。
为什么有些 AI 音乐视频看起来仍像随机 AI 片段
有更好的模型,并不会自动做出更好的音乐视频。
一支视频可以包含十个漂亮镜头,却仍然感觉互不相连。
以下是一些最常见的原因。
1. 角色漂移
歌手在每个场景里看起来都略有不同。
头发变了。
服装变了。
年龄变了。
最终观众不再看到一位表演者,而是看到一连串 AI 生成。
使用参考图,并在动画之前审阅首帧,可以减轻这个问题。
2. 每个场景都用完全不同的视觉风格
一个镜头是赛博朋克。
下一个是复古胶片。
然后是动漫。
然后是写实。
然后是奇幻城堡。
单个镜头也许很惊艳,但它们感觉不像同一支音乐视频。
生成之前,先选定一种视觉语言。
3. 画面无视歌曲结构
安静的主歌和爆发的最终副歌,不一定该有完全相同的节奏。
像音乐制作人思考编曲那样,去思考视觉能量。
把一些最强的镜头,留给歌曲里真正配得上它们的部分。
4. 每个镜头都想做到极致炫目
音乐视频也需要更安静的瞬间。
特写、简单的行走镜头、静止环境,以及克制的运镜,能让更大的视觉瞬间更有冲击力。
如果每五秒都有爆炸、变形、无人机运动、舞蹈段落和不可能的镜头环绕,就没有什么真正重要了。
5. 在不需要的地方使用口型同步
不是每一句歌词都需要歌手嘴巴的特写。
把表演画面和叙事镜头、环境空镜、细节以及视觉叙事混在一起。
6. 创作者在规划之前就开始生成
这大概是最贵的错误。
二十个随机片段,远比二十个为歌曲特定部分设计的片段更难剪成连贯视频。
若想更深入了解生成前如何规划视觉世界,请阅读如何用 AI 把音乐变成视频:完整指南。
示例:一首三分钟 YouTube 歌曲的实用 AI 音乐视频工作流
想象你已经完成了一首三分钟的流行曲目。
下面是一种实用的做法。
第一步:生成之前先听
标出:
- •前奏
- •主歌
- •副歌
- •桥段
- •尾奏
- •主要的音乐变化
第二步:定义一个视觉想法
例如:
一位歌手走过几乎空无一人的夜城。每一段副歌,同一条街道变得拥挤、彩色、充满生命。
这一句话,已经比生成十条互不相关的提示词更有用。
第三步:搭建视觉世界
选定:
- •一位主要表演者
- •两到三个反复出现的地点
- •服装造型
- •色彩语言
- •镜头风格
第四步:创建参考图和首帧
动画之前,先审阅脸、构图、服装和背景。
第五步:生成表演镜头和叙事镜头
不要用同一种方式生成每一个场景。
人声可以用特写,运动用中景,环境用全景,副歌附近用更短、更有动态的片段。
第六步:逐个修好薄弱镜头
如果 25 个片段能用、两个失败,就修那两个。
不要重建整支音乐视频。
第七步:组装,并对照歌曲审阅
从头到尾看完整支视频。
一个单独看起来惊艳的镜头,对这首音乐仍然可能是错的。
手动工具栈版本
创作者可以用这些工具来做这个项目:
ChatGPT → OpenArt/Midjourney/GPT Image → Kling/Veo/Runway → CapCut/Premiere
这能提供最大的灵活。
BeatViz 版本
或者,你可以从BeatViz Workflow或AI Director开始,让歌曲引导项目结构;当单个场景需要更直接的控制时,再进入Editor。
两种方式都不是对每个人都自动正确。
差别主要在于:你想自己连接制作管线的多少部分。
常见问题
YouTube 创作者做音乐视频都用什么 AI 工具?
没有单一的标准工具。许多创作者会组合好几款产品:Suno 或 Udio 做音乐,ChatGPT 做规划,OpenArt 或 Midjourney 这类图像生成器做角色和首帧,Kling、Veo、Runway 或 Wan 这类视频模型做画面,CapCut 或 Premiere Pro 这类剪辑软件做最终组装。
BeatViz 这类音乐优先平台,可以把更多制作阶段放进同一套工作流。
只用 Kling 够不够做出完整的 AI 音乐视频?
Kling 可以生成单个视频镜头,也可以成为音乐视频工作流里重要的一环,但完整音乐视频仍然需要规划、镜头筛选、与曲目同步、连贯性,以及最终组装。
如果你把 Kling 当作独立的生成工具来用,通常还需要和其他软件搭配。
做 AI 音乐视频还需要 CapCut 吗?
取决于工作流。
如果你用多个 AI 工具生成互不相干的片段,CapCut、Premiere Pro 或 DaVinci Resolve 这类剪辑软件,对排布和同步成片极为有用。
如果你使用带有自己的时间轴或组装工作流的音乐优先平台,也许可以在不切换到单独剪辑软件的情况下,完成项目的更多部分。
Suno 也能做音乐视频吗?
Suno 主要属于工作流里的音乐生成这一侧。
创作者通常会把完成的曲目带到单独的图像、视频或音乐视频生成工具里,去创建画面。
如果你走的是这条工作流,请阅读我们的指南:如何把 Suno 歌曲做成 AI 音乐视频。
做 YouTube 音乐视频,最好的 AI 工具栈是什么?
如果想要最大控制权,一套实用工具栈可以包括 AI 规划工具、图像生成器、高质量视频模型和专业剪辑软件。
对希望减少独立工具数量的创作者来说,音乐优先平台可能更高效。
正确选择取决于你最在意的是灵活、画面质量、速度、口型同步、长叙事,还是成本。
你也可以在我们的指南中对比不同的专用平台:适合创作者的最佳 AI 音乐视频生成器。
我该用文生视频,还是图生视频?
对以角色为主的音乐视频,图生视频通常更容易控制,因为起始帧已经确立了角色、服装、环境和构图。
文生视频适合环境、转场、实验场景,以及角色精确一致性没那么重要的镜头。
许多创作者会在同一个项目里两种都用。
一个 AI 平台能做出完整音乐视频吗?
可以。
音乐优先平台正越来越多地被设计成处理单个片段生成之外的更多事情。
例如,BeatViz 通过 Workflow、AI Director 和 Editor,把歌曲分析、创意规划、场景生成、首帧、视频生成和剪辑连在一起。
不过,人工审阅仍然重要。
最强的结果,通常来自审阅生成的场景、修好薄弱镜头,并做出创作决策,而不是自动接受每一个第一次结果。
最好的工具通常是一套工作流,而不是某一个模型
AI 视频变化很快。
今天能产出最惊艳镜头的模型,六个月后未必还是创作者的首选。
但底层的音乐视频工作流要稳定得多:
歌曲 → 导演 → 角色 → 场景 → 分镜 → 动态 → 表演 → 剪辑 → 成片
所以,按工具扮演的角色来选择,比追逐当下最火的 AI 模型更合理。
需要歌的时候,用 Suno 或 Udio。
需要确立角色和首帧时,用图像生成器。
需要单个镜头时,用 Kling、Veo、Runway、Wan 或其他强视频模型。
想亲手组装一切时,用 CapCut、Premiere Pro 或 DaVinci Resolve。
而如果你真正的目标不是「生成一段片段」,而是把完成的歌曲做成完整音乐视频,就用一套围绕歌曲本身搭建的工作流。
BeatViz 给了你三种做法:
想要引导式的全曲创作流程时,使用Workflow。
想通过对话发展和修改音乐视频时,使用AI Director。
想直接控制单个镜头和时间轴时,使用Editor。