YouTube 上的 AI 音樂影片,創作者都在用什麼工具?
在 YouTube 上看多了 AI 音樂影片,你可能也會開始想同一件事:
這些創作者到底在用什麼工具?
答案通常比「Kling」或「Runway」更復雜。
目前並沒有可靠的公開資料,能證明某一種 AI 工具包辦了 YouTube 上的大多數音樂影片。而在實際操作裡,很多創作者根本不是隻用一個工具。
他們用的是一套工具棧。
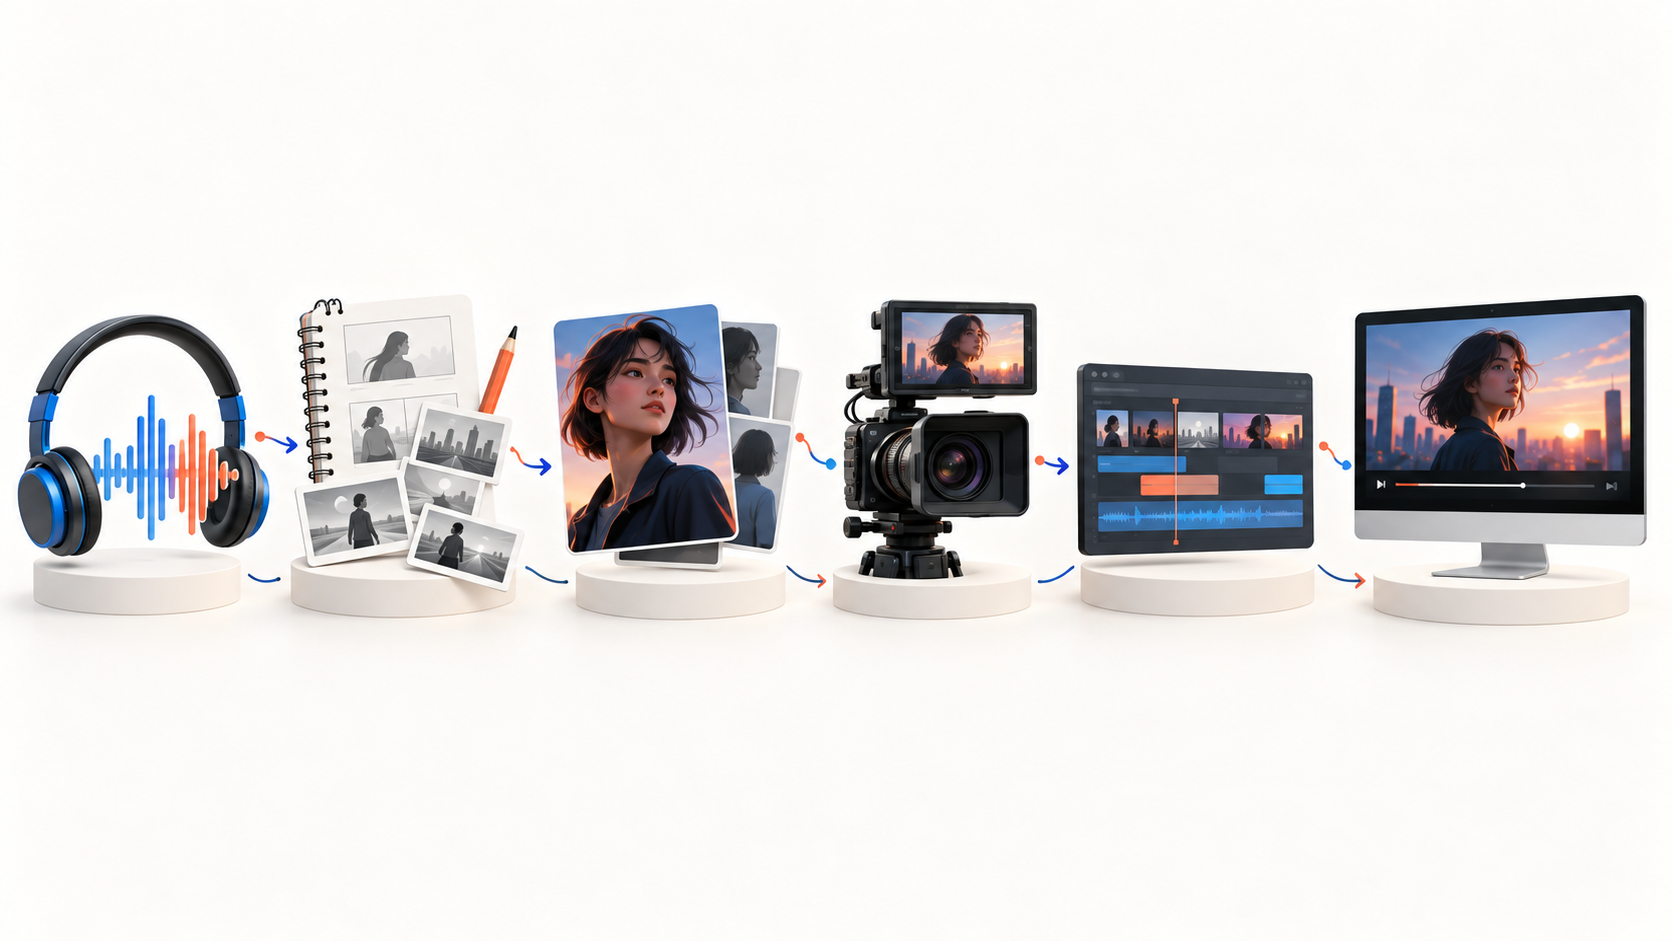
一個工具負責做歌。另一個幫忙發展視覺概念。影象生成器建立歌手或首幀。影片模型讓鏡頭動起來。再有一個工具處理口型同步。最後,一切會在 CapCut、Premiere Pro、DaVinci Resolve,或音樂優先的 AI 影片平臺裡組裝起來。
一套典型工作流可能是這樣的:
Suno → ChatGPT → OpenArt → Kling → CapCut
另一位創作者可能會用:
已有歌曲 → Midjourney → Veo → Premiere Pro
而想減少工具切換的人,可能會用音樂優先平臺,例如BeatViz AI 音樂影片生成器,在同一個相連專案裡完成更多規劃、場景生成和剪輯。
所以,這篇指南不會給十個工具排個名,然後假裝某一個「最好」。我們會拆開製作的每一個階段,看創作者分別用哪些 AI 音樂影片工具——以及每個工具真正在做什麼。
簡短回答:大多數 AI 音樂影片用的是一套工具棧
「AI 音樂影片工具」可以指完全不同的幾類產品。
一個能生成五秒漂亮電影感鏡頭的工具,和一套能分析三分鐘歌曲、規劃場景、同步剪輯並匯出成片的軟體,做的根本不是同一件事。
這個區別很重要。
一套實用的 AI 音樂影片工作流,往往包含下面這些階段中的若干環:
| 階段 | 創作者需要什麼 | 常見工具型別 |
|---|---|---|
| 音樂 | 創作或完成歌曲 | Suno、Udio、DAW |
| 規劃 | 故事、視覺概念、分鏡想法 | ChatGPT 及其他大語言模型 |
| 角色與首幀 | 一致的人物、地點、首幀 | OpenArt、Midjourney、GPT Image 及其他影象生成器 |
| 影片生成 | 把影象或提示詞變成動態鏡頭 | Kling、Veo、Runway、Wan 及類似影片模型 |
| 表演 | 演唱、口型同步、舞蹈、樂器表演 | 影片模型和專門的口型同步工作流 |
| 剪輯 | 排布鏡頭、同步音樂、剪掉薄弱場景 | CapCut、Premiere Pro、DaVinci Resolve |
| 完整音樂影片工作流 | 把其中多個階段連起來 | BeatViz 及其他音樂優先平臺 |
這也解釋了,為什麼問「這支音樂影片是哪個 AI 生成的?」往往沒有簡單答案。
一支三分鐘的影片,可能包含好幾個不同模型產出的鏡頭。
最終效果不取決於某一個神奇模型,而取決於創作者如何把這些工具連起來。
1. 音樂生成:許多 AI 音樂影片的起點
對一部分創作者來說,音樂已經有了。
對另一部分人來說,在生成任何一幀影片之前,AI 就已經介入了。
Suno
Suno 已經成為許多創作者嘗試 AI 生成歌曲時熟悉的起點。創作者可以在這裡發展歌詞、曲風方向、人聲和完成的曲目,再把音訊帶進另一套視覺工作流。
這就是為什麼你經常會在 AI 音樂影片教程的開頭看到 Suno,而不是在影片生成那個階段。
關鍵區別在於:
做歌和做音樂影片,是兩件不同的製作問題。
歌做完之後,創作者仍然需要決定它該長什麼樣。
如果你的歌從 Suno 開始,請閱讀我們的指南:如何把 Suno 歌曲做成 AI 音樂影片,裡面更詳細地講解了這一步過渡。
Udio
Udio 在更廣泛的 AI 音樂生態裡扮演類似角色。
創作者可能在那裡生成歌曲,匯出完成的音訊,再進入視覺規劃和影片製作。
如果你已經有自己的歌呢?
那你可以完全跳過 AI 音樂生成這一步。
對已經有完成曲目的音樂人、製作人、唱片公司或藝人來說,真正的工作流從這裡開始:
歌曲 → 視覺概念
這聽起來很顯然,但它會改變你真正需要哪些工具。
如果你的目標只是把已有曲目視覺化,再去付費訂閱另一個音樂生成平臺,對工作流可能毫無幫助。
2. 生成片段之前,先規劃音樂影片
這是 AI 影片創作裡最不炫的部分之一——也是最重要的部分之一。
很多 AI 音樂影片看起來弱,並不是因為影片模型差。
真正的原因是:從來沒有一個清晰的視覺計劃。
在把 Credits 花在影片生成上之前,創作者常常會用 ChatGPT 或其他語言模型來回答這些問題:
- •主角是誰?
- •影片發生在哪裡?
- •副歌時應該發生什麼?
- •哪些視覺元素應當重複出現?
- •哪些段落需要表演鏡頭?
- •影片該在哪裡放慢?
- •運鏡該在哪裡變得更有能量?
- •第一段主歌和第二段主歌之間,有什麼變化?
例如,不要立刻提示:
霓虹城市裡一個女人在唱歌。
創作者可能先定義:
一位孤獨的女歌手,在主歌裡走過午夜後安靜的東京街道。每一段副歌都進入擁擠的霓虹街機廳,世界變得更亮、更有能量。最終副歌發生在日出時的屋頂。
現在,影片有了視覺結構。
單個提示詞會好寫得多,因為每一個鏡頭都屬於同一個想法。
把歌曲結構變成分鏡結構
聽整首歌,標出主要段落:
前奏 → 主歌 → 預副歌 → 副歌 → 主歌 → 副歌 → 橋段 → 最終副歌
然後問:它們之間,畫面上該發生什麼變化。
你不需要每五秒換一個全新地點。
事實上,重複幾個有力的地點,往往讓音樂影片更有意圖。
副歌回到同一個舞臺、俱樂部、屋頂、公寓或表演環境,能形成視覺身份,而不是讓重複聽起來像侷限。
先規劃,也能省錢。
一個糟糕的想法還只是一句話時就否掉它,遠比從它生成二十個影片片段之後再否掉便宜得多。
3. 建立角色和首幀
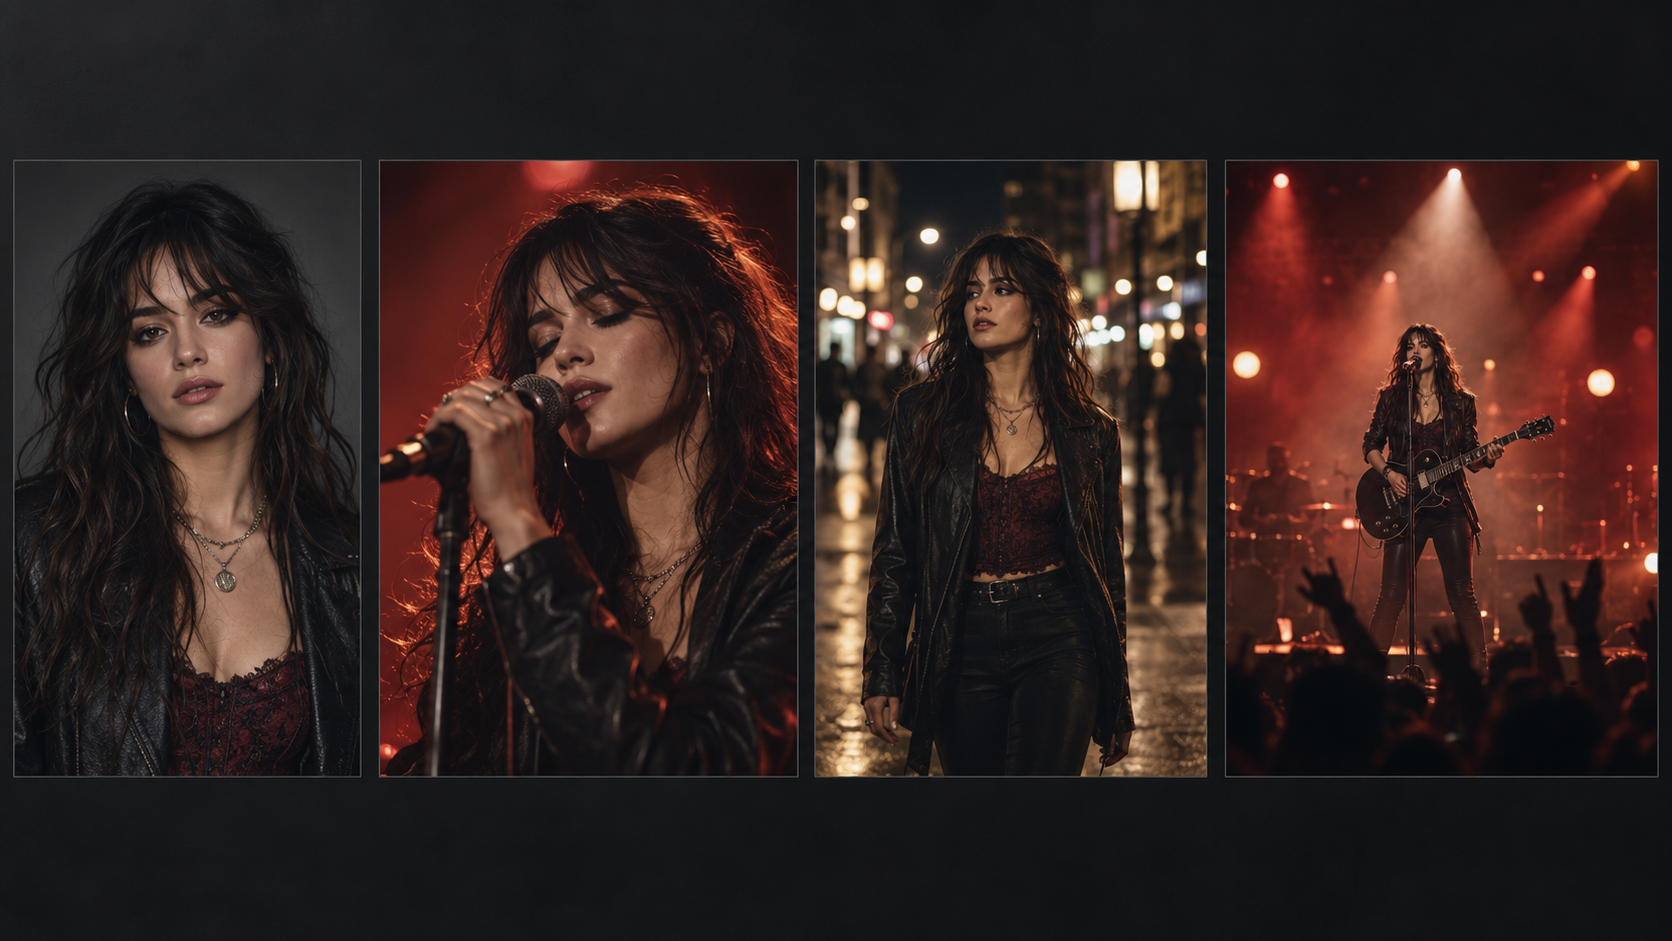
創意方向清楚之後,許多創作者會在影片生成之前先做影象生成。
這就是為什麼 OpenArt、Midjourney、GPT Image 以及類似模型,會頻繁出現在 AI 音樂影片工作流裡。
目標不一定是做出完成的藝術品。
這張圖,往往成為影片模型的視覺基準。
為什麼圖生影片如此常見
想象一下,你希望同一位女表演者出現在十個場景裡。
如果用文生影片,每一次新生成都得重新理解這樣的描述:
24 歲女性,黑色長髮,紅色皮夾克,銀色項鍊……
即使提示詞很詳細,臉、頭髮、服裝和身體比例仍然可能漂移。
一張參考圖,能給影片模型更多可依據的視覺資訊。
因此,一套實用工作流可能是:
- 1.設計角色。
- 2.把第一個場景生成為靜幀。
- 3.檢查臉、服裝、地點、光線和鏡頭角度。
- 4.如果有問題,先修好靜幀。
- 5.然後再讓它動起來。
這對音樂影片尤其有用,因為影片生成往往是更貴的階段之一。
如果首幀裡已經是錯的人、錯的造型或錯的構圖,把它變成一段八秒影片,很少能把這個問題修好。
4. 許多 YouTube 音樂影片背後的 AI 影片模型
現在才輪到人們通常最先想到的那些工具。
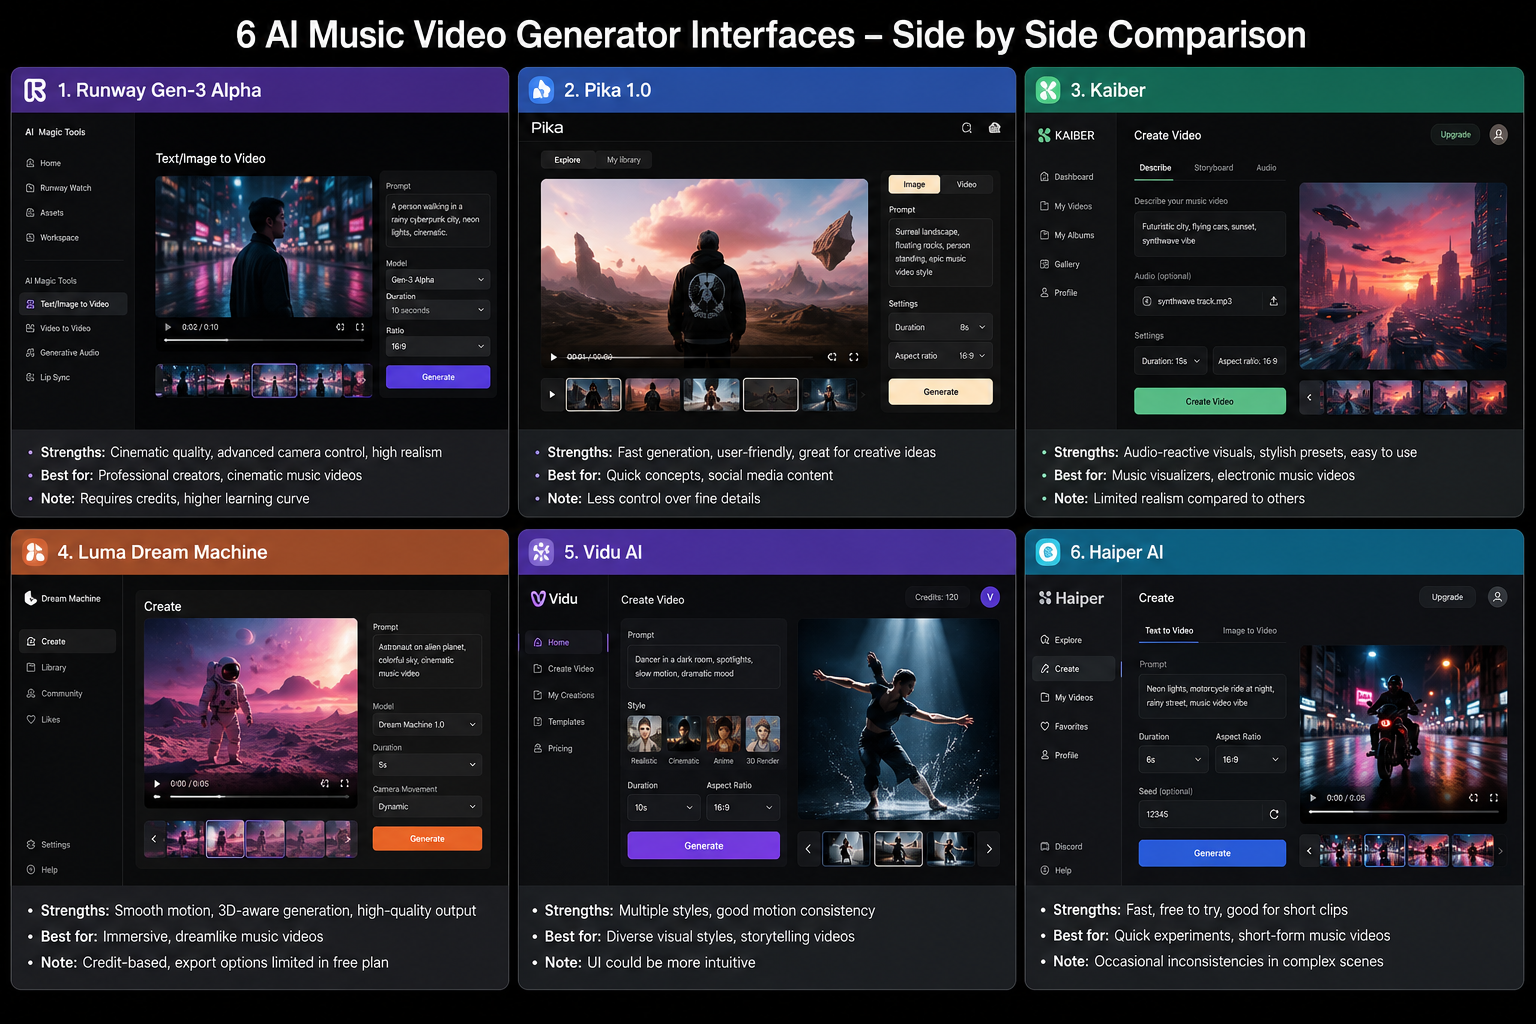
Kling。Veo。Runway。Wan。以及越來越多其他影片模型。
這些工具能做出令人印象深刻的畫面,但通常應當把它們想成鏡頭生成器,而不是自動當成完整的音樂影片製作系統。
Kling
Kling 經常出現在創作者的工作流裡,用於圖生影片、電影感運動、表演鏡頭和以角色為主的場景。
創作者可能在別處生成角色圖,匯入 Kling,生成五秒或八秒動畫,下載結果,再對下一個場景重複這個過程。
這可以非常有效。
代價是管理成本。
一首三分鐘的歌可能需要幾十個可用片段,而每一次生成最終都要找到它在成片時間軸上的正確位置。
Google Veo
當畫面質感和電影感生成很重要時,Veo 是創作者會考慮的另一個選項。
對音樂影片來說,高質量模型尤其適合核心鏡頭:
- •戲劇性的建立鏡頭
- •表演特寫
- •大型電影感環境
- •視覺上關鍵的副歌瞬間
但同樣,一個漂亮鏡頭只是音樂影片的一部分。
歌曲仍然需要結構、節奏、連貫性和剪輯。
Runway
對已經習慣以電影人或剪輯師方式思考的創作者來說,Runway 往往很有吸引力。
當你想產出單段素材,並保留更多控制權,決定這些素材如何進入更完整的製作流程時,它會很有用。
這對已經計劃在剪輯軟體裡完成專案的創作者來說很合理。
Wan 和其他影片模型
可用的 AI 影片模型名單變化很快。
這也是不要把整套工作流綁在某一個模型名字上的另一個原因。
今天最適合某一種運動的模型,之後可能被更強的選項取代。
更好的問題是:
這個鏡頭需要完成什麼任務?
也許一個模型給你更好的運鏡。
另一個更擅長特寫。
再一個能做出更可信的舞蹈。
還有一個對轉場場景更划算。
有經驗的創作者越來越像電影人對待鏡頭或攝影機那樣對待 AI 影片模型:
為這個鏡頭選對的那一個。
5. 口型同步、演唱、舞蹈和表演鏡頭
一個人走在街上的電影感鏡頭,對錯誤相對寬容。
歌手唱副歌的特寫,則不是。
一旦角色需要唱歌、說話、跳舞或演奏樂器,觀眾對錯誤會敏感得多。
口型同步會改變難度
一個有說服力的表演鏡頭,需要的不只是大概對上的嘴部運動。
觀眾同時在看:
- •口型
- •時機
- •面部表情
- •頭部運動
- •眼睛運動
- •呼吸
- •肢體語言
如果嘴在技術上跟著歌詞動,臉卻像凍住了,表演仍然會顯得假。
這就是為什麼有些 AI 音樂影片工作流會分開處理:
電影感空鏡
和
表演鏡頭
創作者不會給每個場景都做口型同步,而是把演唱特寫留給最重要的人聲段落,其他地方用敘事或氛圍鏡頭。
樂器會帶來另一個一致性問題
如果歌手拿著吉他、彈鋼琴、打鼓,或與另一位表演者互動,手和物體的互動就成了鏡頭的一部分。
對這類場景,更簡單的構圖往往能產出更強的結果。
一個吉他手的中景,通常比三位樂手一邊做複雜編舞、一邊讓鏡頭繞著他們轉,更容易控制。
AI 影片進步很快,但好的導演仍然重要。
6. 為什麼 CapCut、Premiere Pro 和 DaVinci Resolve 仍會出現在 AI 工作流裡
如果 AI 能生成影片,為什麼創作者還要開啟傳統剪輯軟體?
因為生成和剪輯是不同的工作。
假設你為一首三分鐘的歌生成了 35 個片段。
有些非常出色。
有些還能用。
三個完全不能用。
好幾個稍微太長。
副歌需要更快的剪輯。
一個表演鏡頭應該晚兩秒開始。
這是剪輯問題。
CapCut、Adobe Premiere Pro 和 DaVinci Resolve 這類工具,常被用來:
- •把片段對上最終音訊
- •剪掉生成瑕疵
- •把鏡頭移到正確的音樂段落
- •控制節奏
- •替換薄弱片段
- •加轉場
- •統一鏡頭色彩
- •加標題或字幕
- •準備最終匯出
因此,常見的創作者工作流並不是:
提示詞 → 完整音樂影片
而更接近:
生成 → 審閱 → 篩選 → 重新生成 → 剪輯 → 匯出
這也是為什麼公開教程仍然經常展示 Suno + Kling + CapCut 這樣的組合,而不是從頭到尾只靠一個生成工具。
BeatViz 在 YouTube AI 音樂影片工具棧裡的位置
多工具工作流有一個主要優勢:
靈活。
幾乎每一項任務,你都可以選不同的工具。
但這種靈活,會帶來一次次交接。
- •在一個平臺生成影象。
- •下載。
- •上傳到影片模型。
- •生成片段。
- •下載片段。
- •重新命名。
- •上傳到剪輯軟體。
- •在歌裡找到正確位置。
- •重複。
這套工作流完全說得通——尤其適合享受親手控制製作每一環的創作者。
但它不是唯一選項。
BeatViz從相反的方向處理這個問題:
從音樂影片專案開始,再圍繞歌曲連線各個生成階段。
BeatViz Workflow:一步步搭建完整音樂影片
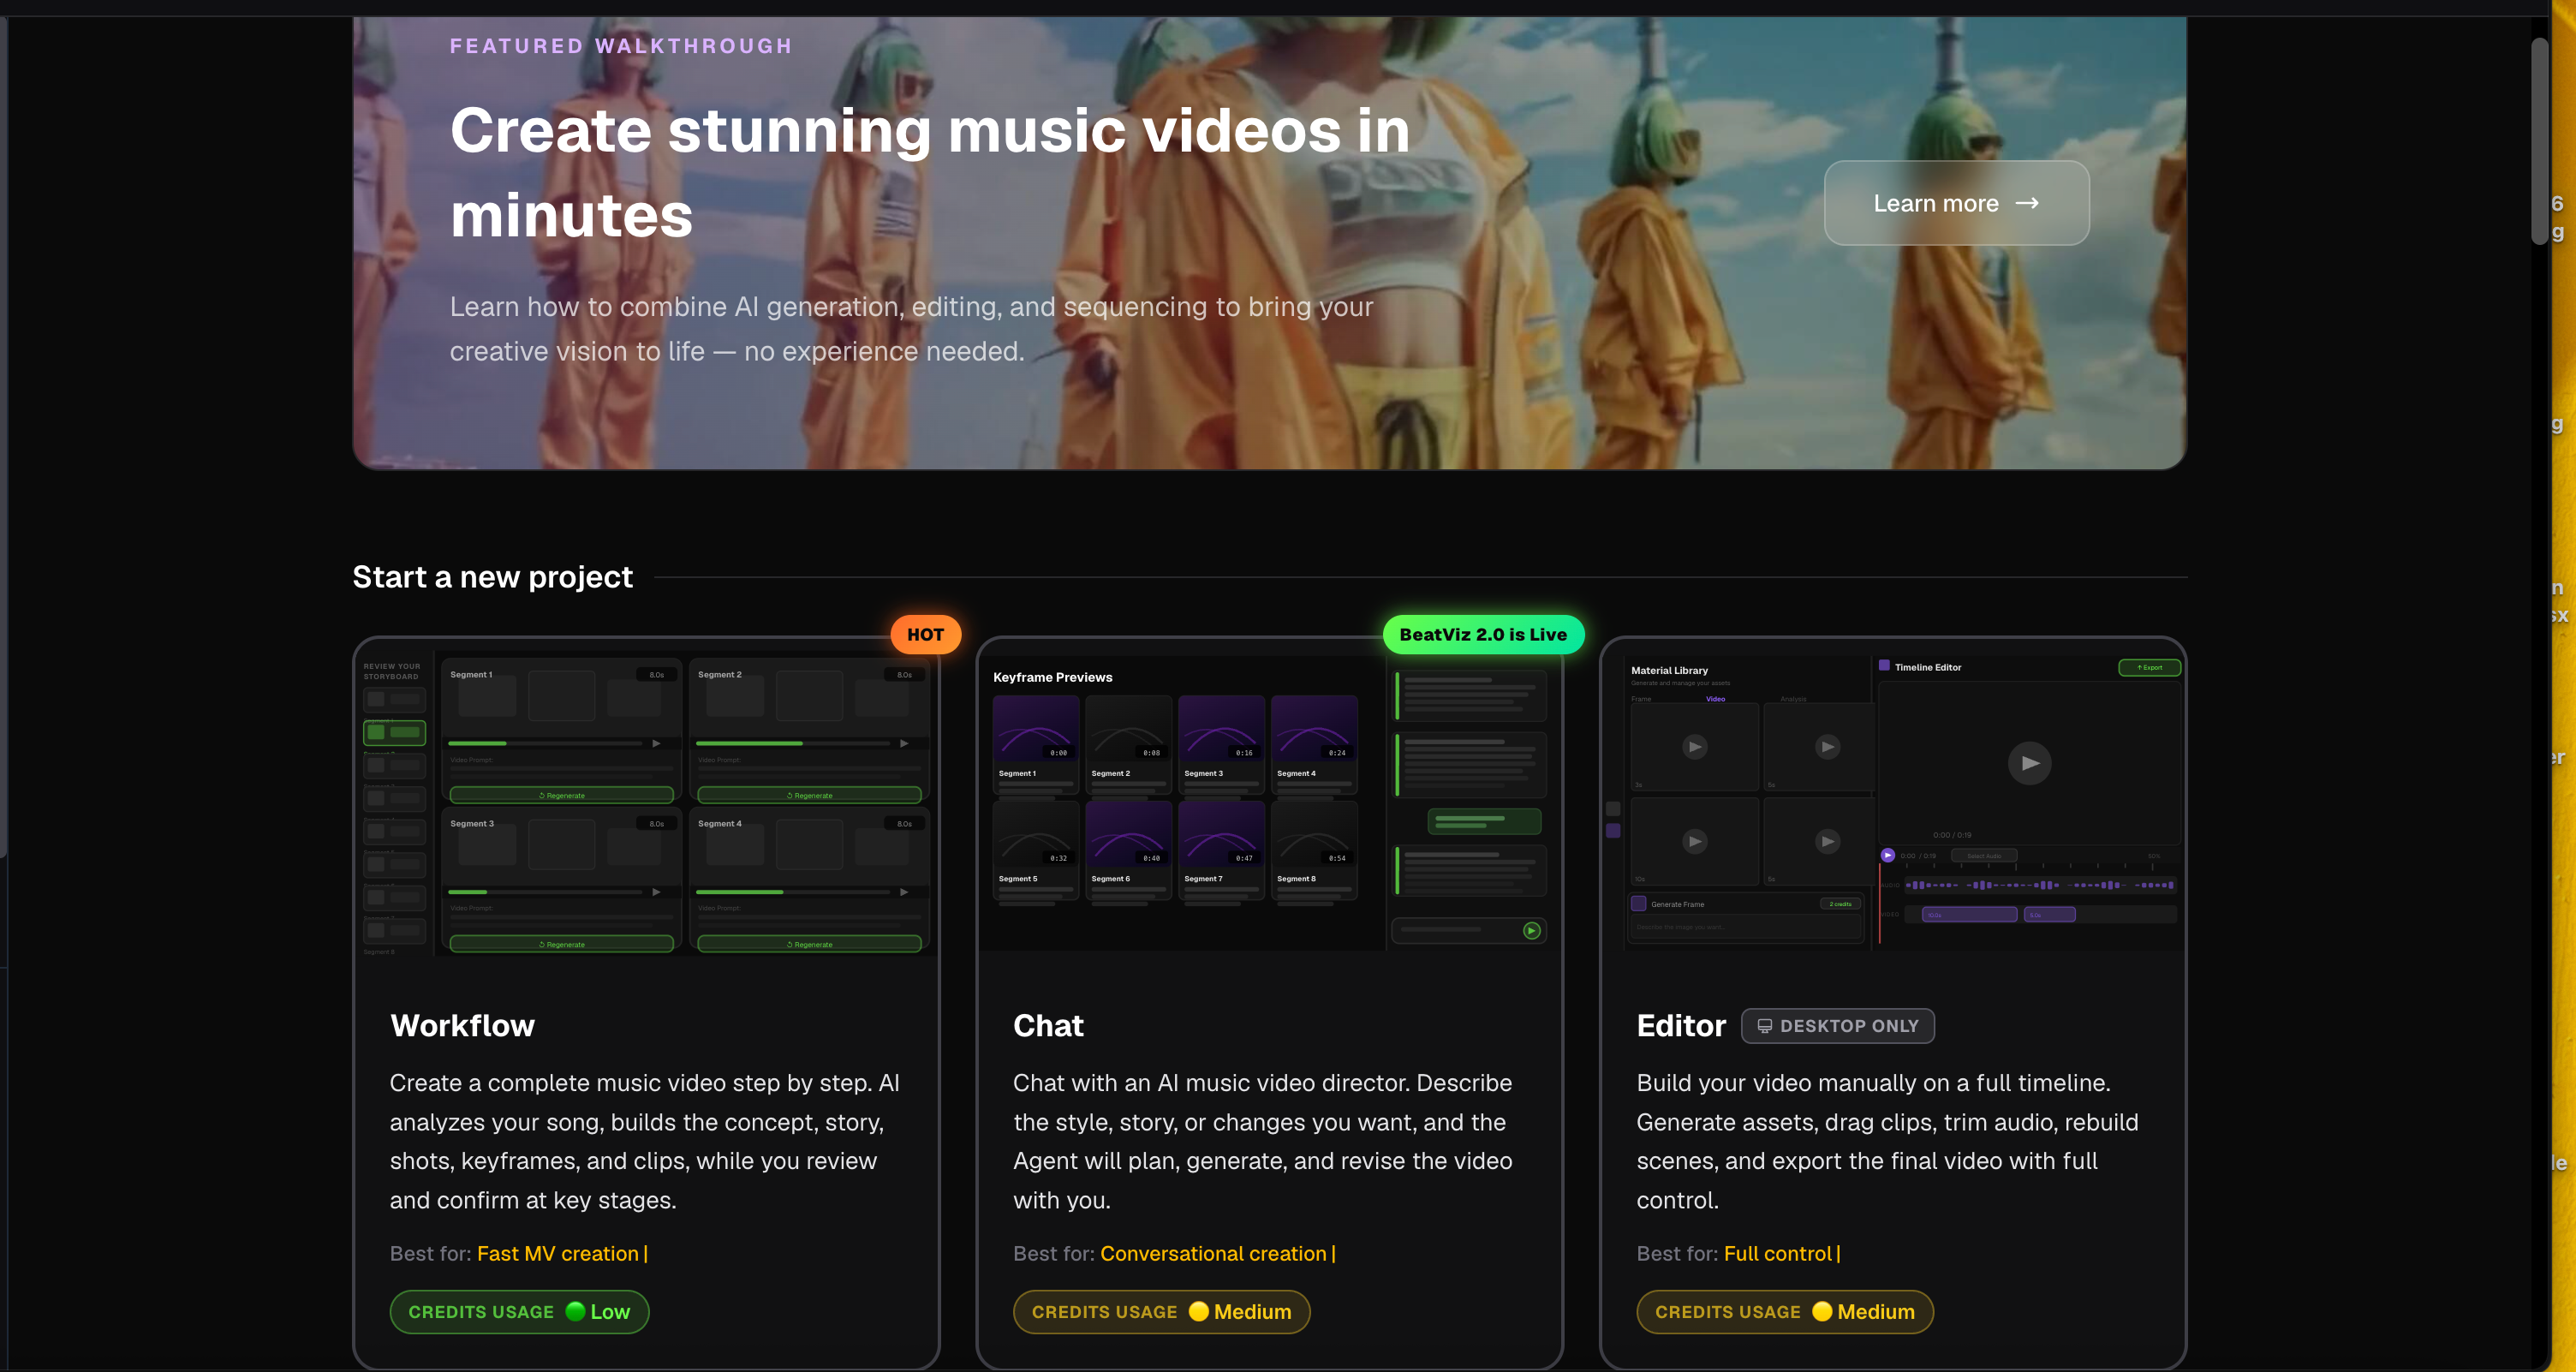
BeatViz Workflow適合歌曲已經完成、你希望 AI 幫你搭建完整製作結構的情況。
不必從空白時間軸手動建立每一個片段,流程可以走過:
音樂分析 → 視覺方向 → 故事 → 場景 → 分鏡 → 首幀 → 影片 → 最終組裝
重要的是,你可以在昂貴的影片生成階段之前,先審閱關鍵決策。
這對更長的音樂影片尤其有用,因為管理幾十個互不相干的素材會變得很難。
你可以把它理解成引導式選項。
BeatViz AI Director:當你想透過對話來導演
有時你不想要固定的操作順序。
你想說:
讓第二段副歌更有能量。
或者:
把這個場景從公寓改到夜間屋頂。
或者:
保持同一位歌手,但把這個改成特寫,鏡頭緩緩推進。
這正是BeatViz AI Director的設計出發點。
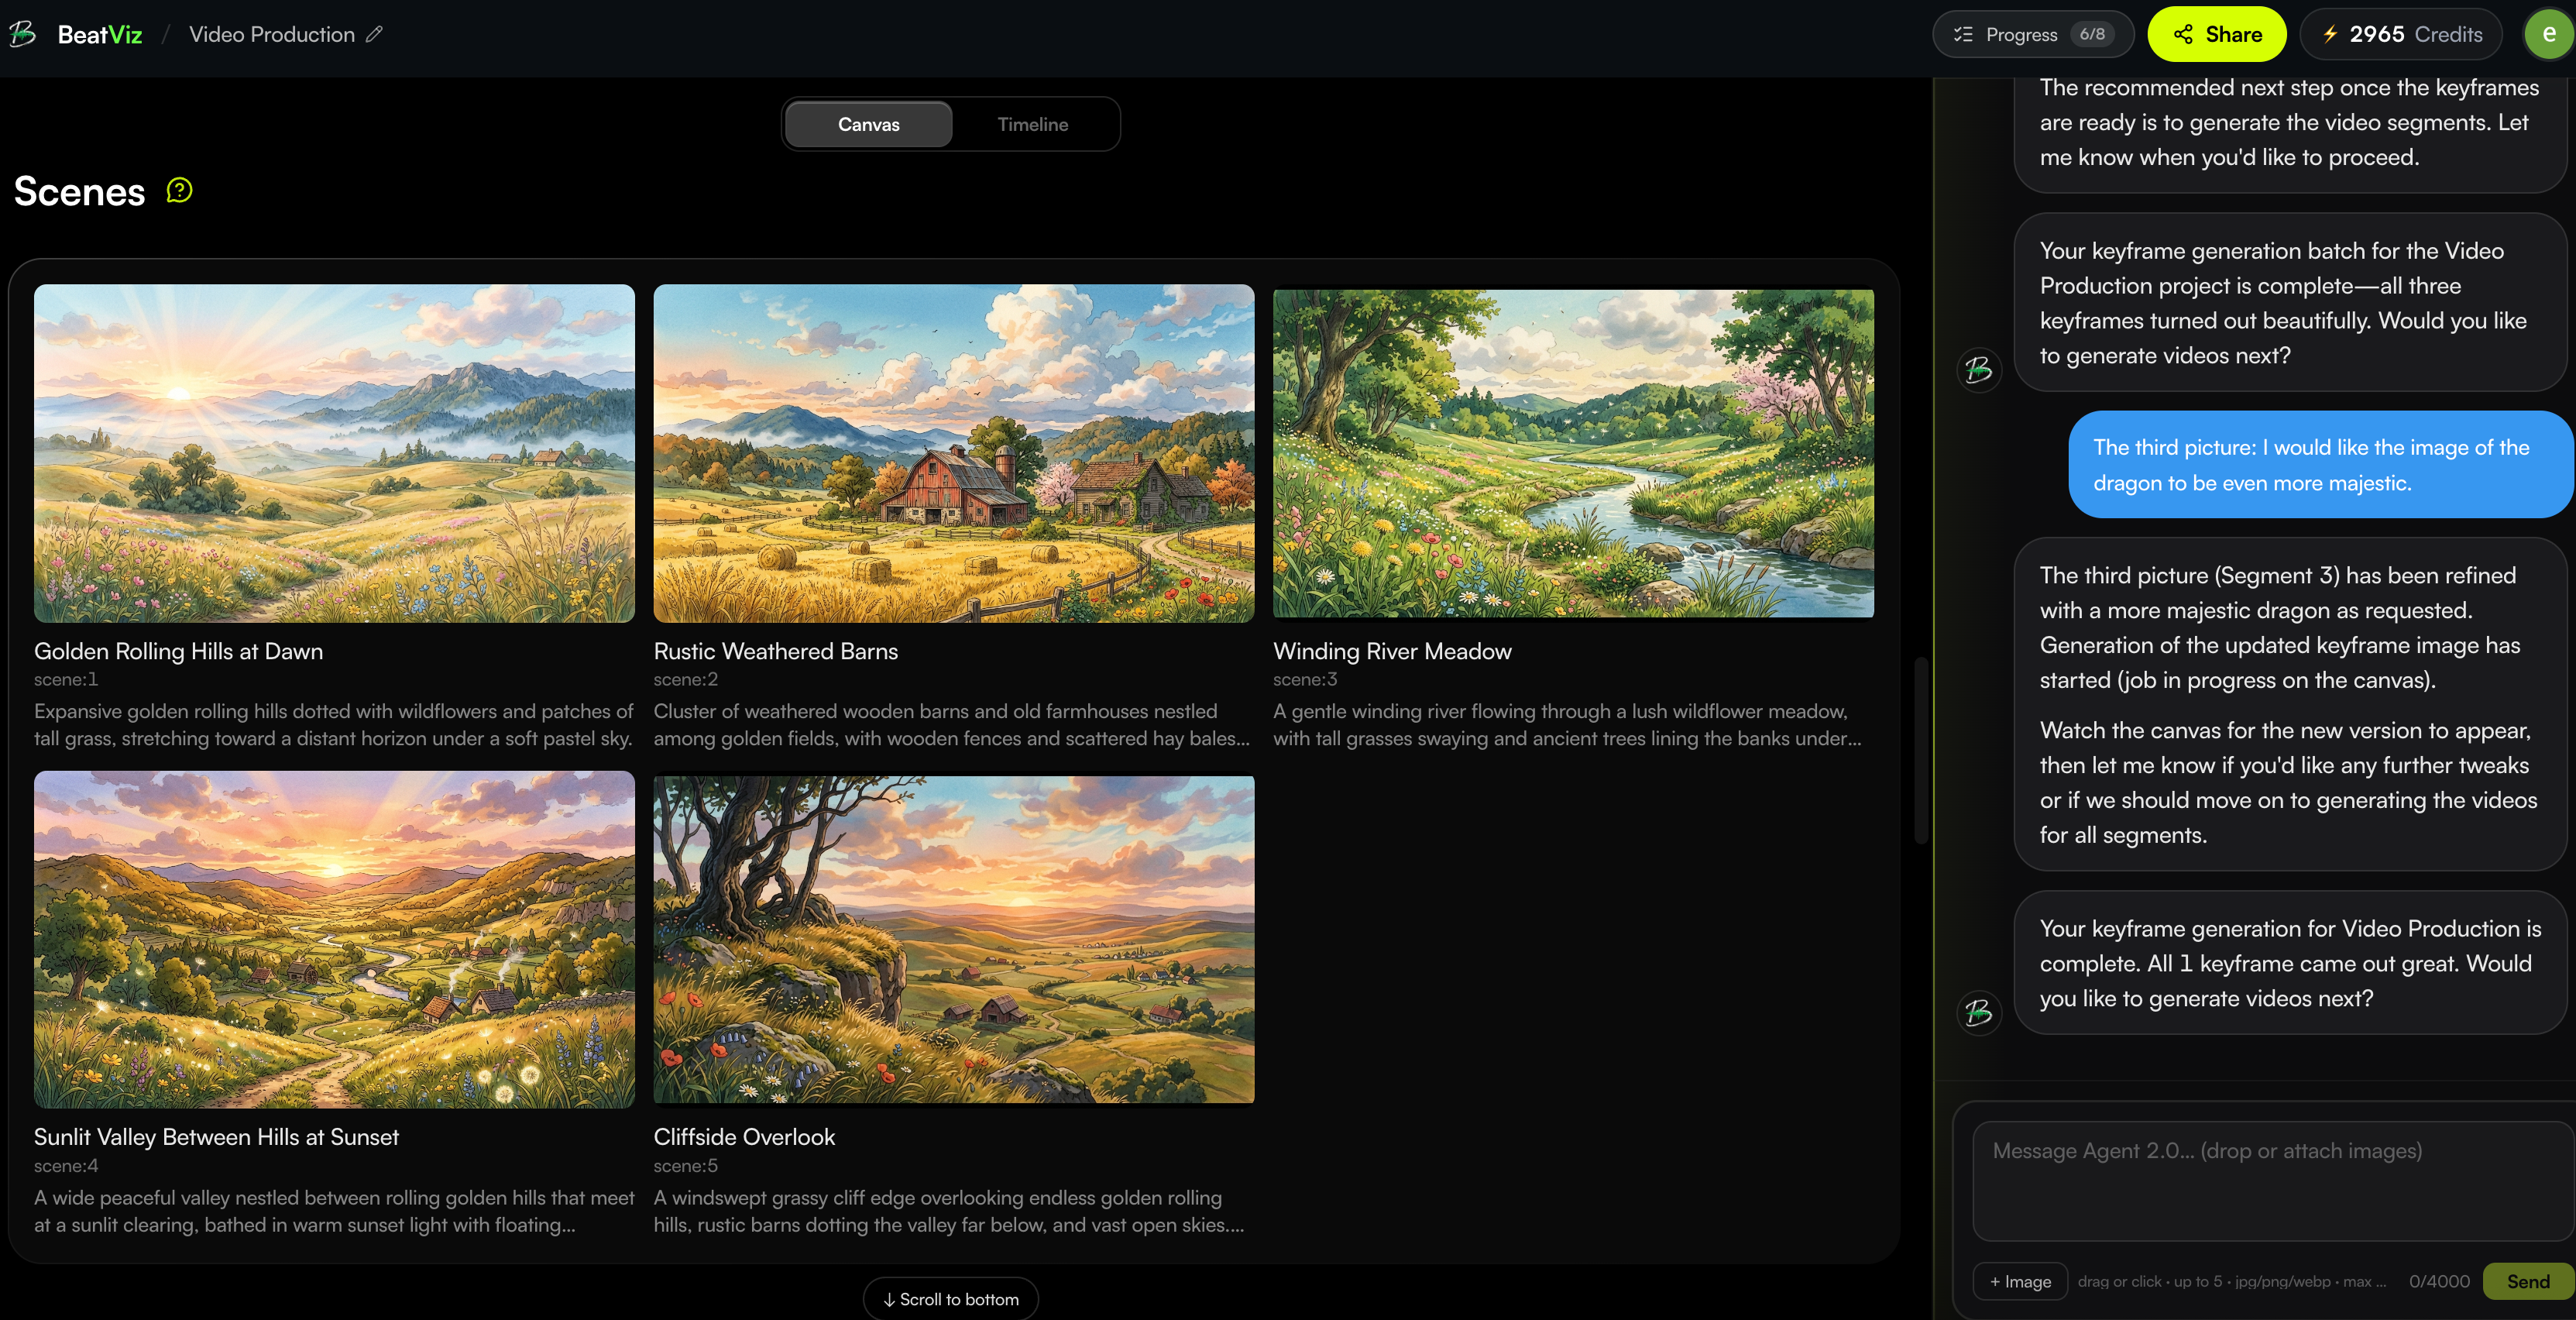
你上傳音樂,透過對話和 AI 一起發展視覺計劃,並隨著想法演變不斷精修專案。
這很重要,因為真正的創作指導很少發生在一條完美提示詞裡。
你做一個決定。
你看結果。
你調整它。
然後繼續。
BeatViz Editor:當單個鏡頭需要更多控制
自動化可以幫你拿到一版有力的初剪。
但最終你可能只想修好某一個場景,而不重建整個專案。
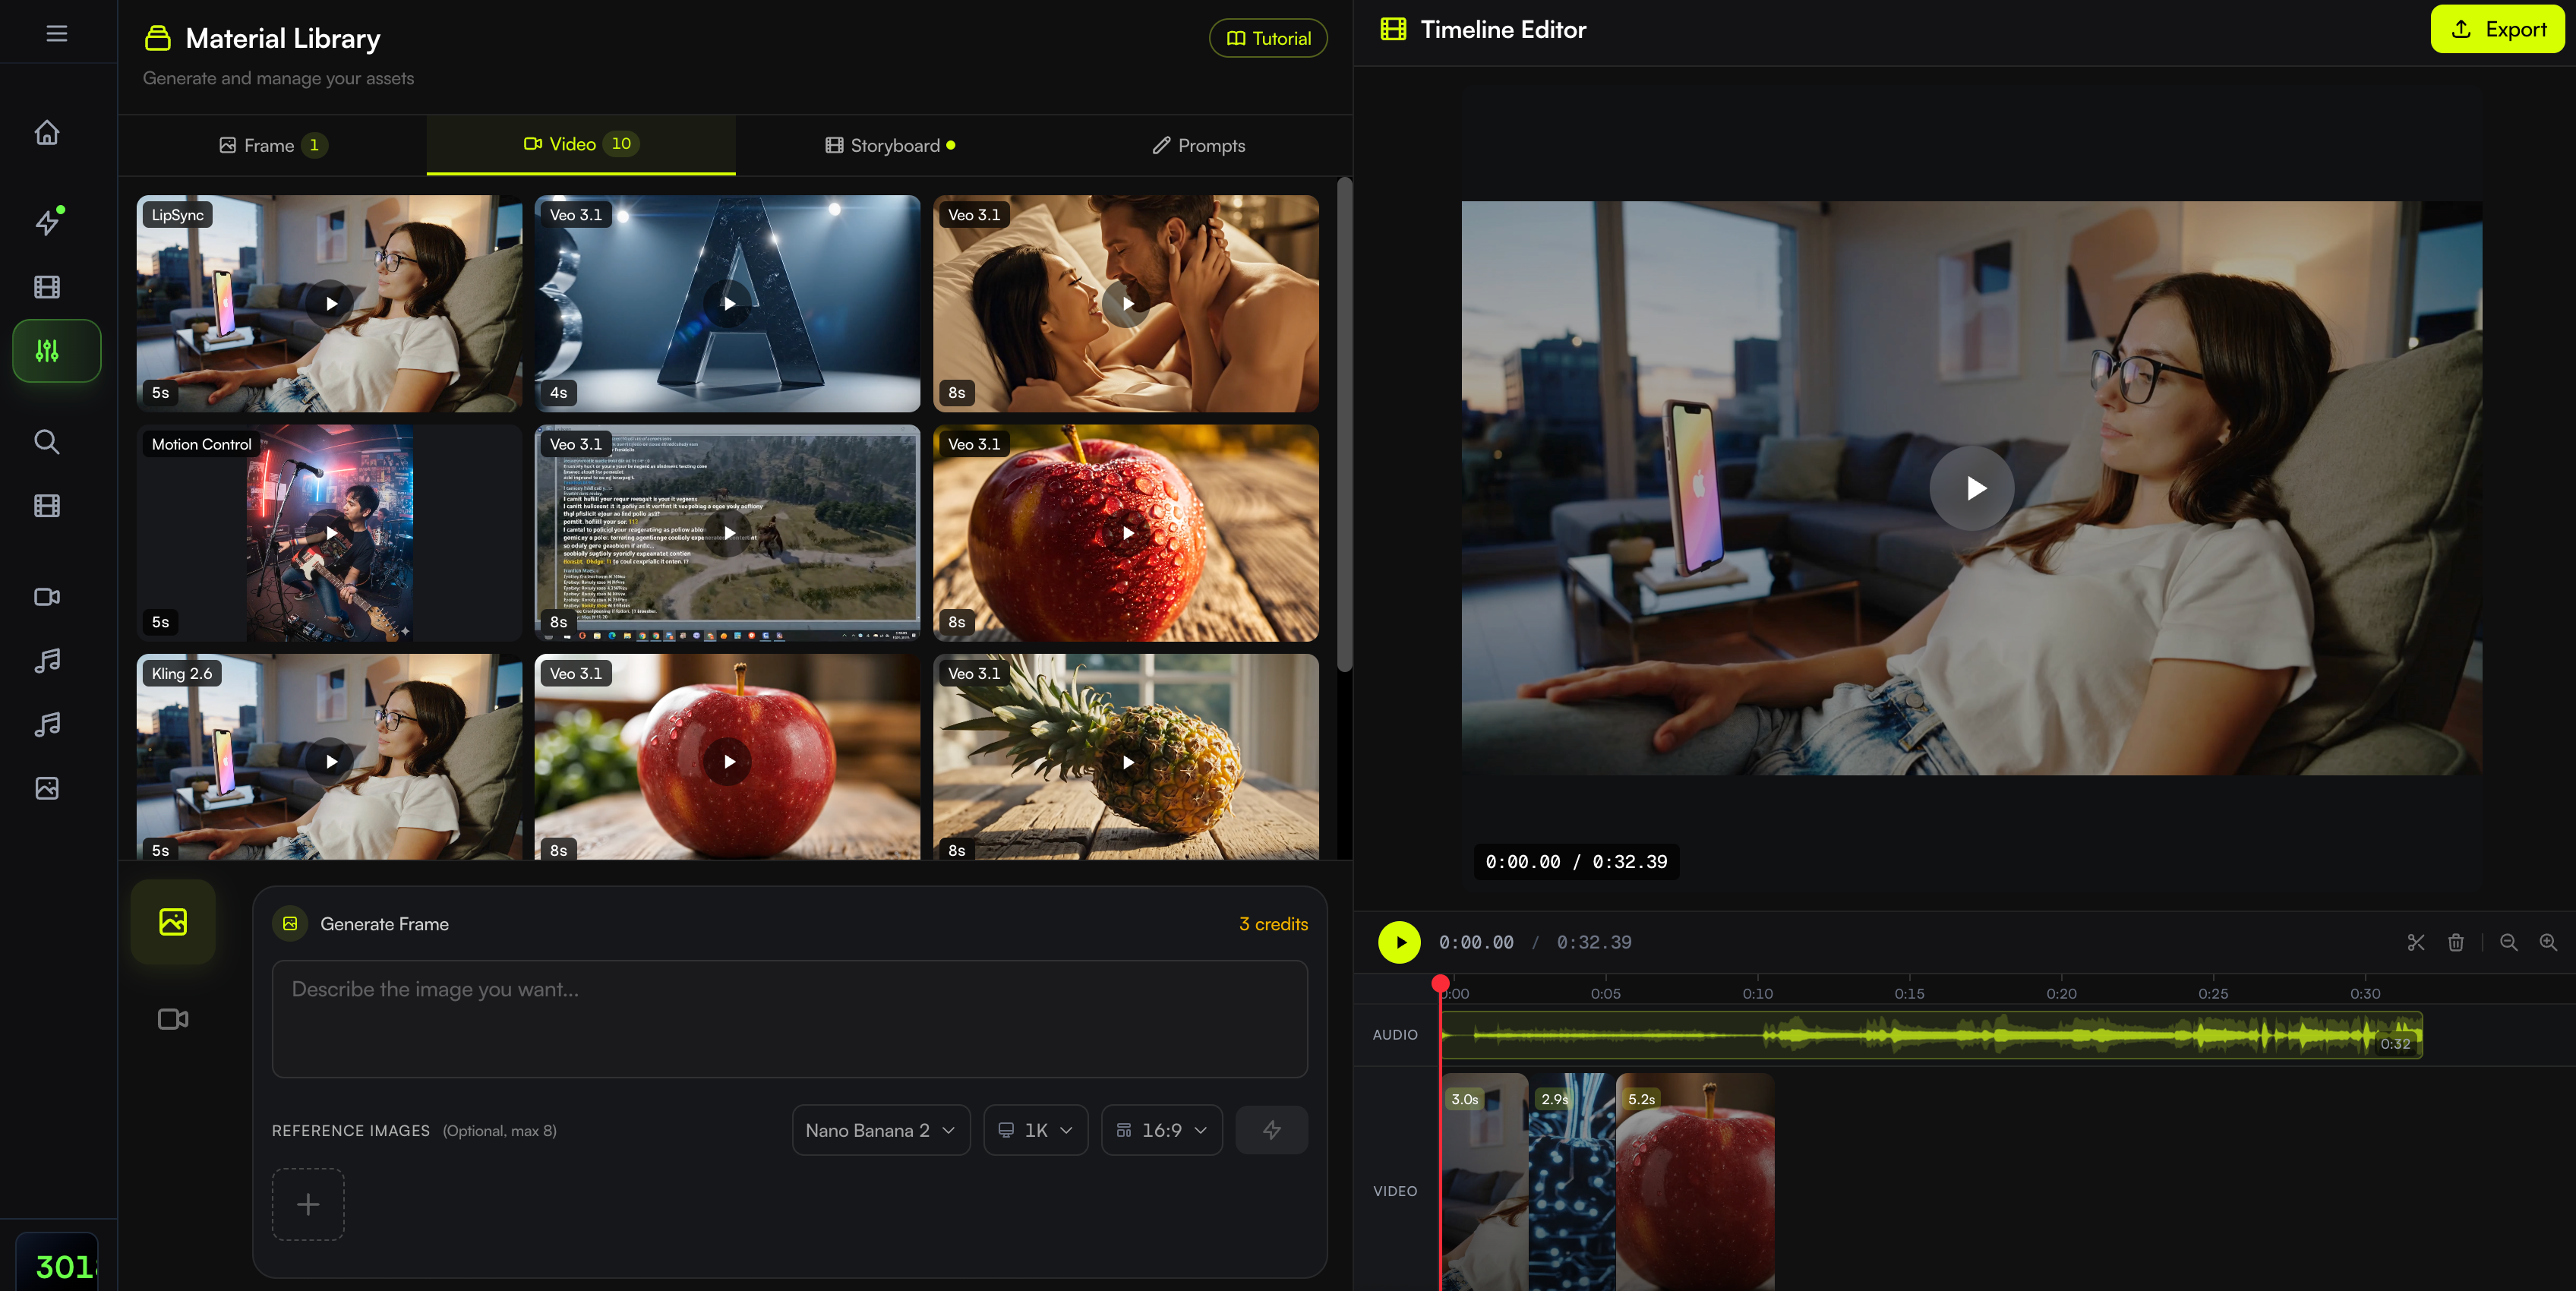
BeatViz Editor則是更偏手動的選項。
它把生成和時間軸工作區結合在一起,讓你可以處理單個場景和片段。
在這些情況下它會很有用:
- •需要替換某一張首幀
- •某個表演鏡頭需要口型同步
- •某個場景需要換一個影片模型
- •某個片段需要重新生成
- •時機需要調整
- •你想對最終序列有更多控制
理解這三種模式的一個有用方式是:
Workflow 幫你搭建制作。
AI Director 幫你導演製作。
Editor 幫你精修製作。
你該用哪套 AI 音樂影片配置?
沒有一套對所有人都正確的工具棧。
合適的配置,取決於你想要多少控制權,以及你最在意流程的哪一部分。
如果你想要最大限度的手動控制
把工具拆開用。
例如這樣的工作流:
ChatGPT → 影象生成器 → Kling/Veo/Runway → Premiere Pro 或 CapCut
讓你可以為每一個階段選擇確切的模型。
代價是更多檔案管理和更多手動剪輯。
如果你主要想要電影感核心鏡頭
把預算集中在一個強的通用影片模型上。
用 Kling、Veo、Runway,或當前最匹配你視覺方向的模型,少生成、生成得更好,再手動組裝這些鏡頭。
如果你已經會剪輯,這種方式尤其有效。
如果你想要抽象或強音訊響應的視覺
Neural Frames 這類音樂專用工具,可能比傳統的角色驅動工作流更合適。
不是每支音樂影片都需要歌手或故事。
電子、氛圍、迷幻和實驗曲目,可以從直接響應音樂的視覺中獲益。
如果歌已經做完,你想要一支完整音樂影片
這時,音樂優先的工作流會更有用。
不要想:
下一個五秒該用哪個模型生成?
而是想:
第二段副歌時該發生什麼?
這個差別聽起來很小,卻會改變整套工作流。
BeatViz 這類平臺,就是圍繞第二個問題來建的。
如果影片主要是表演
優先考慮:
- •角色一致性
- •可信的口型同步
- •面部表情
- •樂器互動
- •時間軸控制
如果歌手的臉在鏡頭切換之間變了,再壯觀的環境也救不了一個表演鏡頭。
若想了解如何搭建整體制作,而不是挑選單個模型,請閱讀我們的指南:如何製作音樂影片:音樂人分步指南。
做一支音樂影片,需要訂五份不同的 AI 訂閱嗎?
不一定。
但這是初學者有時會忽略的一項重要成本。
一套手動工具棧,可能需要分別支付:
- •AI 音樂生成
- •影象生成器
- •一個或多個影片模型
- •口型同步工具
- •剪輯軟體
- •鏡頭失敗時的額外生成
這並不意味著多工具方案不好。
對清楚自己想用哪些工具的專業創作者來說,分開訂閱能帶來極大的靈活。
但如果你主要做完整音樂影片,值得比較的是整套工作流的總成本,而不只是某一次生成的價格。
問自己:
- •我會生成多少個鏡頭?
- •通常有多少需要重新生成?
- •我需要口型同步嗎?
- •我需要 1080p 嗎?
- •我每月做一支,還是好幾支?
- •我是不是在為功能重疊的工具付錢?
- •我花了多少時間在平臺之間搬運素材?
如果你在考慮一體化工作流,可以把當前的BeatViz 套餐與 Credits 選項,和你原本需要的那些獨立工具做個對比。
為什麼有些 AI 音樂影片看起來仍像隨機 AI 片段
有更好的模型,並不會自動做出更好的音樂影片。
一支影片可以包含十個漂亮鏡頭,卻仍然感覺互不相連。
以下是一些最常見的原因。
1. 角色漂移
歌手在每個場景裡看起來都略有不同。
頭髮變了。
服裝變了。
年齡變了。
最終觀眾不再看到一位表演者,而是看到一連串 AI 生成。
使用參考圖,並在動畫之前審閱首幀,可以減輕這個問題。
2. 每個場景都用完全不同的視覺風格
一個鏡頭是賽博朋克。
下一個是復古膠片。
然後是動漫。
然後是寫實。
然後是奇幻城堡。
單個鏡頭也許很驚豔,但它們感覺不像同一支音樂影片。
生成之前,先選定一種視覺語言。
3. 畫面無視歌曲結構
安靜的主歌和爆發的最終副歌,不一定該有完全相同的節奏。
像音樂製作人思考編曲那樣,去思考視覺能量。
把一些最強的鏡頭,留給歌曲裡真正配得上它們的部分。
4. 每個鏡頭都想做到極致炫目
音樂影片也需要更安靜的瞬間。
特寫、簡單的行走鏡頭、靜止環境,以及剋制的運鏡,能讓更大的視覺瞬間更有衝擊力。
如果每五秒都有爆炸、變形、無人機運動、舞蹈段落和不可能的鏡頭環繞,就沒有什麼真正重要了。
5. 在不需要的地方使用口型同步
不是每一句歌詞都需要歌手嘴巴的特寫。
把表演畫面和敘事鏡頭、環境空鏡、細節以及視覺敘事混在一起。
6. 創作者在規劃之前就開始生成
這大概是最貴的錯誤。
二十個隨機片段,遠比二十個為歌曲特定部分設計的片段更難剪成連貫影片。
若想更深入瞭解生成前如何規劃視覺世界,請閱讀如何用 AI 把音樂變成影片:完整指南。
示例:一首三分鐘 YouTube 歌曲的實用 AI 音樂影片工作流
想象你已經完成了一首三分鐘的流行曲目。
下面是一種實用的做法。
第一步:生成之前先聽
標出:
- •前奏
- •主歌
- •副歌
- •橋段
- •尾奏
- •主要的音樂變化
第二步:定義一個視覺想法
例如:
一位歌手走過幾乎空無一人的夜城。每一段副歌,同一條街道變得擁擠、彩色、充滿生命。
這一句話,已經比生成十條互不相關的提示詞更有用。
第三步:搭建視覺世界
選定:
- •一位主要表演者
- •兩到三個反覆出現的地點
- •服裝造型
- •色彩語言
- •鏡頭風格
第四步:建立參考圖和首幀
動畫之前,先審閱臉、構圖、服裝和背景。
第五步:生成表演鏡頭和敘事鏡頭
不要用同一種方式生成每一個場景。
人聲可以用特寫,運動用中景,環境用全景,副歌附近用更短、更有動態的片段。
第六步:逐個修好薄弱鏡頭
如果 25 個片段能用、兩個失敗,就修那兩個。
不要重建整支音樂影片。
第七步:組裝,並對照歌曲審閱
從頭到尾看完整支影片。
一個單獨看起來驚豔的鏡頭,對這首音樂仍然可能是錯的。
手動工具棧版本
創作者可以用這些工具來做這個專案:
ChatGPT → OpenArt/Midjourney/GPT Image → Kling/Veo/Runway → CapCut/Premiere
這能提供最大的靈活。
BeatViz 版本
或者,你可以從BeatViz Workflow或AI Director開始,讓歌曲引導專案結構;當單個場景需要更直接的控制時,再進入Editor。
兩種方式都不是對每個人都自動正確。
差別主要在於:你想自己連線製作管線的多少部分。
常見問題
YouTube 創作者做音樂影片都用什麼 AI 工具?
沒有單一的標準工具。許多創作者會組合好幾款產品:Suno 或 Udio 做音樂,ChatGPT 做規劃,OpenArt 或 Midjourney 這類影象生成器做角色和首幀,Kling、Veo、Runway 或 Wan 這類影片模型做畫面,CapCut 或 Premiere Pro 這類剪輯軟體做最終組裝。
BeatViz 這類音樂優先平臺,可以把更多製作階段放進同一套工作流。
只用 Kling 夠不夠做出完整的 AI 音樂影片?
Kling 可以生成單個影片鏡頭,也可以成為音樂影片工作流裡重要的一環,但完整音樂影片仍然需要規劃、鏡頭篩選、與曲目同步、連貫性,以及最終組裝。
如果你把 Kling 當作獨立的生成工具來用,通常還需要和其他軟體搭配。
做 AI 音樂影片還需要 CapCut 嗎?
取決於工作流。
如果你用多個 AI 工具生成互不相干的片段,CapCut、Premiere Pro 或 DaVinci Resolve 這類剪輯軟體,對排布和同步成片極為有用。
如果你使用帶有自己的時間軸或組裝工作流的音樂優先平臺,也許可以在不切換到單獨剪輯軟體的情況下,完成專案的更多部分。
Suno 也能做音樂影片嗎?
Suno 主要屬於工作流裡的音樂生成這一側。
創作者通常會把完成的曲目帶到單獨的影象、影片或音樂影片生成工具裡,去建立畫面。
如果你走的是這條工作流,請閱讀我們的指南:如何把 Suno 歌曲做成 AI 音樂影片。
做 YouTube 音樂影片,最好的 AI 工具棧是什麼?
如果想要最大控制權,一套實用工具棧可以包括 AI 規劃工具、影象生成器、高質量影片模型和專業剪輯軟體。
對希望減少獨立工具數量的創作者來說,音樂優先平臺可能更高效。
正確選擇取決於你最在意的是靈活、畫面質量、速度、口型同步、長敘事,還是成本。
你也可以在我們的指南中對比不同的專用平臺:適合創作者的最佳 AI 音樂影片生成器。
我該用文生影片,還是圖生影片?
對以角色為主的音樂影片,圖生影片通常更容易控制,因為起始幀已經確立了角色、服裝、環境和構圖。
文生影片適合環境、轉場、實驗場景,以及角色精確一致性沒那麼重要的鏡頭。
許多創作者會在同一個專案裡兩種都用。
一個 AI 平臺能做出完整音樂影片嗎?
可以。
音樂優先平臺正越來越多地被設計成處理單個片段生成之外的更多事情。
例如,BeatViz 透過 Workflow、AI Director 和 Editor,把歌曲分析、創意規劃、場景生成、首幀、影片生成和剪輯連在一起。
不過,人工審閱仍然重要。
最強的結果,通常來自審閱生成的場景、修好薄弱鏡頭,並做出創作決策,而不是自動接受每一個第一次結果。
最好的工具通常是一套工作流,而不是某一個模型
AI 影片變化很快。
今天能產出最驚豔鏡頭的模型,六個月後未必還是創作者的首選。
但底層的音樂影片工作流要穩定得多:
歌曲 → 導演 → 角色 → 場景 → 分鏡 → 動態 → 表演 → 剪輯 → 成片
所以,按工具扮演的角色來選擇,比追逐當下最火的 AI 模型更合理。
需要歌的時候,用 Suno 或 Udio。
需要確立角色和首幀時,用影象生成器。
需要單個鏡頭時,用 Kling、Veo、Runway、Wan 或其他強影片模型。
想親手組裝一切時,用 CapCut、Premiere Pro 或 DaVinci Resolve。
而如果你真正的目標不是「生成一段片段」,而是把完成的歌曲做成完整音樂影片,就用一套圍繞歌曲本身搭建的工作流。
BeatViz 給了你三種做法:
想要引導式的全曲創作流程時,使用Workflow。
想透過對話發展和修改音樂影片時,使用AI Director。
想直接控制單個鏡頭和時間軸時,使用Editor。