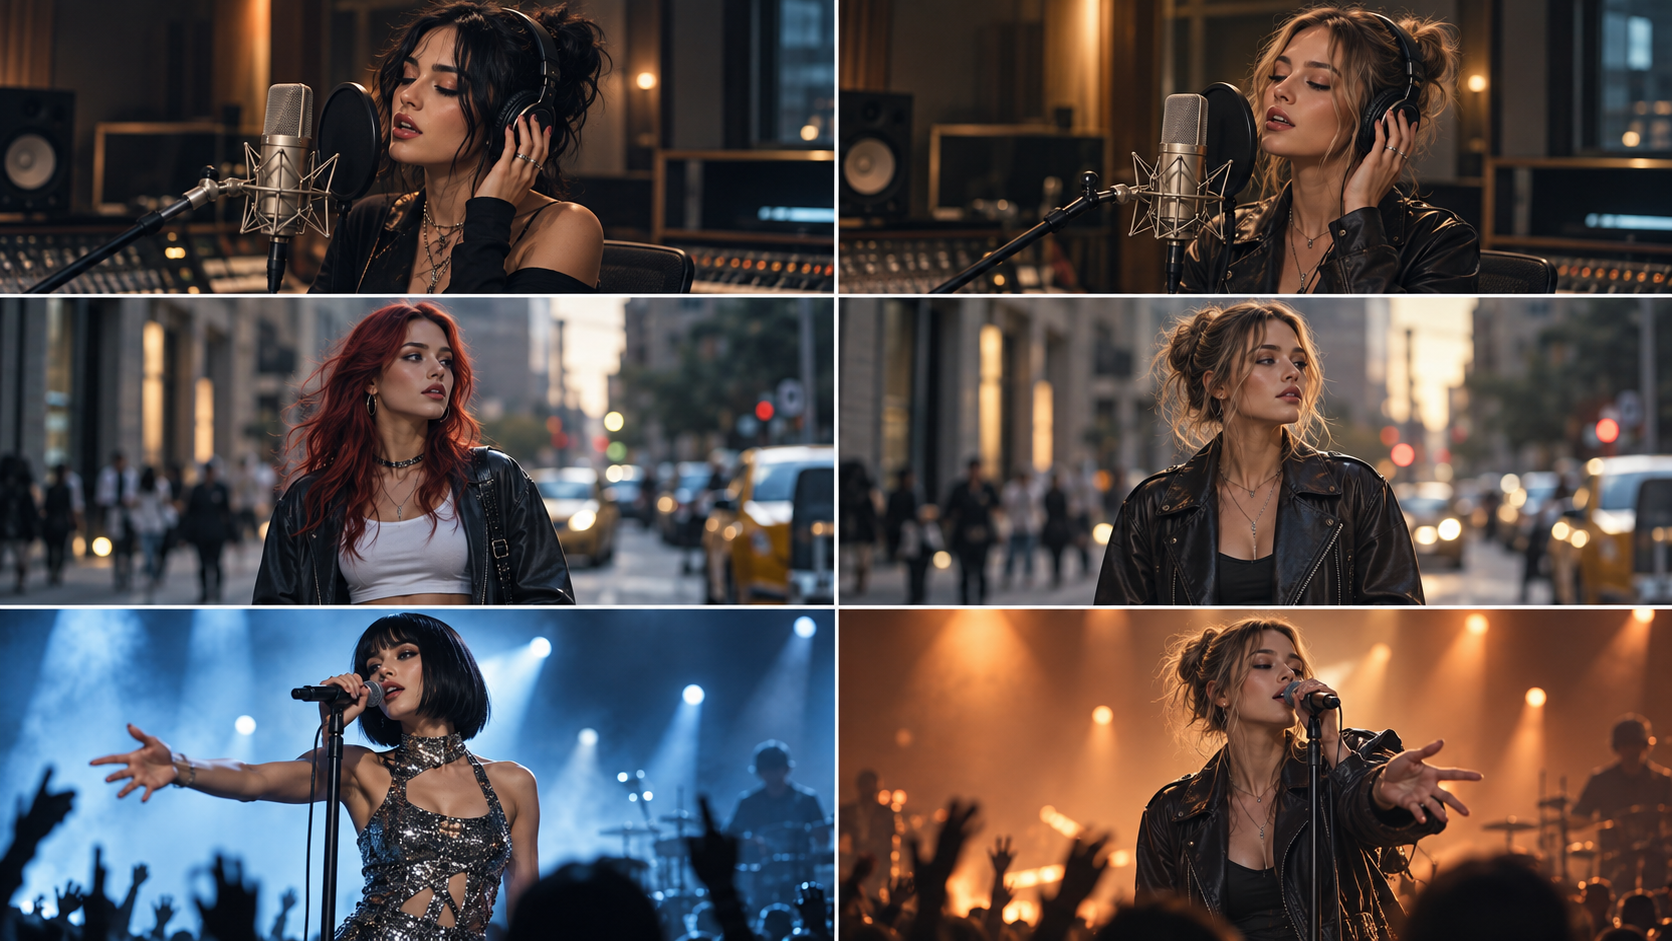
演唱與表演影片最好的口型同步 AI 音樂影片生成器
一位歌手站在舞台上,並不是表演音樂影片令人信服的關鍵。
真正困難的,是讓那位表演者感覺真的和歌曲連在一起。
嘴巴要跟上人聲。表情要符合演唱方式。鏡頭切換時,同一個藝人還要認得出來。同樣重要的是,影片也要知道什麼時候不該讓他們開口唱歌。
這就是為什麼選擇具備口型同步的 AI 音樂影片生成器,和選擇一般 AI 影片生成器完全不同。
有些工具很擅長讓單一人像開口唱歌。有些能讓角色跟上好幾分鐘的音訊。只有較少的工具,能把口型同步、場景規劃、角色一致性、懂音樂的剪輯,以及完整的多場景音樂影片工作流程結合在一起。
如果你已經有完成的曲目,想看看這些環節如何一起運作, BeatViz AI 音樂影片生成器 是圍繞完整的歌曲轉影片製作設計的,而不是孤立的 AI 片段。
這份指南會比較七款目前可用的 AI 演唱影片與表演音樂影片工具,包括 BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen 和 Hedra。
目標不只是問:
這個工具能不能讓角色的嘴巴動起來?
更好的問題是:
這個工具,能不能把那場表演做成真正的音樂影片?
哪些 AI 音樂影片生成器支援口型同步?
現在已有多個 AI 影片平臺,支援某種形式的演唱或人聲口型同步。
真正重要的差別,在於口型同步如何融入後續的製作流程。
| 工具 | 口型同步 | 完整音樂影片工作流程 | 最適合 |
|---|---|---|---|
| BeatViz | 有,片段層級 | 有 | 需要場景層級掌控的完整表演 MV |
| Neural Frames | 有,透過 Vocal Video | 有 | 帶有選定演唱場景的音樂響應影片 |
| Freebeat | 有,Singing MV 模式 | 有 | 快速自動生成的演唱音樂影片 |
| Revid | 有 | 有 | 結合歌詞、節拍時序與歌手的快速音樂影片 |
| Kaiber | 有,Image Lip Sync 與 Video Lip Sync | 部分/模組化 | 有創意的單段表演片段 |
| HeyGen | 有 | 以表演者為核心 | 讓人像或虛擬角色開口唱歌 |
| Hedra | 有 | 以角色為核心 | 較長的音訊驅動角色表演 |
這個區別很重要,因為 AI 演唱影片和完整的表演音樂影片,不一定是同一件事。
例如,HeyGen 能讓人像跟著歌曲動起來,Kaiber 則能把音訊驅動的口型同步套用到圖片或既有影片上。BeatViz、Neural Frames、Freebeat 和 Revid 則更進一步,把演唱鏡頭放進更完整的音樂影片工作流程裡。
口型同步、節拍同步、歌詞同步:它們不是同一件事
AI 音樂影片工具容易讓人混淆的原因之一,是口型同步、節拍同步、歌詞同步這些詞,常常被當成同一件事。
它們不是。
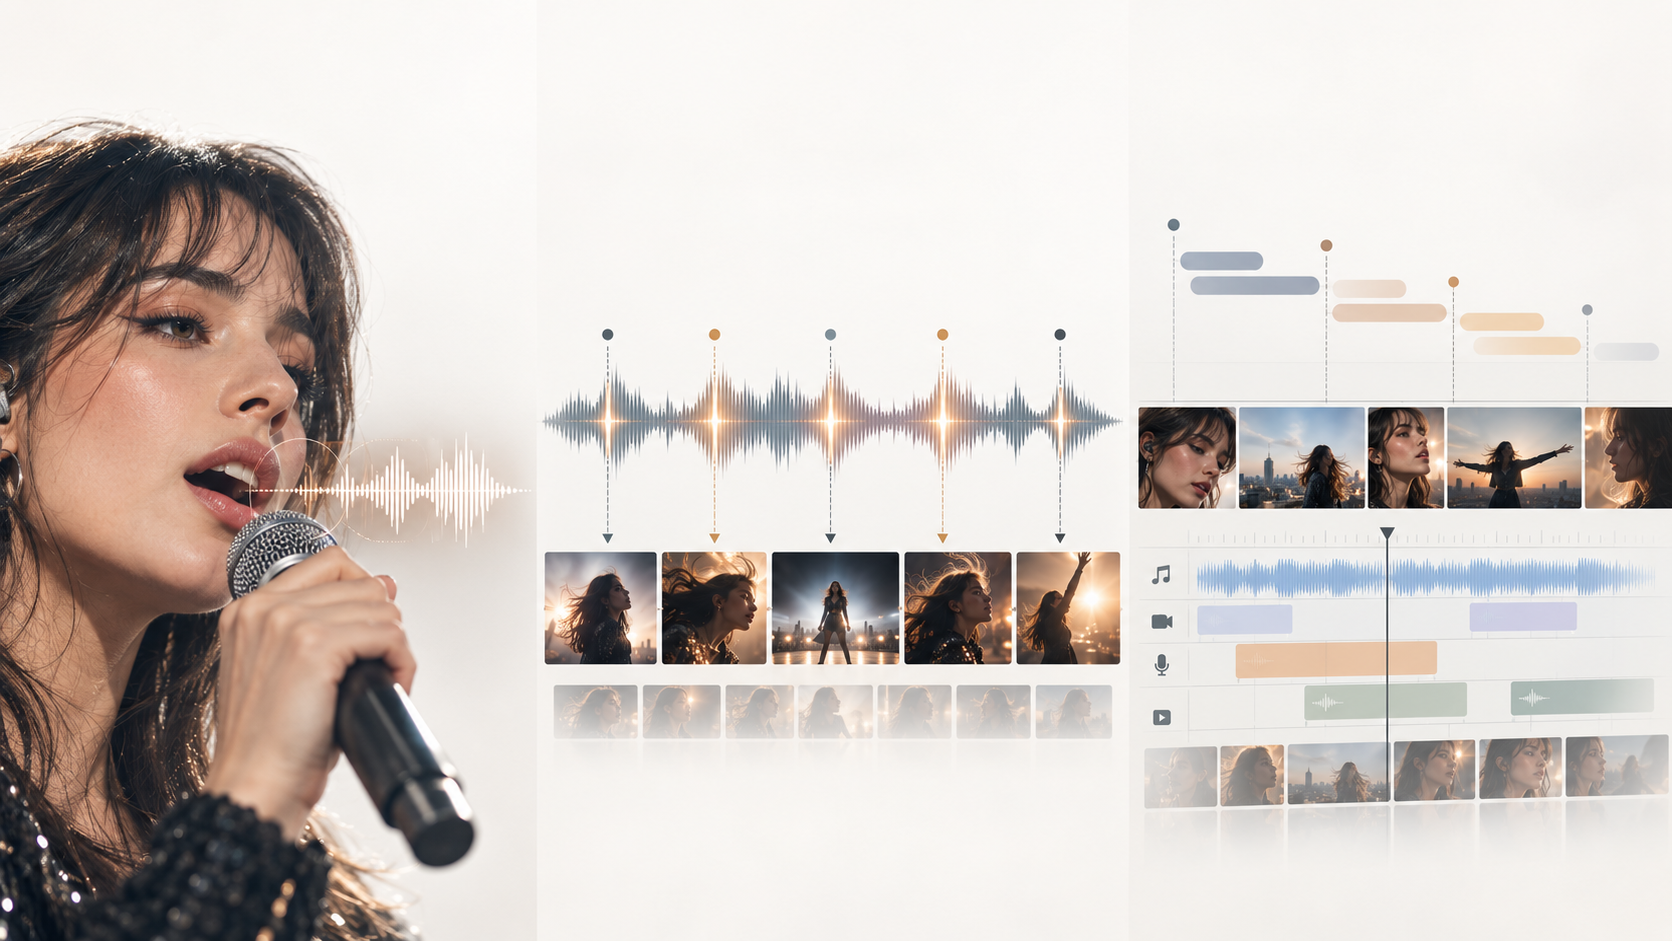
口型同步
口型同步控制的是人聲音訊與表演者嘴巴之間的關係。
如果歌手唱出一個由閉口輔音開頭的字,視覺表演就應該在差不多正確的時間點反映出那個聲音。
但令人信服的演唱,不只是嘴型。
特寫表演鏡頭也取決於:
- •臉部表情
- •眼神移動
- •頭部動作
- •呼吸與樂句
- •肢體動作
- •情感傳達
嘴巴即使技術上同步了,如果周圍一切都像凍結,看起來仍然會很假。
節拍同步
節拍同步影響的是剪輯,而不是歌手的臉。
剪接、轉場、運鏡變化、視覺效果與場景長度,都可以跟著音樂節奏走。
快速的副歌可能用更短的鏡頭。
緩慢的橋段可能把同一個鏡頭留得更久。
drop 可能觸發場景轉換。
即使畫面上沒有任何人,這也能讓影片感覺和音樂連在一起。
歌詞同步
歌詞同步關心的是字詞、字幕或視覺概念,相對於實際歌詞的時間點。
它可以簡單到卡拉 OK 風格的字幕。
也可以是圍繞某一句歌詞的意思來設計場景。
例如 Revid,目前就在音樂影片工作流程裡,把歌詞時序、節拍時序,以及可選的歌手口型同步分開處理。
最強的表演影片,常常三者並用。
口型同步控制表演者。節拍同步控制剪輯。歌詞同步則幫助畫面連上歌曲在說什麼。
我們如何比較具備口型同步的 AI 音樂影片生成器
這不是在實驗室裡、用同一位歌手、同一首歌、同一個 seed、同一段提示詞和同一套 GPU 條件,對每個平臺做受控基準測試。
這份比較聚焦的是各產品目前公開的工作流程,以及音樂人在選擇時會問的實際問題:
- •口型同步是怎麼套用的?
- •你能不能決定哪些場景要唱歌?
- •同一個表演者能不能出現在多個鏡頭裡?
- •這個工具能不能處理整首歌,而不只是一段短片段?
- •一個不好的表演鏡頭,能不能替換,而不必整支重做?
- •這個平臺懂音樂結構,還是只是依音訊檔讓一張臉動起來?
對完整表演 MV 來說,這些差別比「有沒有口型同步」的勾選框重要得多。
7 款最好的口型同步 AI 音樂影片生成器
1. BeatViz —— 最適合把口型同步放進完整表演音樂影片
BeatViz 把口型同步當成更大音樂影片製作工作流程的一部分。
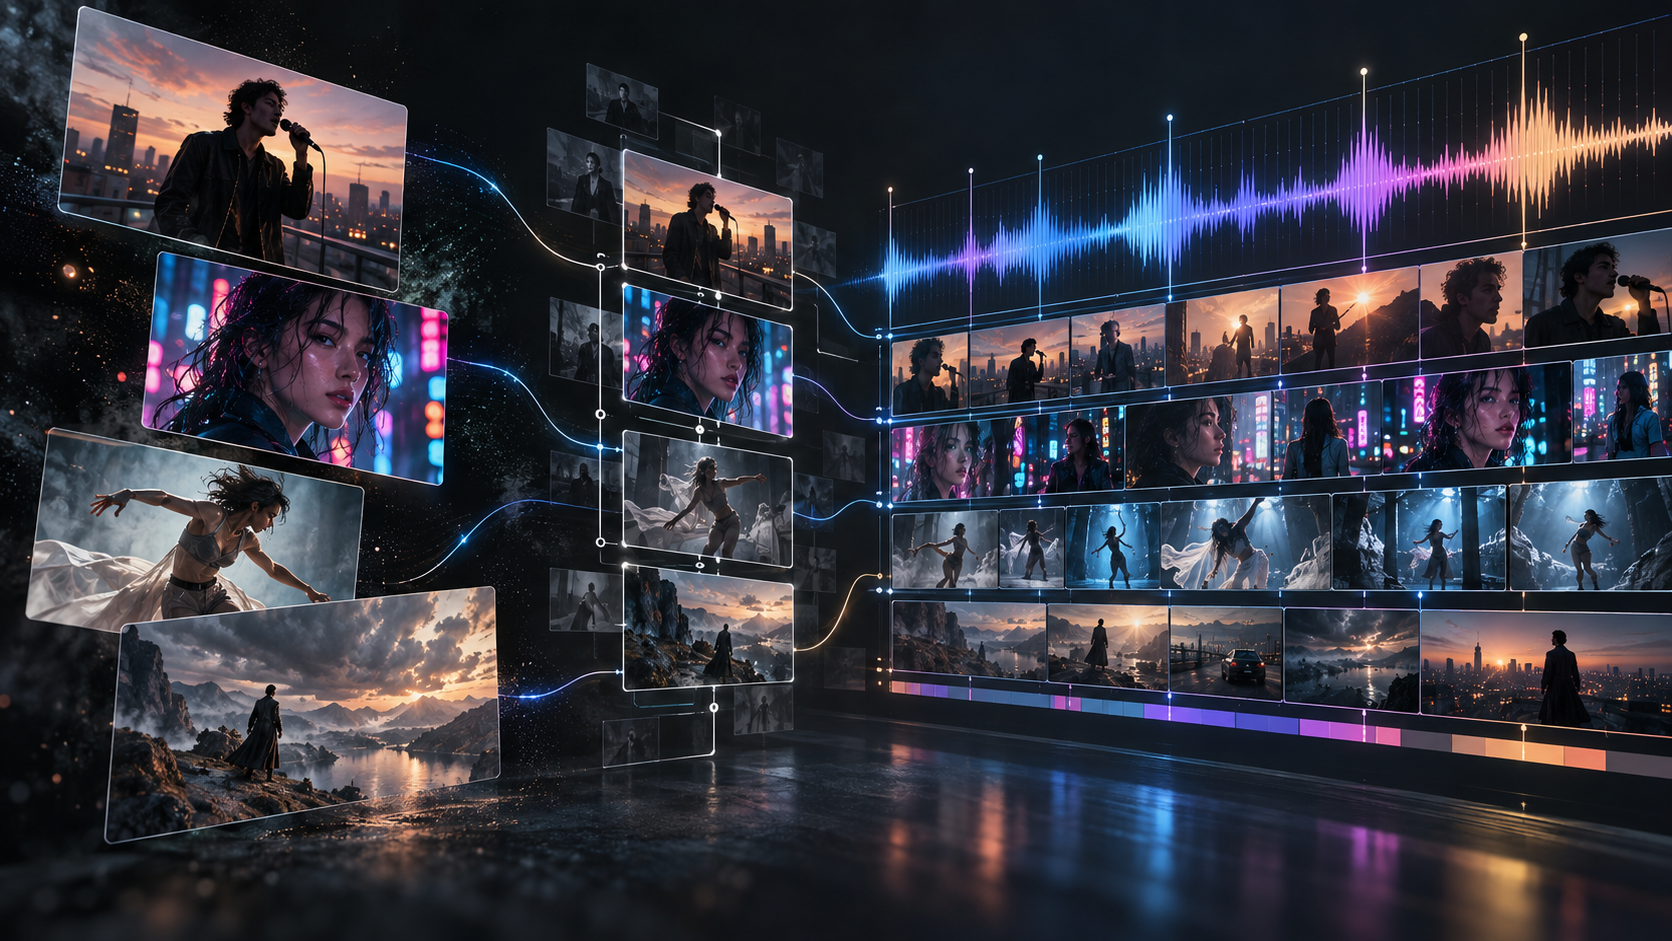
與其先從一張臉開始,再要求它唱完整首歌,你可以先從音樂本身開始。
平臺目前提供三種彼此串連的做法:
- •Workflow:一步步做出完整影片。
- •AI Director:用對話發展音樂影片。
- •Editor:直接掌控時間軸與片段層級。
對表演影片來說,這個區分特別有用。
一首三分鐘的歌,很少需要三分鐘不間斷的口型同步。
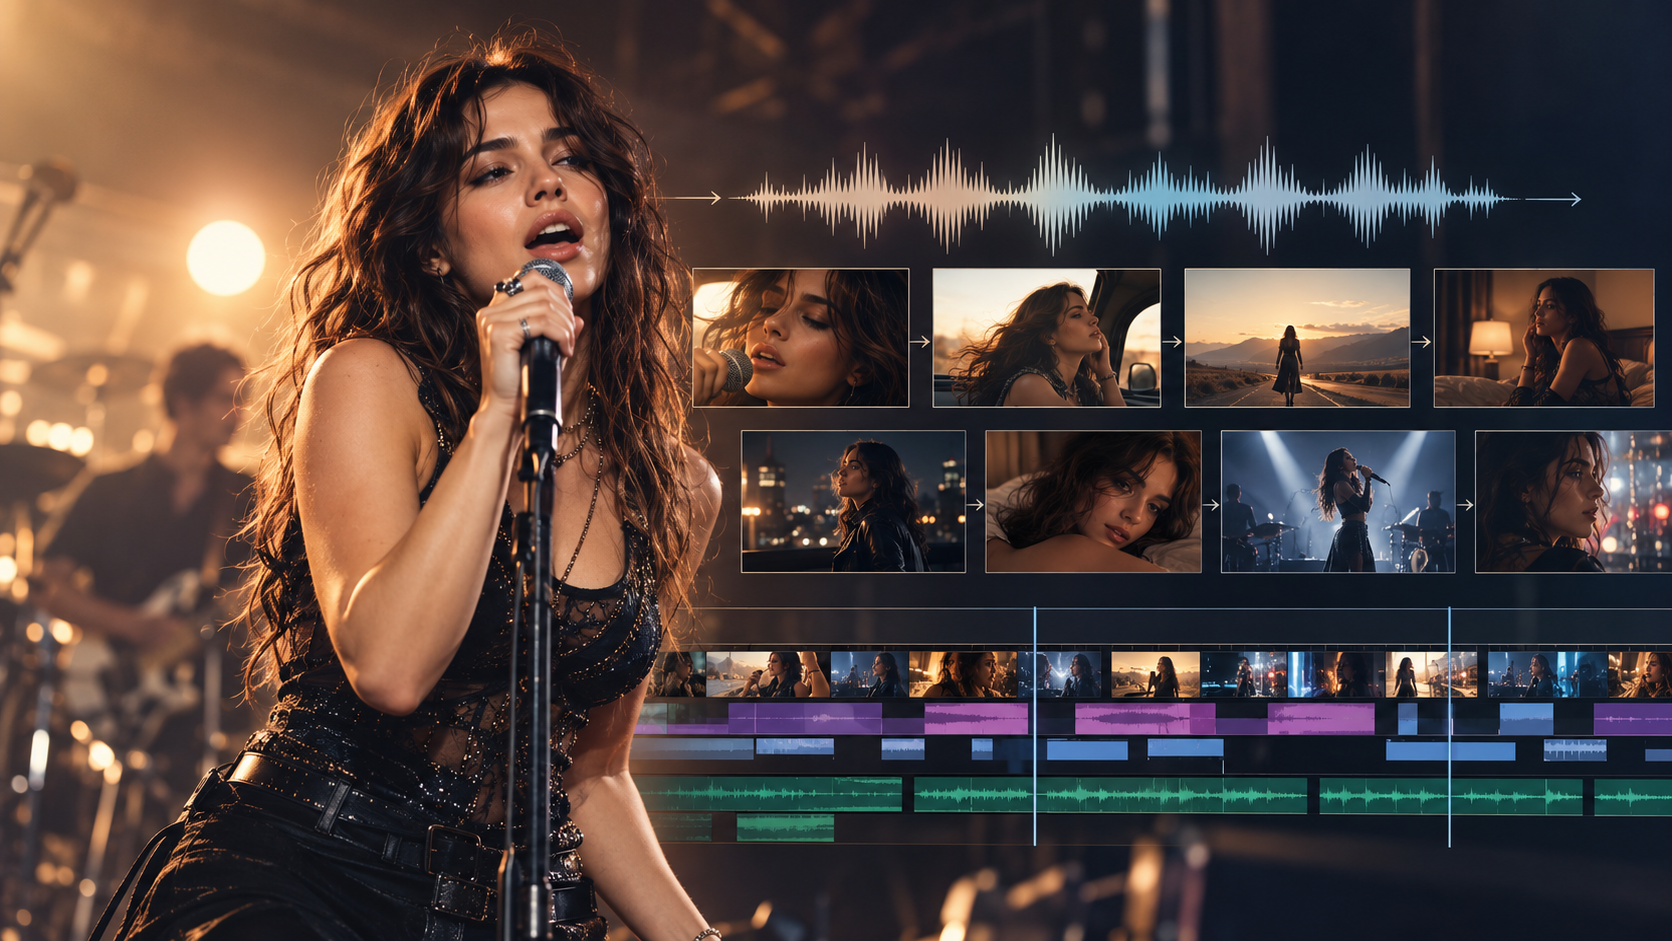
你可能想在第一段副歌用特寫表演,第二段主歌切到敘事畫面,橋段再回到歌手,最後以更大的表演序列作結。
這表示口型同步更適合當成導演決策,而不是套用在整支影片上的全域效果。
先從表演者開始,而不是嘴巴
好的口型同步,在進入口型同步階段之前就開始了。
如果藝人在鏡頭之間換了身份,再精準的同步嘴巴也救不了這支影片。
在 BeatViz Workflow 裡,你可以先確立歌曲、視覺方向、角色、場景、鏡頭與首幀,再進行最終影片生成。
這樣更容易把表演者當成反覆出現的角色,而不是每次鏡頭一切換就生出一個新的人。
如果角色連續性是你的主要問題,可以另外看我們這份 角色一致性最好的 AI 音樂影片生成器 指南。

用 AI Director 導演這場表演
表演 MV 也需要創意決策。
例如:
第一段主歌保持電影感與故事驅動。副歌改用面向鏡頭的表演鏡頭。最後的 hook 再回到特寫表演。
這類導演指示,可以透過 BeatViz AI Director 發展出來,而不必把每一個創意決定,都手動翻譯成各自獨立的生成提示詞。
把口型同步用在真正重要的地方
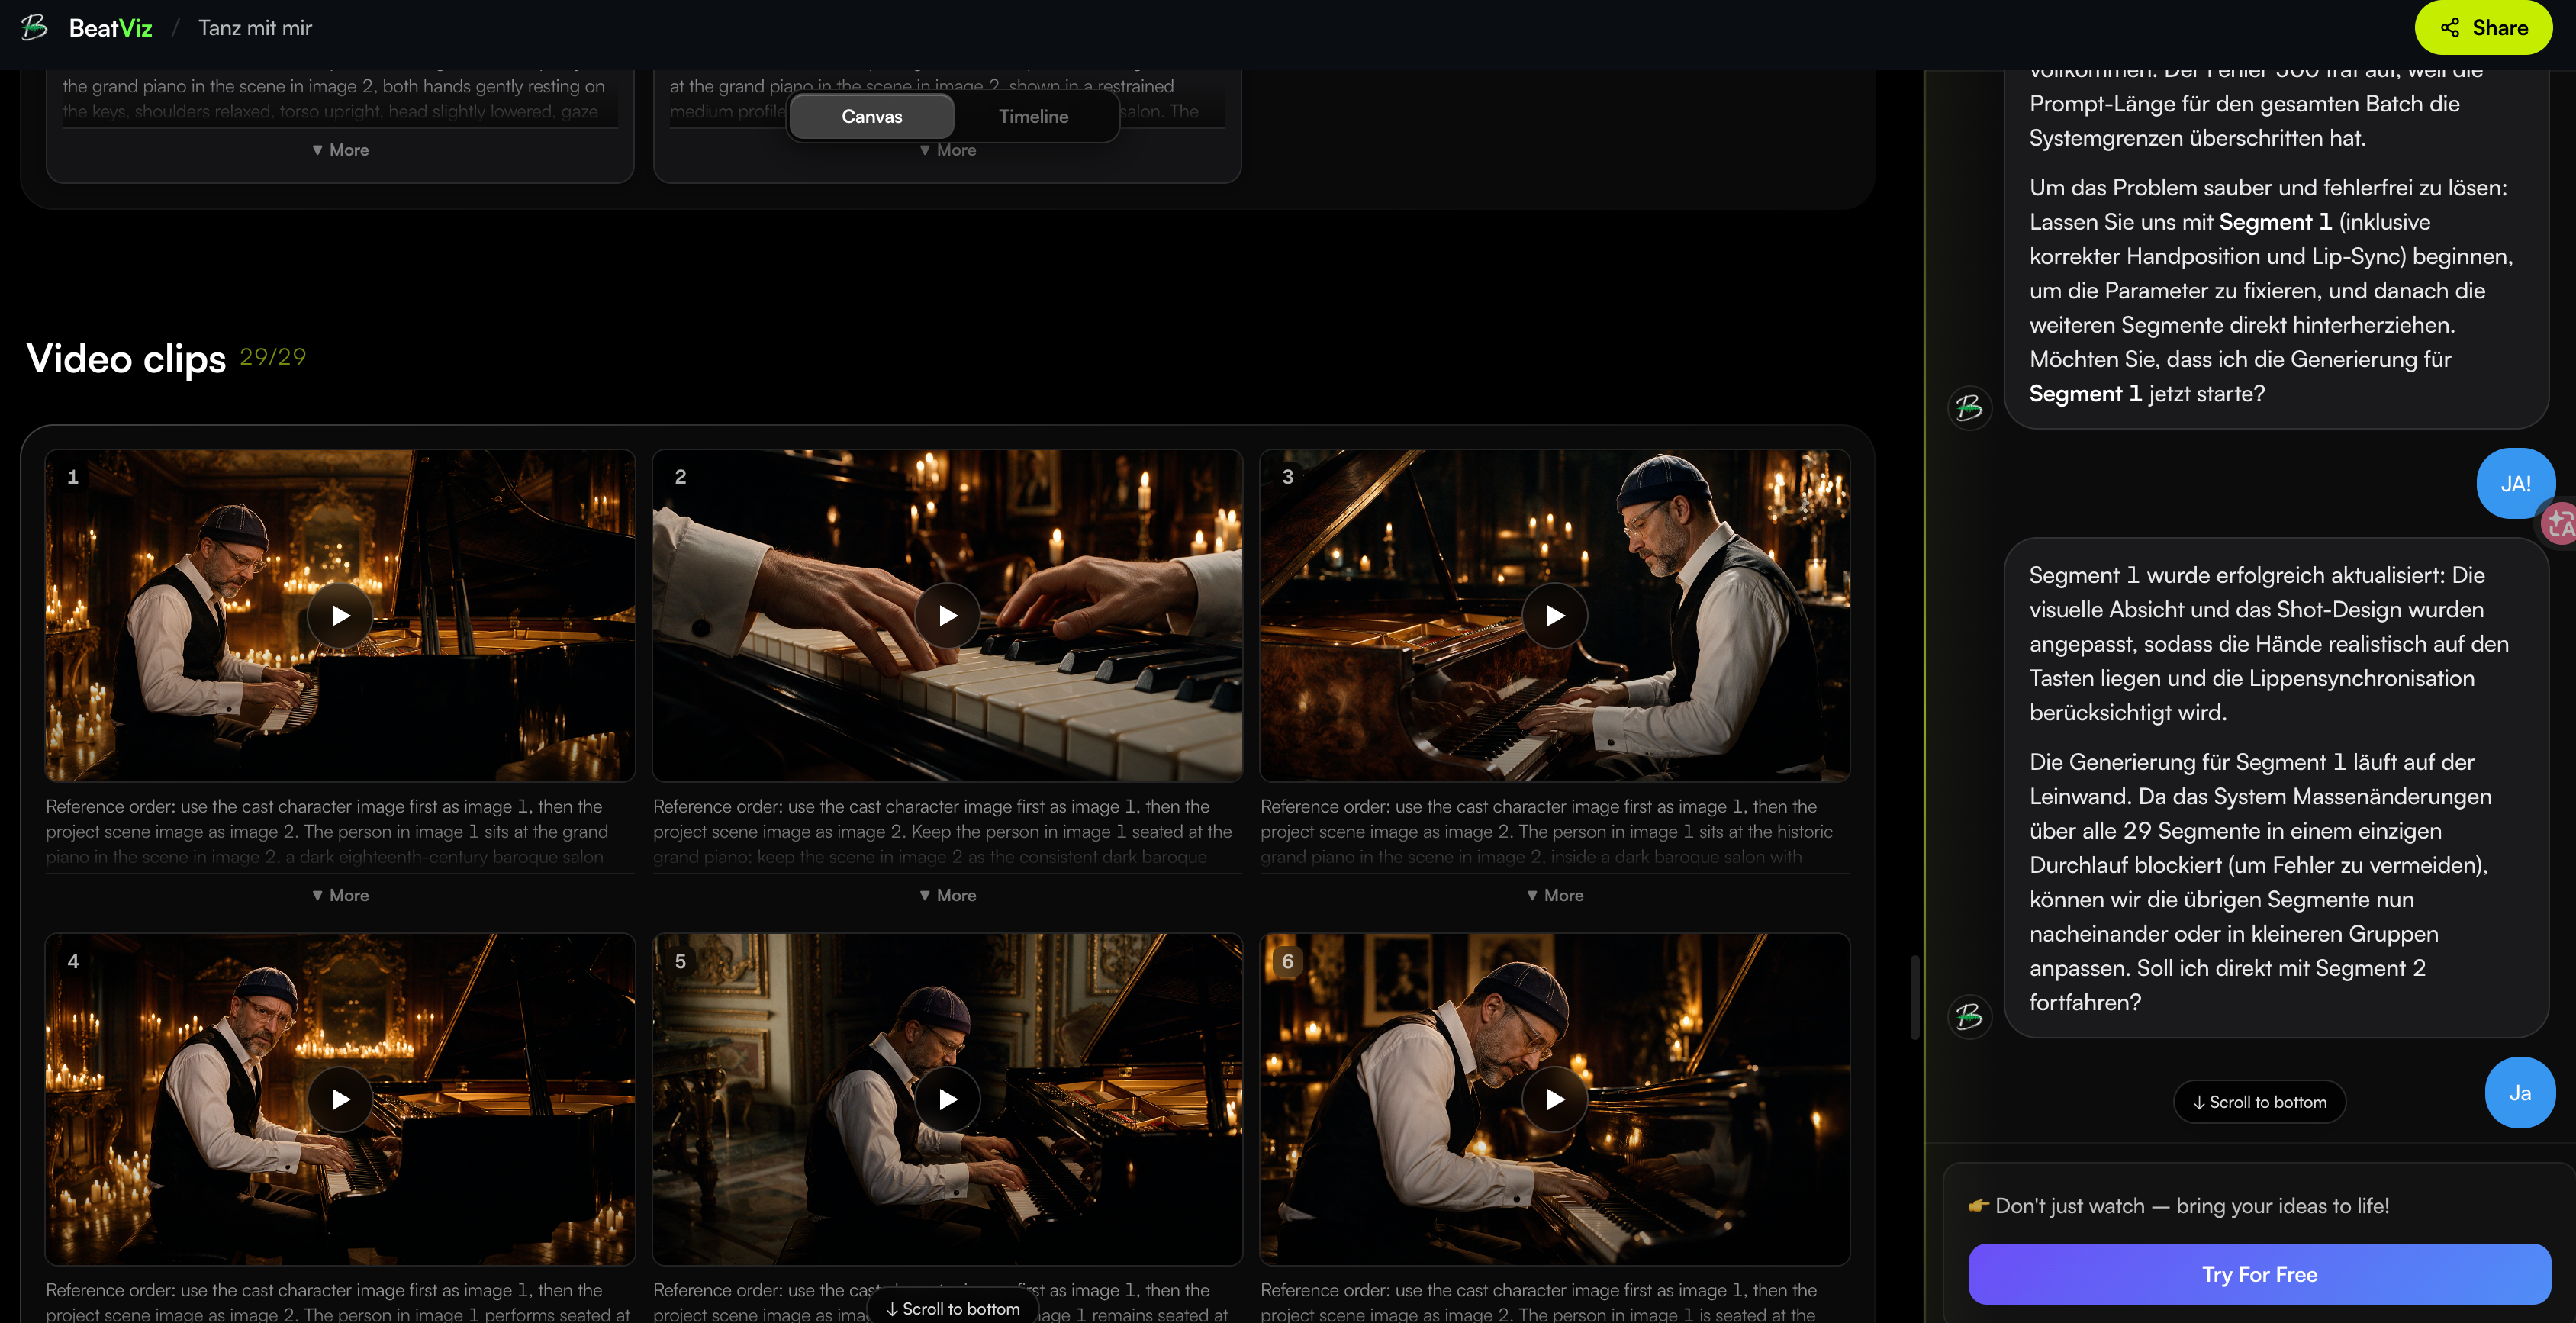
這次比較裡,BeatViz 最相關的部分是 Editor。
當完成的影片片段放到音訊時間軸上之後,你可以選取那個個別片段,並用同一段落下方的音訊套用 LipSync。
BeatViz 目前在選定的時間軸片段層級套用口型同步,個別口型同步片段上限為 15 秒。這自然會引導你走場景式做法:生成表演鏡頭、對齊相關人聲樂句、做口型同步,再繼續圍繞它組裝影片的其餘部分。
這在你想要以下情況時特別有用:
- •副歌做口型同步,器樂前奏則不要
- •只有某個特寫開口唱歌,周圍鏡頭保持電影感
- •整首歌裡分散安排幾個表演時刻
- •能替換一個較弱的表演片段,而不必重生成整支影片
這讓 BeatViz 特別適合用音樂影片時間軸思考的創作者,而不只是要一個會動的歌手。
想讓副歌表演,主歌保持電影感?
先從 BeatViz Workflow 開始,在 AI Director 裡發展視覺方向,再到 Editor 裡打磨個別演唱鏡頭。
若要更深入了解剪輯工作流程,請看 BeatViz Editor 教學。
2. Neural Frames —— 最適合具備音樂響應掌控的 Vocal Video
當你希望表演者存在於更大的音樂影片結構裡時,Neural Frames 也是很強的選擇。
它的 Autopilot 工作流程會走過音樂、曲目設定、分鏡建立,以及最終影片生成。
平臺的 Vocal Video 模式,專門讓角色跟著上傳的歌曲一起唱。
更重要的是,Vocal Video 不一定強迫每個場景都唱歌。目前的工作流程可以只在選定片段或特定關鍵幀開啟口型同步,因此很適合把演唱表演和非表演畫面結合在一起。
Neural Frames 也在 Autopilot 裡支援多個可控制角色,並讓創作者在最終生成前調整分鏡中的個別場景。文件目前標示 Autopilot 專案最長可達 15 分鐘。
最適合: 想要音訊響應影片系統、精細分鏡掌控,以及選定演唱場景的創作者。
需要考慮的地方: 介面給你很多創意變數。這種彈性很有用,但若你只想「上傳歌曲、拿到完成的 MV」,可能會更喜歡更自動化的工作流程。
3. Freebeat —— 最適合快速自動生成 Singing MV
Freebeat 是最直接圍繞 Singing MV 這個說法定位的產品之一。
目前的工作流程讓創作者上傳音樂或匯入歌曲、選擇創作模式,並在想要表演者為主的結果時選 Singing MV。
Freebeat 表示,它的 Singing MV 系統能從一張照片做出口型同步的表演者,同時處理歌曲分析、場景規劃、角色連續性,以及懂節拍的剪輯。目前在符合條件的付費方案上,宣傳最長可生成六分鐘。
當自動化是優先考量時,這讓 Freebeat 很有吸引力。
你不必手動決定每一個表演鏡頭該怎麼組,而能讓系統自動完成影片的大部分。
最適合: 想從一首歌快速做出以演唱為主的 MV、又不想花太多手動設定的音樂人。
需要考慮的地方: 自動化和導演掌控不是同一件事。如果你很在意精準決定哪一段副歌用哪個運鏡,或要手動重建個別鏡頭,選擇前請仔細比較剪輯工作流程。
4. Revid —— 最適合結合歌手口型同步、歌詞與快速音樂影片生成
Revid 把不同同步形式之間的差別講得特別清楚。
目前的音樂影片工作流程,讓創作者上傳曲目或使用 Suno 連結、選擇視覺方向、選定歌詞或節拍時序,並可選擇啟用會對歌詞做口型同步的歌手。
生成結果會在編輯器裡開啟,匯出前還能改場景。
這個組合讓 Revid 特別適合產出:
- •歌詞很重的歌曲
- •饒舌影片
- •直式社群音樂內容
- •字幕與歌手表演需要一起運作的影片
把歌詞、剪輯時序和演唱角色當成不同層來處理,這點很有用。
一首歌可以跟著歌詞走,卻不必每個鏡頭都出現歌手。
最適合: 歌詞、社群格式與人聲表演都很重要的快速創作者音樂影片。
5. Kaiber —— 最適合有創意的 Image Lip Sync 與 Video Lip Sync 鏡頭
Kaiber 是稍微不同類型的選擇。
Kaiber 不只從完全自動化的音樂影片管線來思考,也提供 Image Lip Sync 與 Video Lip Sync 工作流程。
Image Lip Sync 從靜態圖片和音訊開始。
Video Lip Sync 從既有影片畫面和音訊開始。
Kaiber 目前文件標示 Image Lip Sync 可對齊最長 300 秒的音訊,Video Lip Sync 則支援最長 30 秒的音訊。公司也建議使用清楚、正面朝前的單一主體,並在投入較長生成前,先用較短的音訊段落測試。
當你已經很清楚表演鏡頭該長什麼樣子時,Kaiber 就很有用。
例如,你可能已經有:
- •一張很強的歌家人像
- •一張生成好的表演圖片
- •一段既有的電影感影片鏡頭
- •一個你想同步的特定特寫
你不必要求一個工具做出整支 MV,而可以把 Kaiber 當成更大工作流程裡的一個階段。
最適合: 風格化的單段演唱鏡頭,以及喜歡自己組裝製作管線的創作者。
6. HeyGen —— 最適合讓照片開口唱歌
有時候你不需要完整的音樂影片。
你只想要一個令人信服的演唱角色。
這正是 HeyGen 的 Make Photo Sing 工作流程適合的地方。
目前的工具從人像和音軌開始,再讓臉跟著歌曲動。HeyGen 把這個功能定位在寫實的嘴部動作與臉部表情,並建議用清楚的正面人像作為起始圖。
這適合用在:
短社群片段、虛擬歌手、角色實驗、動態人像、迷因,以及表演插入鏡頭。
但有一個重要區別。
一個好的演唱虛擬角色工具,不會自動變成完整的音樂影片製作系統。
如果你的全部目標是:
我要這張照片唱我的歌。
HeyGen 就是合理的選擇。
如果你的目標是:
我要一支三分鐘的音樂影片,有故事場景、地點、運鏡變化、表演段落,以及多種視覺想法。
你很可能還需要在它周圍建立更完整的工作流程。
最適合: 演唱人像,以及以表演者為先的片段。
7. Hedra —— 最適合較長的音訊驅動角色表演
Hedra 是另一個很強的角色表演選擇。
目前的 Hedra Avatar 與 Character 3 工作流程,是圍繞圖片+音訊生成打造的,口型同步與臉部動態由音軌驅動。
Hedra 目前支援最長 10 分鐘的長篇音訊驅動虛擬角色生成,並明確把說話與唱歌列為使用場景。
如果你的創意概念是一個角色交出一段長而連續的人聲表演,Hedra 就特別有意思。
例如:
風格化的虛擬歌手、鎖定鏡頭的錄音室表演、面向鏡頭唱歌的動畫角色,或長篇人聲呈現。
不過,一段連續的音訊驅動角色鏡頭,和一支多地點音樂影片,是兩種不同的製作問題。
如果你要不斷換場景、發展故事、多種運鏡設定,以及音樂影片節奏,你可能仍需要圍繞這些生成好的表演,另外建立剪輯工作流程。
最適合: 較長的演唱角色與虛擬角色表演,且音訊驅動的臉部動畫是主要需求。
你該選哪一口型同步 AI 音樂影片工具?
沒有單一正確答案,因為「口型同步音樂影片」可以指非常不同的東西。
如果你要讓一張照片開口唱歌,從 HeyGen 這類專門工具開始。
如果你已經有很強的圖片或影片,主要只是要把它變成演唱鏡頭,Kaiber 值得考慮。
如果你要一段長而連續的角色表演,Hedra 特別相關。
如果你的優先事項是快速自動的歌曲轉影片生成,Freebeat 和 Revid 提供高度自動化的做法。
如果你要懂音樂的分鏡,並搭配選定的 Vocal Video 場景,Neural Frames 提供相當多的掌控。
而如果你的目標是把口型同步當成完整表演 MV 裡的一個元素——搭配敘事場景、反覆出現的角色、鏡頭規劃與時間軸剪輯——BeatViz 就是圍繞這套製作結構設計的。
所以在選擇口型同步技術之前,先定義你想要的最終影片,會很有幫助。
你要的是演唱虛擬角色嗎?
- •一段社群短片?
- •一支視覺化影片?
- •一支歌詞影片?
- •還是真正的多場景音樂影片?
那些是不同的工作。
規劃的是一次完整發行,而不只是單一段演唱片段?
探索完整的 BeatViz 音樂影片工作流程,再查看 BeatViz 價格方案 ,再決定你想生成與打磨這首歌的多少部分。
BeatViz 如何在完整音樂影片裡使用口型同步
當口型同步被整合進歌曲的創意結構時,效果最好。
想像一首假設的三分鐘流行搖滾曲。
前奏以環境畫面開場。
第一段主歌跟著藝人走進空蕩的公寓。
前副歌切得更靠近歌手。
接著副歌變成直接的表演。
第二段主歌回到故事畫面。
橋段使用一個親密特寫。
最後的副歌擴展成更大的表演序列。
這些場景裡,只有一部分需要嘴巴跟上人聲。
影片的其餘部分,仍然需要回應音樂。
這就是為什麼 BeatViz 工作流程會把大方向的創意規劃,和最終的片段打磨分開。
Workflow:先把影片做出來,再微調演唱鏡頭
先在 Workflow 裡上傳曲目。
建立創意概念。
確立角色。
檢視場景。
在投入最終動態之前,先檢視關鍵幀。
這很重要,因為角色一致性通常在生成口型同步表演之前解決,會比之後再修容易。
一張夠強的首幀,能讓生成模型更清楚臉、頭髮、服裝、光線、構圖與運鏡角度。
若要更完整了解整個流程,請讀 如何用 AI 把音樂變成影片。
AI Director:決定藝人什麼時候表演
接下來,像導演一樣思考,而不是口型同步技術員。
你可以用 AI Director 描述表演在影片裡該扮演的角色。
例如:
開場保持電影感,不要唱歌。前副歌用中景表演鏡頭介紹藝人。副歌用帶口型同步的正面特寫,hook 之後再回到敘事畫面。
這類指示包含的創意資訊,遠比下面這句有用:
整支影片都做口型同步。
Editor:修好真正重要的鏡頭
最後,當個別鏡頭需要更多掌控時,使用 BeatViz Editor 。
表演片段可以在時間軸上對齊相關音訊,並獨立做口型同步。
如果某個片段失敗了,你可以處理那一段,而不必把整支完成的音樂影片當成一次性的東西丟掉。
這種場景層級的做法特別有價值,因為生成式影片本質上是機率性的。
目標不是期待每個鏡頭第一次就完美。
目標是擁有一套工作流程,能找出並修好弱鏡頭,而不必重建周圍的一切。
為什麼不該幫音樂影片的每個鏡頭都做口型同步
讓 AI 音樂影片感覺重複的最快方法之一,就是讓表演者不停唱歌。
真正的音樂影片,常常在不同視覺功能之間移動。
一個鏡頭確立表演者。
另一個發展故事。
另一個營造氛圍。
另一個強調服裝或編舞。
另一個回應器樂間奏。
然後,當看見人聲表演真的能增加什麼時,影片再回到藝人。
把表演畫面想成標點符號。
在重要歌詞時給一個強特寫,之所以有力,是因為前兩分鐘你並沒有一直看同一張嘴在動。
一套有用的結構可能像這樣:
表演 → 故事 → 環境 → 表演 → B-roll → 舞蹈 → 特寫 → 故事 → 最終表演
這會讓口型同步段落更有重量。
也能減少你需要生成的困難臉部表演鏡頭數量。
這也是為什麼我們更完整的 用 AI 把音樂做成影片 指南,把口型同步當成場景層級的創意決策,而不是整支影片的定義。
做出更好 AI 演唱與口型同步鏡頭的技巧
使用一位清楚可見的歌手
口型同步模型通常在能清楚辨識哪一張臉該跟上音訊時,表現比較好。
在重要的人聲時刻,除非工具明確支援多位說話者或表演者,否則避免在同一畫面裡放好幾張同樣醒目的臉。
給臉足夠的畫面空間
非常寬的全身鏡頭,可能會把嘴部動作藏起來。
極端特寫則會讓臉部瑕疵明顯得多。
中景、中特寫和一般特寫,通常是比較安全的起點。
Kaiber 自己的口型同步指引,同樣建議注意鏡頭距離,並使用清楚可見、正面朝前的主體。
先確立角色一致性
如果歌手的臉部結構在每個表演鏡頭之間都在變,改善嘴部動作也解決不了更大的連續性問題。
先鎖定表演者,再花時間打磨人聲動畫。
在觀眾期待的地方使用表演
副歌、情感 hook、面向鏡頭的歌詞、饒舌主歌或人聲高潮,通常比轉場或器樂段落更能從口型同步受益。
把最好的生成,花在觀眾最可能看向表演者臉的地方。
在渲染太多之前,先測試困難人聲
快速饒舌、強烈輔音、重疊人聲、即興加花、和聲,以及不尋常的樂句,可能比緩慢、乾淨的人聲線更吃力。
先測試一段代表性段落,能幫助你了解這個工具怎麼處理你這首特定曲目。
不要忽略首幀
口型同步模型仍然需要一個可信的表演者來驅動動畫。
頭髮遮住嘴巴、極端側臉、不尋常的臉部變形,或圖片品質不佳,都可能在同步開始之前就帶進問題。
可以用 Suno 歌曲做口型同步嗎?
可以。
完成的 Suno 曲目仍然是音訊檔,因此可以用在接受上傳音樂或相容歌曲匯入的 AI 影片工具上。
更重要的問題是,你想圍繞它做出哪一種影片。
如果你只想要一個虛擬角色唱這首歌,照片轉演唱的工具可能就夠了。
如果你要完整音樂影片,還需要考慮:
- •歌曲結構
- •角色
- •地點
- •視覺敘事
- •表演鏡頭
- •剪輯
- •場景一致性
我們在 如何用 Suno AI 製作音樂影片 裡另外說明那套工作流程。
你也可以把完成的曲目直接上傳到 BeatViz 音樂影片生成器 ,並從歌曲本身開始建立視覺製作。
常見問題
哪些 AI 音樂影片生成器支援口型同步?
BeatViz、Neural Frames、Freebeat、Revid、Kaiber、HeyGen 和 Hedra,目前都以不同形式提供口型同步或音訊驅動的演唱能力。正確選擇取決於你需要的是一個演唱角色,還是整支多場景音樂影片。
讓歌手開口唱歌,最好的 AI 是哪一個?
若要把單一人像變成演唱角色,HeyGen 和 Hedra 這類專門的虛擬角色與照片動畫工具是很強的選擇。
若要把那位歌手放進完整音樂影片,BeatViz、Neural Frames、Freebeat 和 Revid 這類平臺提供更完整的歌曲轉影片工作流程。
AI 能為整首歌做口型同步嗎?
可以,有些平臺支援長達數分鐘的音訊驅動表演。
不過,生成一個連續演唱角色,和做出完整音樂影片,不是同一件事。
對大多數 MV 來說,選擇性地為重要表演鏡頭做口型同步,再和非表演場景混剪,通常能創造更多視覺變化。
口型同步和節拍同步有什麼差別?
口型同步讓表演者的嘴巴跟上人聲。
節拍同步則讓剪接、轉場或場景時序這類剪輯決策對齊音樂節奏。
一支影片可以完全沒有歌手,卻仍然做到節拍同步。
我能用一張照片做出 AI 歌手嗎?
可以。HeyGen、Hedra、Kaiber 和 Freebeat 這類工具,目前都提供能用音訊驅動角色或人像的工作流程。
我能用 Suno 歌曲做 AI 口型同步音樂影片嗎?
可以。
有了歌曲之後,你就可以把音訊用在相容的 AI 影片工具上。有些平臺也提供與 Suno 相關的直接匯入工作流程。
每個場景都需要口型同步嗎?
不需要。
很多時候,把表演畫面與故事場景、氛圍、B-roll、舞蹈和其他視覺想法混在一起,影片會更有電影感。
在看見歌手表演能增加情感或音樂價值的地方,再使用口型同步。
AI 能做出完整的表演音樂影片嗎?
可以,但這比讓人像動起來更複雜。
一支完整的表演 MV,可能需要歌曲分析、場景規劃、角色一致性、表演生成、口型同步、懂節拍的時序、剪輯,以及選擇性重生成。
這就是為什麼底層工作流程,和口型同步模型本身一樣重要。
把你的歌做成一場表演,而不只是會唱歌的虛擬角色
令人信服的 AI 音樂影片,需要的不只是一張會動的嘴。
表演者需要在鏡頭與鏡頭之間,感覺是同一個人。
運鏡需要有目的地改變。
故事需要呼吸的空間。
剪輯需要回應音樂。
而藝人開口唱歌的那些時刻,應該感覺是刻意安排的。
這才是做出一段 AI 演唱片段,和導演一支 AI 表演音樂影片之間真正的差別。
如果你已經有歌曲,可以先從 BeatViz AI 音樂影片生成器 開始,再透過 Workflow 或 AI Director 發展概念,當個別表演鏡頭需要更精準的掌控時,再進入 Editor 。
圍繞你的歌曲打造表演——而不是反過來。