Najlepsze generatory teledysków AI z lip sync do wideo śpiewających i performance
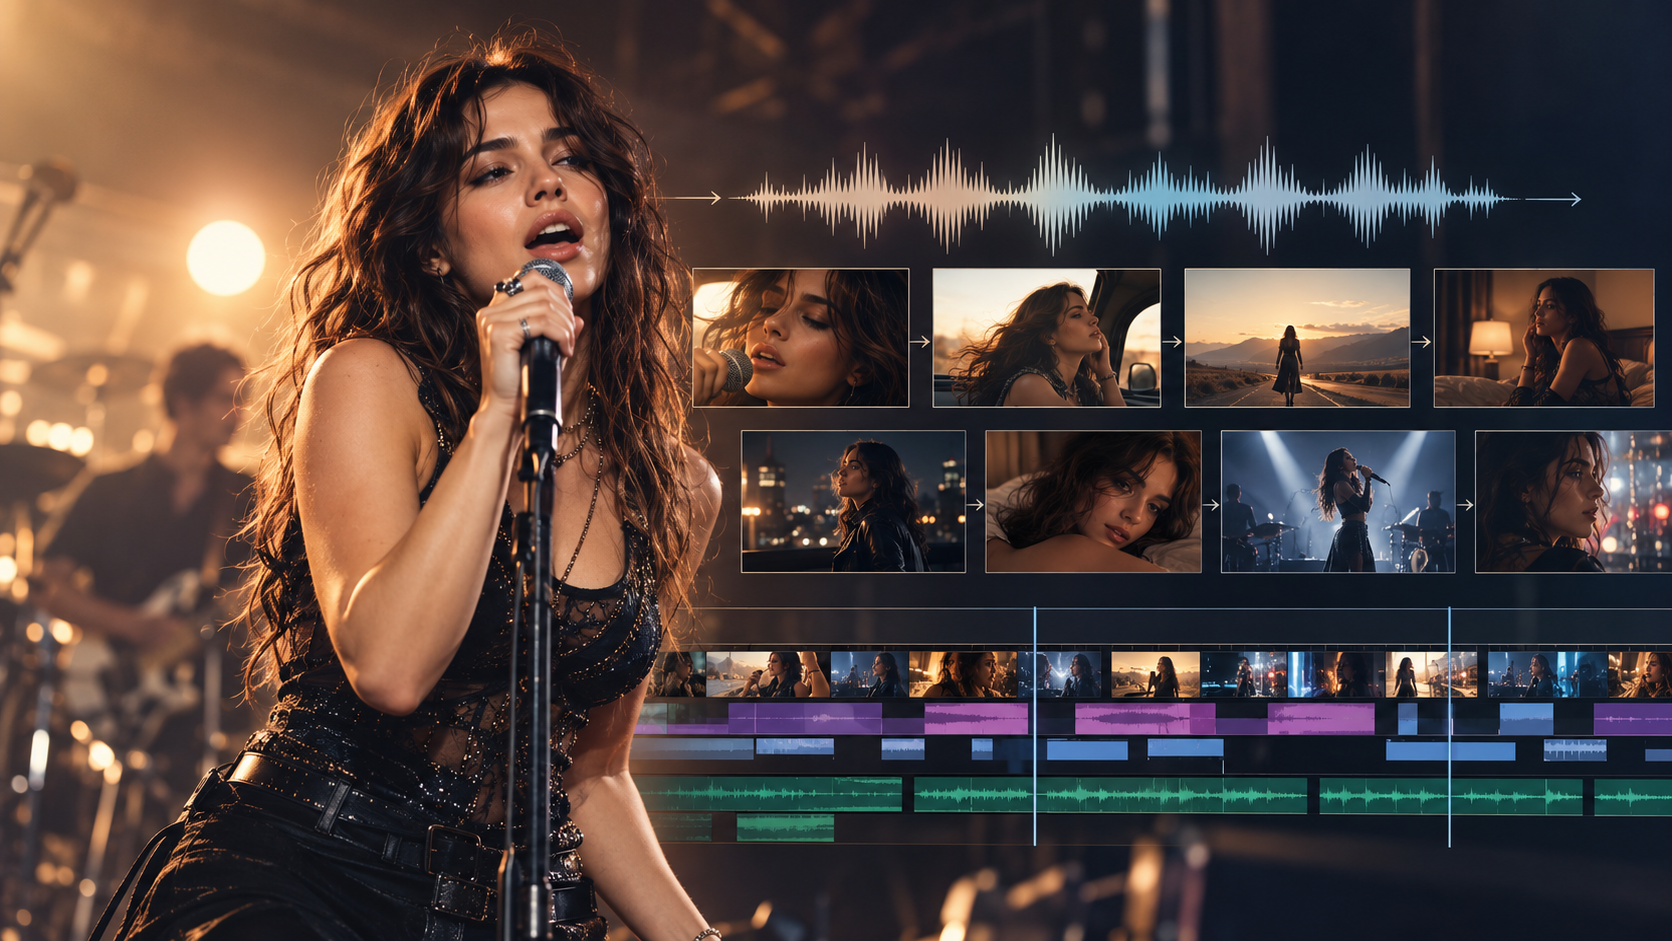
Wokalista na scenie to jeszcze nie to, co sprawia, że teledysk performance jest przekonujący.
Trudna część polega na tym, by wykonawca naprawdę czuł się związany z utworem.
Usta muszą iść za wokalem. Mimika musi pasować do interpretacji. Ten sam artysta musi pozostać rozpoznawalny, gdy kamera zmienia kąt. I — równie ważne — wideo musi wiedzieć, kiedy nie pokazywać śpiewu.
Dlatego wybór generatora teledysków AI z lip sync różni się od wyboru zwykłego generatora wideo AI.
Jedne narzędzia świetnie sprawiają, że pojedynczy portret śpiewa. Inne potrafią zsynchronizować postać z kilkoma minutami audio. Mniejsza grupa łączy lip sync z planowaniem scen, spójnością postaci, montażem świadomym muzyki i kompletnym, wieloscenowym procesem teledysku.
Jeśli masz już gotową ścieżkę i chcesz zobaczyć, jak te elementy mogą ze sobą pracować, generator teledysków AI BeatViz jest zaprojektowany wokół kompletnej produkcji od utworu do wideo, a nie izolowanych klipów AI.
Ten przewodnik porównuje siedem aktualnych opcji do wideo śpiewających i teledysków performance, w tym BeatViz, Neural Frames, Freebeat, Revid, Kaiber, HeyGen i Hedra.
Celem nie jest po prostu pytanie:
Czy to narzędzie rusza ustami postaci?
Lepsze pytanie:
Czy to narzędzie pomaga zamienić ten występ w prawdziwy teledysk?
Który generator teledysków AI obsługuje lip sync?
Kilka platform wideo AI obsługuje dziś jakąś formę śpiewu albo wokalnego lip sync.
Ważna różnica polega na tym, jak ten lip sync wpisuje się w resztę produkcji.
| Narzędzie | Lip Sync | Pełny proces teledysku | Najlepsze do |
|---|---|---|---|
| BeatViz | Tak, na poziomie klipu | Tak | Pełne performance MV z kontrolą na poziomie sceny |
| Neural Frames | Tak, przez Vocal Video | Tak | Wideo reagujące na muzykę z wybranymi scenami śpiewu |
| Freebeat | Tak, tryb Singing MV | Tak | Szybkie, automatyczne teledyski śpiewające |
| Revid | Tak | Tak | Szybkie teledyski łączące tekst, timing beatu i wokalistów |
| Kaiber | Tak, lip sync obrazu i wideo | Częściowy / modułowy | Kreatywne, pojedyncze klipy performance |
| HeyGen | Tak | Skupiony na wykonawcy | Sprawianie, by portret albo avatar śpiewał |
| Hedra | Tak | Skupiony na postaci | Dłuższe występy postaci sterowane audio |
Ta różnica ma znaczenie, bo wideo śpiewające AI i kompletny teledysk performance to niekoniecznie to samo.
Na przykład HeyGen potrafi animować portret do utworu, a Kaiber nałożyć lip sync sterowany audio na obraz albo istniejące wideo. BeatViz, Neural Frames, Freebeat i Revid idą dalej, wstawiając ujęcia śpiewu w szersze procesy teledysku.
Lip Sync, Beat Sync i Lyric Sync: to nie to samo
Jednym powodem, dla którego narzędzia do teledysków AI bywają mylące, jest to, że lip sync, beat sync i lyric sync często traktuje się jak synonimy.
Nie są.
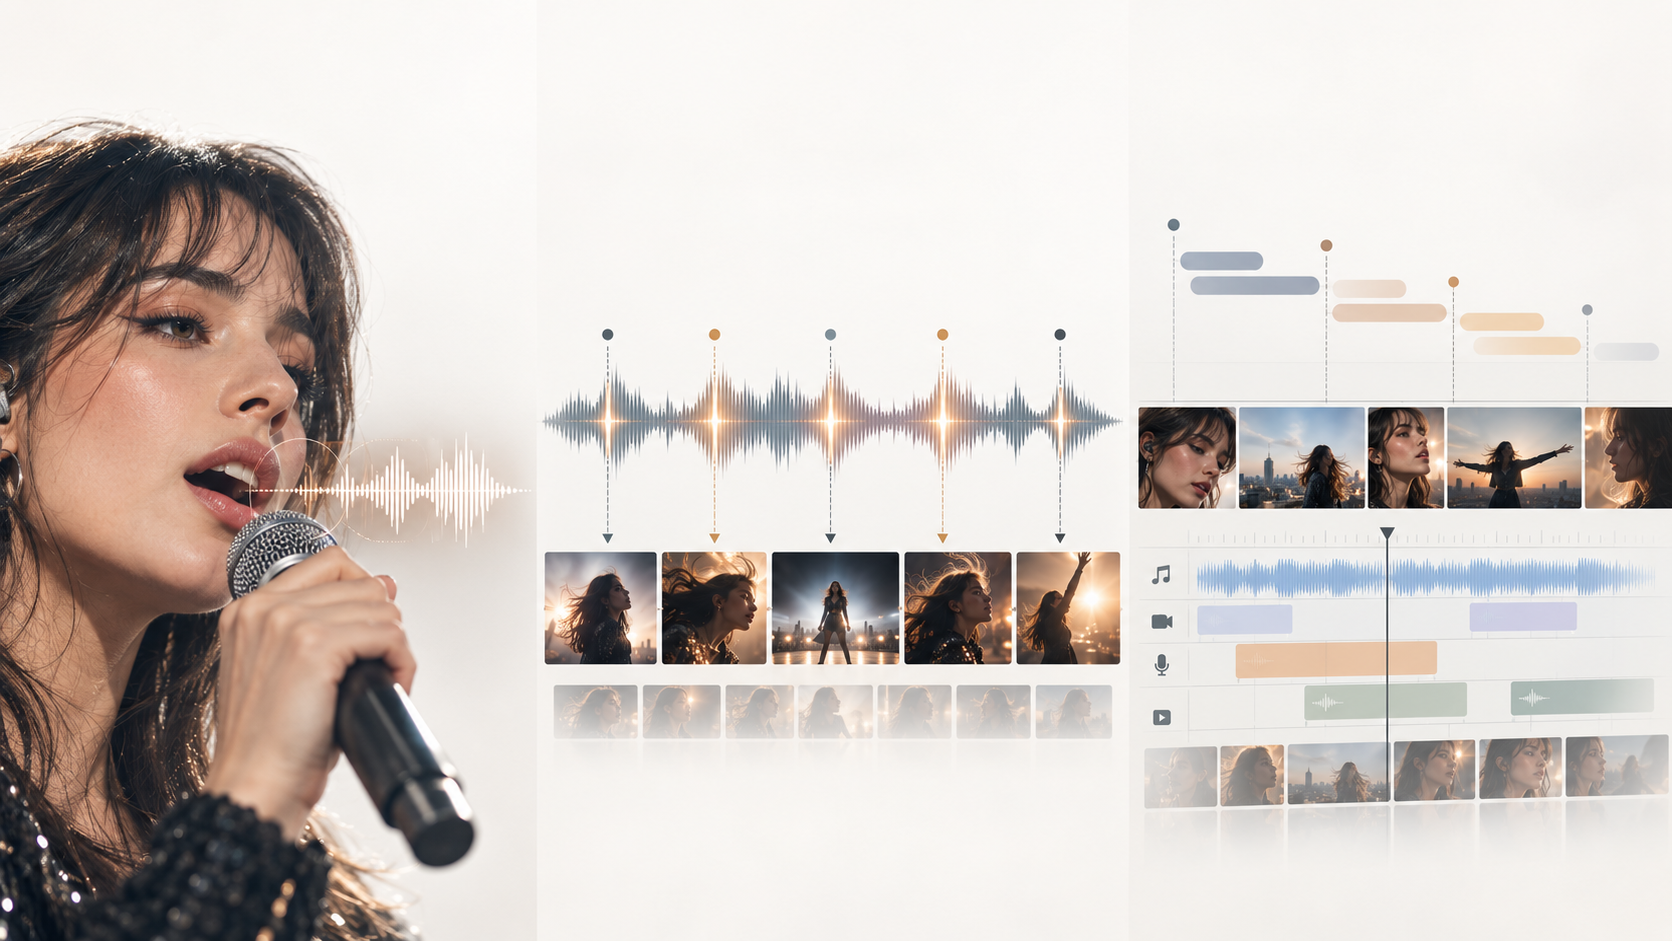
Lip Sync
Lip sync steruje relacją między wokalem a ustami wykonawcy.
Jeśli wokalista wypowiada słowo zaczynające się od spółgłoski z zamkniętymi ustami, wizualny występ powinien oddać ten dźwięk w przybliżeniu we właściwym momencie.
Przekonujący śpiew to jednak więcej niż kształty ust.
Zbliżenia performance zależą też od:
- •mimiki
- •ruchu oczu
- •ruchu głowy
- •oddechu i frazowania
- •ruchu ciała
- •emocjonalnej interpretacji
Technicznie zsynchronizowane usta nadal mogą wyglądać sztucznie, jeśli wszystko wokół nich jest zamrożone.
Beat Sync
Beat sync dotyczy montażu, a nie twarzy wokalisty.
Cięcia, przejścia, zmiany kamery, efekty wizualne i długości scen mogą iść za rytmem muzyki.
Szybki refren może używać krótszych cięć.
Wolny mostek może trzymać jedno ujęcie dłużej.
Drop może wyzwolić zmianę sceny.
To sprawia, że wideo czuje się muzycznie powiązane nawet wtedy, gdy na ekranie nikogo nie widać.
Lyric Sync
Lyric sync dotyczy timingu słów, napisów albo koncepcji wizualnych względem rzeczywistego tekstu.
Może być tak prosty jak napisy w stylu karaoke.
Może też oznaczać zaprojektowanie sceny wokół znaczenia konkretnego wersu.
Revid na przykład obecnie rozdziela timing tekstu, timing beatu i opcjonalny lip sync wokalisty w swoim procesie teledysku.
Najmocniejsze wideo performance często używają wszystkich trzech.
Lip sync steruje wykonawcą. Beat sync steruje montażem. Lyric sync pomaga powiązać obraz z tym, co mówi utwór.
Jak porównywaliśmy generatory teledysków AI z lip sync
To nie jest kontrolowany test laboratoryjny, w którym ten sam wokalista, utwór, seed, prompt i warunki GPU były sprawdzane na każdej platformie.
Porównanie skupia się na aktualnych, udokumentowanych procesach każdego produktu i na praktycznych pytaniach, które zadałby muzyk przy wyborze:
- •Jak nakładany jest lip sync?
- •Czy możesz zdecydować, które sceny zawierają śpiew?
- •Czy ten sam wykonawca może pojawić się w wielu ujęciach?
- •Czy narzędzie ogarnia cały utwór, a nie jeden krótki klip?
- •Czy słabe ujęcie performance da się podmienić bez przebudowy wszystkiego?
- •Czy platforma rozumie strukturę muzyki, czy po prostu animuje twarz z pliku audio?
Te różnice znaczą więcej dla pełnego performance MV niż proste tak-lub-nie przy checkboxie lip sync.
7 najlepszych generatorów teledysków AI z lip sync
1. BeatViz — najlepszy do wbudowania lip sync w pełny teledysk performance
BeatViz traktuje lip sync jako jedną część szerszego procesu produkcji teledysku.
Zamiast zaczynać od twarzy i kazać jej śpiewać cały utwór, możesz zacząć od samej muzyki.
Platforma oferuje obecnie trzy powiązane podejścia:
- •Workflow do budowania kompletnego wideo krok po kroku.
- •AI Director do rozwijania teledysku w rozmowie.
- •Editor do bezpośredniej kontroli timeline i klipów.
Ta różnica szczególnie przydaje się przy wideo performance.
Trzyminutowy utwór rzadko potrzebuje trzech minut ciągłego lip sync.
Możesz chcieć zbliżenie performance w pierwszym refrenie, przejść do materiału narracyjnego w drugiej zwrotce, wrócić do wokalisty w mostku, a skończyć większą sekwencją występu.
To znaczy, że lip sync lepiej działa jako decyzja reżyserska niż jako efekt globalny.
Zacznij od wykonawcy, nie od ust
Dobry lip sync zaczyna się przed etapem lip sync.
Jeśli artysta zmienia tożsamość między ujęciami, idealnie zsynchronizowane usta nie uratują wideo.
W BeatViz Workflow możesz ustalić utwór, kierunek wizualny, postać, sceny, ujęcia i pierwsze klatki przed finalnym generowaniem wideo.
Łatwiej wtedy traktować wykonawcę jako powracającą postać, a nie tworzyć nową osobę przy każdym cięciu kamery.
Jeśli ciągłość postaci to twój główny problem, zobacz osobny przewodnik po najlepszych generatorach teledysków AI pod spójność postaci.

Reżyseruj występ z AI Director
Performance MV potrzebuje też decyzji kreatywnych.
Na przykład:
Zostaw pierwszą zwrotkę kinową i opartą na historii. W refrenie użyj ujęć performance prosto do kamery. Wróć do zbliżenia performance na ostatni hook.
To rodzaj reżyserii, który da się rozwijać przez BeatViz AI Director, zamiast ręcznie przekładać każdą decyzję kreatywną na osobne prompty generowania.
Nakładaj lip sync tam, gdzie naprawdę ma znaczenie
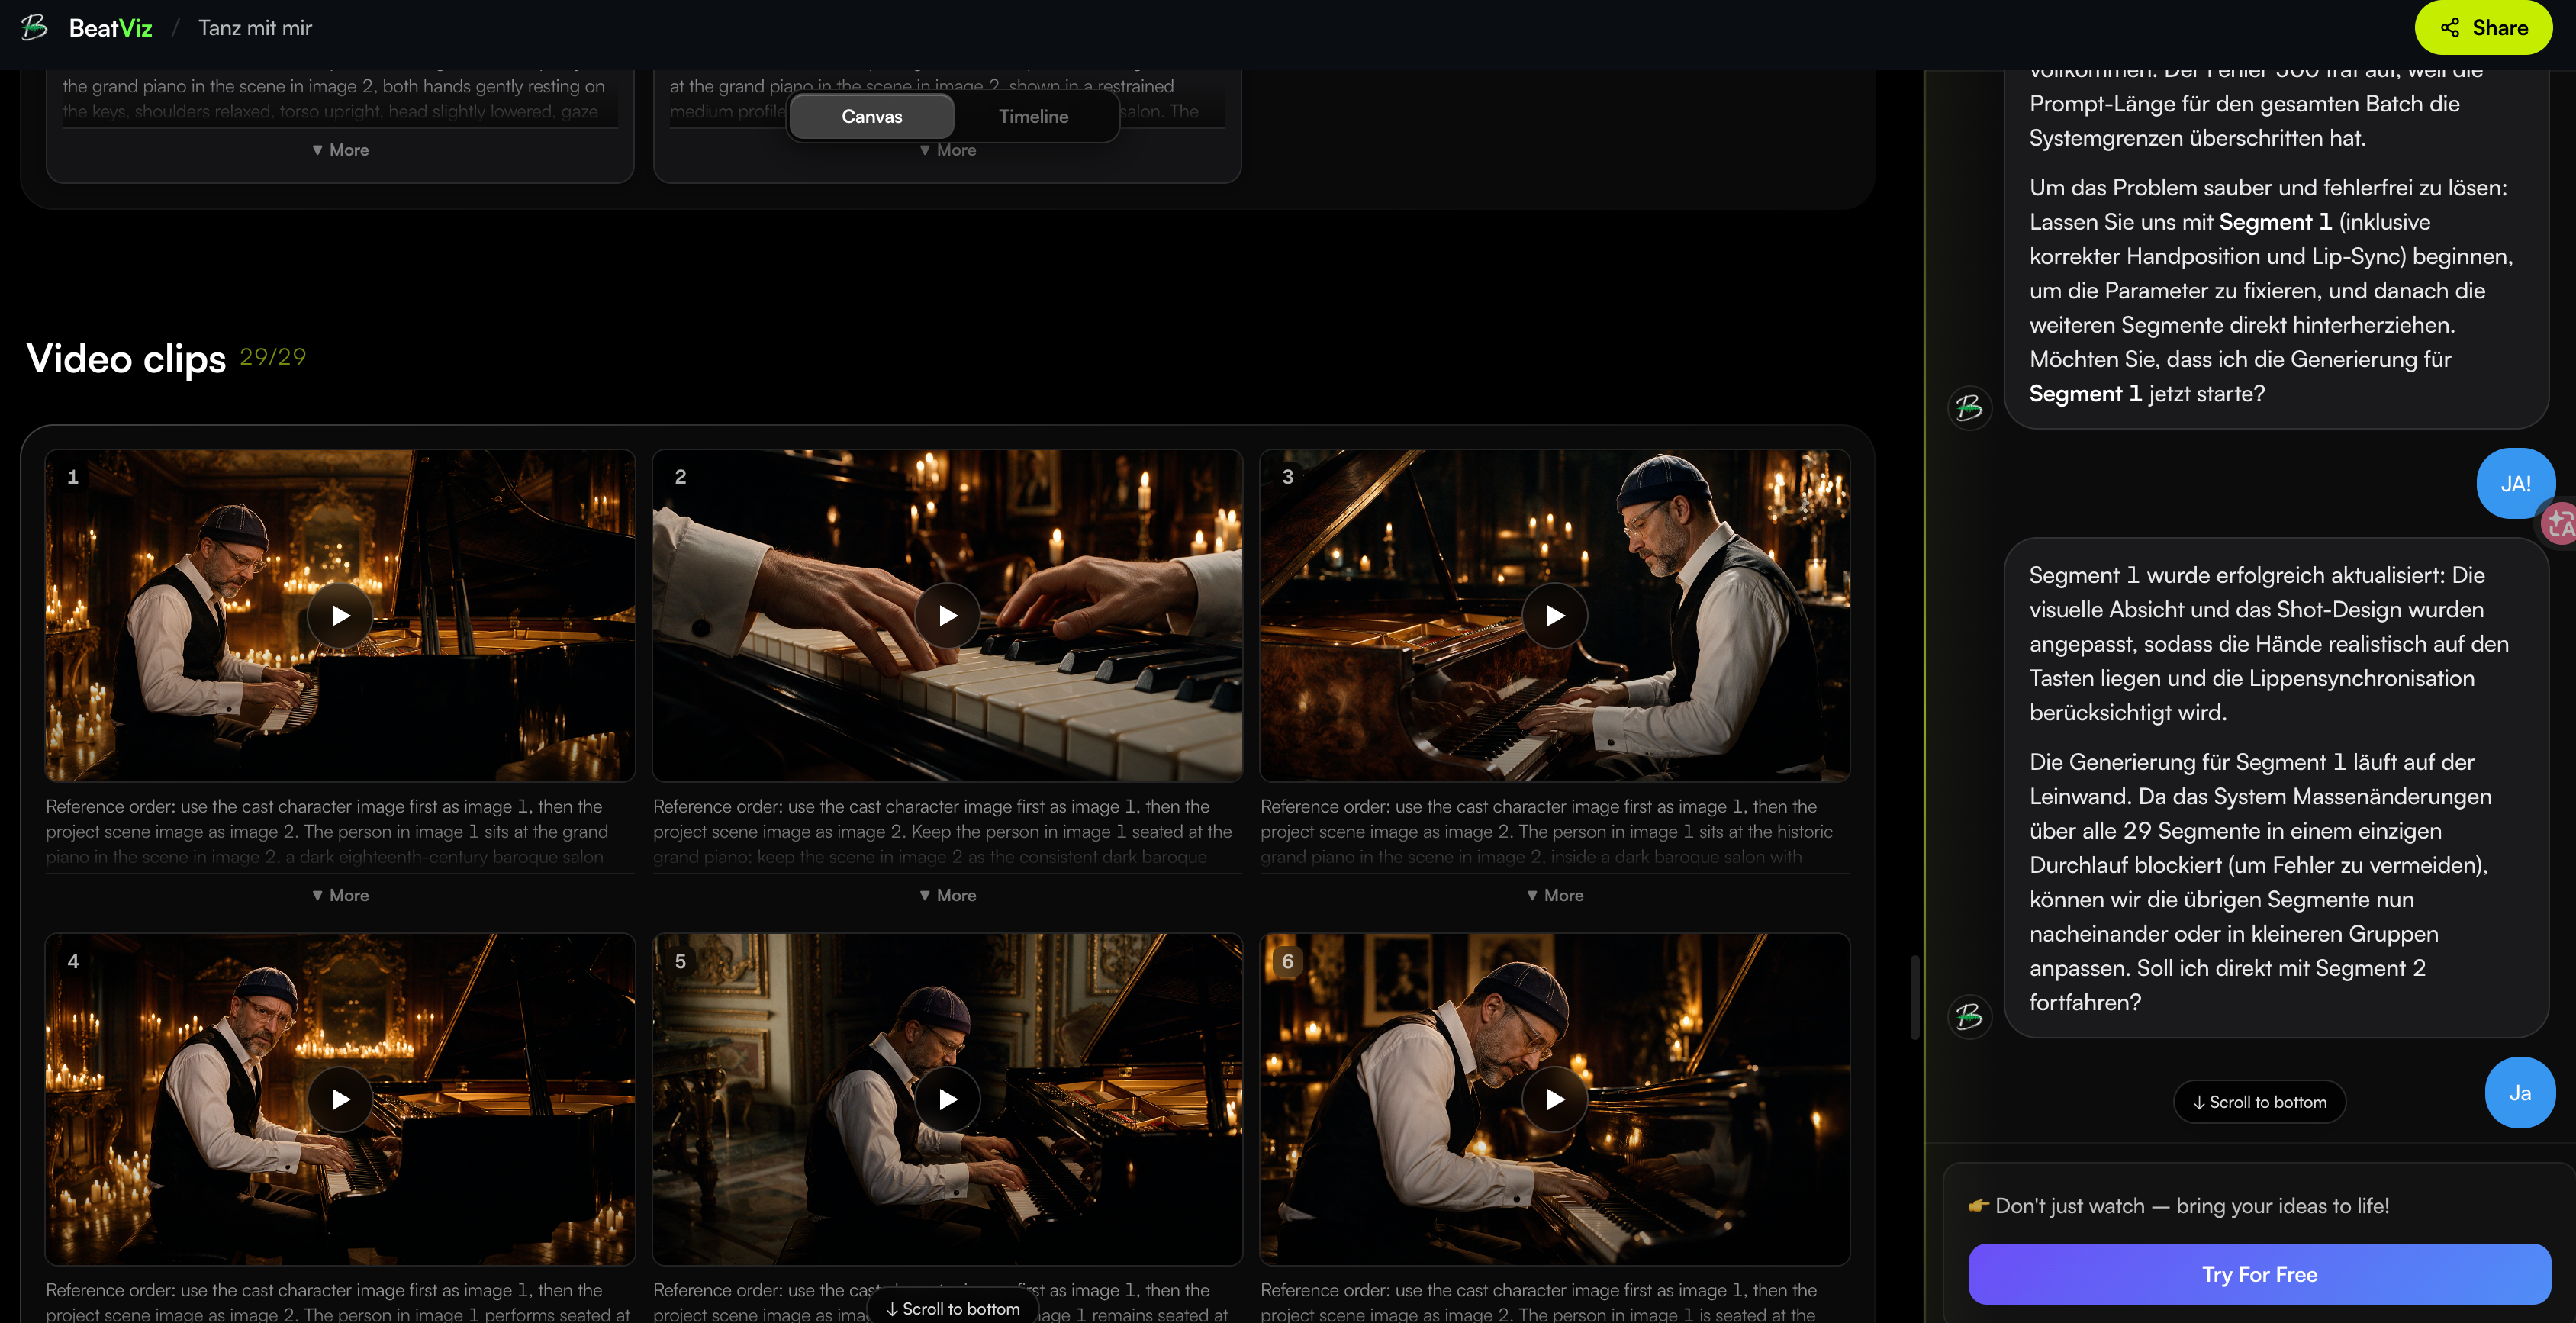
Najistotniejsza część BeatViz w tym porównaniu to Editor.
Gdy gotowy klip wideo leży na timeline audio, możesz wybrać ten pojedynczy klip i nałożyć LipSync, używając audio spod tego samego fragmentu.
BeatViz obecnie nakłada lip sync na poziomie wybranego klipu na timeline, a pojedyncze klipy lip sync są ograniczone do 15 sekund. To naturalnie zachęca do podejścia opartego na scenach: wygeneruj ujęcie performance, zsynchronizuj je z właściwą frazą wokalną, nałóż lip sync, a potem buduj resztę wideo wokół niego.
To przydaje się, gdy chcesz:
- •lip sync w refrenie, ale nie w instrumentalnym intro
- •żeby jedno konkretne zbliżenie śpiewało, a otaczające ujęcia pozostały kinowe
- •kilka momentów performance rozłożonych na cały utwór
- •możliwość podmiany jednego słabego klipu performance zamiast regenerowania całego wideo
Dlatego BeatViz szczególnie pasuje do twórców, którzy myślą kategoriami timeline teledysku, a nie tylko animowanego wokalisty.
Chcesz, żeby refren występował, a zwrotki zostały kinowe?
Zacznij od BeatViz Workflow, rozwiń kierunek wizualny w AI Director, a pojedyncze ujęcia wokalne dopracuj w Editor.
Głębszy przewodnik po montażu znajdziesz w BeatViz Editor Tutorial.
2. Neural Frames — najlepszy do Vocal Video z kontrolą reagującą na muzykę
Neural Frames to kolejna mocna opcja, gdy wykonawca ma istnieć wewnątrz szerszej struktury teledysku.
Proces Autopilot idzie przez muzykę, setup ścieżki, tworzenie storyboardu i finalne generowanie wideo.
Tryb Vocal Video platformy jest zaprojektowany tak, by postacie śpiewały wraz z wgranym utworem.
Co ważniejsze, Vocal Video niekoniecznie zmusza każdą scenę do śpiewu. Aktualny proces potrafi włączyć lip sync na wybranych klipach albo konkretnych keyframes, co pomaga łączyć występ wokalny z materiałem bez śpiewu.
Neural Frames obsługuje też kilka sterowalnych postaci w Autopilot i pozwala poprawiać pojedyncze sceny w storyboardzie przed finalnym generowaniem. Dokumentacja obecnie podaje projekty Autopilot do 15 minut.
Najlepsze dla: twórców, którzy chcą system wideo reagujący na audio, ze szczegółową kontrolą storyboardu i wybiórczymi scenami śpiewu.
Na co uważać: interfejs daje wiele zmiennych kreatywnych. Ta elastyczność jest przydatna, ale ktoś, kto chce prostsze „wgraj utwór i dostań gotowe MV”, może woleć bardziej zautomatyzowany proces.
3. Freebeat — najlepszy do szybkich, automatycznych Singing MV
Freebeat to jeden z produktów najmocniej ustawionych wokół frazy Singing MV.
Aktualny proces pozwala wgrać muzykę albo zaimportować utwór, wybrać tryb tworzenia i zaznaczyć Singing MV, gdy chcesz rezultat skupiony na wykonawcy.
Freebeat mówi, że system Singing MV potrafi stworzyć zsynchronizowanego wykonawcę ze zdjęcia, a jednocześnie ogarnąć analizę utworu, planowanie scen, ciągłość postaci i montaż świadomy beatu. Obecnie reklamuje pełną długość do sześciu minut na uprawnionych planach płatnych.
To czyni Freebeat atrakcyjnym, gdy priorytetem jest automatyzacja.
Zamiast ręcznie decydować, jak ma być zbudowane każde ujęcie performance, możesz pozwolić systemowi złożyć znacznie więcej wideo automatycznie.
Najlepsze dla: muzyków, którzy chcą szybko przejść od utworu do MV skupionego na śpiewie, przy stosunkowo małym setupie ręcznym.
Na co uważać: automatyzacja i kontrola reżyserska to nie to samo. Jeśli zależy ci na precyzyjnym wyborze kąta kamery w konkretnym refrenie albo ręcznym przebudowywaniu pojedynczych ujęć, dokładnie porównaj proces montażu przed wyborem.
4. Revid — najlepszy do łączenia lip sync wokalisty, tekstu i szybkiego generowania teledysku
Revid szczególnie jasno pokazuje różnicę między formami synchronizacji.
Aktualny proces teledysku pozwala wgrać ścieżkę albo użyć linku Suno, wybrać kierunek wizualny, timing tekstu albo beatu i opcjonalnie włączyć wokalistę, który lip-syncuje tekst.
Wygenerowany rezultat otwiera się w edytorze, gdzie sceny da się zmienić przed eksportem.
To połączenie czyni Revid szczególnie ciekawym dla twórców produkujących:
- •utwory mocno oparte na tekście
- •wideo rapowe
- •pionowe treści muzyczne do social media
- •wideo, w których napisy i występ wokalisty muszą ze sobą współpracować
Możliwość traktowania tekstu, timingu montażu i śpiewającej postaci jako osobnych warstw jest przydatna.
Utwór może iść za tekstem, nie pokazując wokalisty w każdym ujęciu.
Najlepsze dla: szybkich teledysków zorientowanych na twórców, w których liczą się tekst, formaty social i występ wokalny.
5. Kaiber — najlepszy do kreatywnych ujęć lip sync z obrazu i wideo
Kaiber to trochę inny rodzaj opcji.
Zamiast myśleć wyłącznie kategoriami w pełni zautomatyzowanego pipeline’u teledysku, Kaiber oferuje procesy Image Lip Sync i Video Lip Sync.
Image Lip Sync zaczyna od nieruchomego obrazu i audio.
Video Lip Sync zaczyna od istniejącego materiału wideo i audio.
Kaiber obecnie dokumentuje wsparcie Image Lip Sync dopasowującego audio do 300 sekund, a Video Lip Sync — audio do 30 sekund. Firma poleca też używać wyraźnego, zwróconego do kamery, pojedynczego podmiotu i testować krótsze fragmenty audio, zanim zdecydujesz się na dłuższe generacje.
To czyni Kaiber przydatnym, gdy już dokładnie wiesz, jak ma wyglądać ujęcie performance.
Na przykład możesz już mieć:
- •mocny portret wokalisty
- •wygenerowany obraz performance
- •istniejące, kinowe ujęcie wideo
- •konkretne zbliżenie, które chcesz zsynchronizować
Zamiast prosić jedno narzędzie o całe MV, możesz użyć Kaiber jako jednego etapu w szerszym procesie.
Najlepsze dla: pojedynczych, stylizowanych ujęć śpiewu i twórców, którzy wolą składać własny pipeline produkcyjny.
6. HeyGen — najlepszy do sprawiania, by zdjęcie śpiewało
Czasem nie potrzebujesz kompletnego teledysku.
Chcesz tylko przekonującą, śpiewającą postać.
Tu dobrze wpisuje się proces Make Photo Sing w HeyGen.
Aktualne narzędzie zaczyna od portretu i ścieżki audio, a potem animuje twarz tak, by szła za utworem. HeyGen ustawia tę funkcję wokół realistycznego ruchu ust i mimiki i poleca wyraźny, frontalny portret jako obraz startowy.
To przydaje się do:
krótkich klipów social, wirtualnych wokalistów, eksperymentów z postaciami, animowanych portretów, memów i wstawek performance.
Jest jednak ważna różnica.
Dobre narzędzie do śpiewającego avatara nie jest automatycznie pełnym systemem produkcji teledysku.
Jeśli cały cel to:
Chcę, żeby to zdjęcie śpiewało mój utwór.
HeyGen jest logiczną opcją.
Jeśli celem jest:
Chcę trzyminutowy teledysk ze scenami historii, lokacjami, zmianami kamery, fragmentami performance i wieloma pomysłami wizualnymi.
prawdopodobnie będziesz potrzebować szerszego procesu wokół tego narzędzia.
Najlepsze dla: śpiewających portretów i klipów skupionych na wykonawcy.
7. Hedra — najlepszy do dłuższych występów postaci sterowanych audio
Hedra to kolejna mocna opcja występu postaci.
Aktualne procesy Hedra Avatar i Character 3 są zbudowane wokół generowania z obrazu + audio, z lip sync i ruchem twarzy sterowanym ścieżką dźwiękową.
Hedra obecnie obsługuje długie, sterowane audio generowanie avatara do 10 minut i wprost wymienia mówienie oraz śpiew jako zastosowania.
To czyni Hedra szczególnie ciekawym, gdy koncept kreatywny opiera się na jednej postaci dającej długi, ciągły występ wokalny.
Na przykład:
stylizowany wirtualny wokalista, występ studyjny ze stałą kamerą, animowana postać śpiewająca do kamery albo dłuższa prezentacja wokalna.
Ciągłe ujęcie postaci sterowane audio i teledysk z wieloma lokacjami to jednak dwa różne problemy produkcyjne.
Jeśli chcesz ciągłe zmiany scen, rozwój historii, wiele ustawień kamery i pacing teledysku, nadal możesz potrzebować osobnego procesu montażu wokół tych wygenerowanych występów.
Najlepsze dla: dłuższych występów śpiewającej postaci i avatara, w których główne wymaganie to animacja twarzy sterowana audio.
Które narzędzie AI lip sync do teledysku wybrać?
Nie ma jednej poprawnej odpowiedzi, bo „teledysk z lip sync” może oznaczać bardzo różne rzeczy.
Jeśli chcesz, żeby jedno zdjęcie śpiewało, zacznij od specjalisty takiego jak HeyGen.
Jeśli masz już mocny obraz albo wideo i głównie potrzebujesz zamienić je w ujęcie śpiewu, warto rozważyć Kaiber.
Jeśli chcesz długi, ciągły występ postaci, Hedra jest szczególnie na miejscu.
Jeśli priorytetem jest szybkie, automatyczne generowanie od utworu do wideo, Freebeat i Revid oferują mocno zautomatyzowane podejścia.
Jeśli chcesz storyboard świadomy muzyki z wybranymi scenami Vocal Video, Neural Frames daje sporo kontroli.
A jeśli celem jest traktować lip sync jako jeden element pełnego performance MV — ze scenami narracyjnymi, powracającymi postaciami, planowaniem ujęć i montażem na timeline — BeatViz jest zaprojektowany wokół tej struktury produkcji.
Dlatego warto zdefiniować pożądane, finalne wideo, zanim wybierzesz technologię lip sync.
Chcesz śpiewającego avatara?
- •Klip social?
- •Wizualizer?
- •Lyric video?
- •Czy prawdziwy, wieloscenowy teledysk?
To różne zadania.
Planujesz pełne wydanie, a nie jeden śpiewający klip?
Zobacz kompletny proces teledysku BeatViz, a potem sprawdź BeatViz Pricing , zanim zdecydujesz, ile utworu chcesz wygenerować i dopracować.
Jak BeatViz używa lip sync wewnątrz pełnego teledysku
Lip sync działa najlepiej, gdy jest wpisany w kreatywną strukturę utworu.
Weźmy hipotetyczną, trzyminutową ścieżkę pop-rock.
Intro otwiera się obrazami środowiska.
Pierwsza zwrotka śledzi artystę przez puste mieszkanie.
Pre-chorus tnie bliżej wokalisty.
Potem refren staje się bezpośrednim występem.
Druga zwrotka wraca do materiału historii.
Mostek używa jednego intymnego zbliżenia.
Ostatni refren rozszerza się w większą sekwencję występu.
Tylko część tych scen potrzebuje, by usta szły za wokalem.
Reszta wideo nadal powinna reagować na muzykę.
Dlatego proces BeatViz oddziela szerokie planowanie kreatywne od finalnego dopracowania klipów.
Workflow: zbuduj wideo, zanim dopracujesz ujęcia śpiewu
Zacznij od wgrania ścieżki w Workflow.
Zbuduj koncept kreatywny.
Ustal postać.
Przejrzyj sceny.
Przejrzyj keyframes, zanim zdecydujesz się na finalny ruch.
To ma znaczenie, bo spójność postaci zwykle łatwiej rozwiązać przed wygenerowaniem występu z lip sync niż po nim.
Mocna pierwsza klatka daje modelowi generowania jaśniejsze informacje o twarzy, włosach, garderobie, świetle, kompozycji i kącie kamery.
Pełniejsze wyjaśnienie całego procesu znajdziesz w Jak zamienić muzykę w wideo z AI.
AI Director: zdecyduj, kiedy artysta występuje
Następnie myśl jak reżyser, a nie jak technik lip sync.
Możesz użyć AI Director , żeby opisać, jaką rolę występ ma odgrywać w wideo.
Na przykład:
Zostaw otwarcie kinowe, bez śpiewu. Wprowadź artystę w średnim ujęciu performance w pre-chorus. Użyj bezpośredniego zbliżenia z lip sync w refrenie, a po hooku wróć do materiału narracyjnego.
Ta instrukcja zawiera znacznie więcej przydatnej informacji kreatywnej niż:
Zrób całe wideo z lip sync.
Editor: popraw ujęcia, które mają znaczenie
Na końcu użyj BeatViz Editor , gdy pojedyncze ujęcia potrzebują więcej kontroli.
Klip performance można zsynchronizować z właściwym audio na timeline i nałożyć lip sync niezależnie.
Jeśli jeden klip nie wypali, możesz pracować nad tym fragmentem, nie traktując całego gotowego teledysku jako do wyrzucenia.
To podejście na poziomie sceny jest szczególnie cenne, bo wideo generatywne jest probabilistyczne.
Celem nie jest oczekiwanie, że każde ujęcie będzie idealne za pierwszym razem.
Celem jest proces, w którym słabe ujęcia da się znaleźć i poprawić, nie przebudowując wszystkiego wokół nich.
Dlaczego nie powinieneś nakładać lip sync na każde ujęcie teledysku
Jeden z najłatwiejszych sposobów, by teledysk AI czuł się powtarzalny, to kazać wykonawcy śpiewać bez przerwy.
Prawdziwe teledyski często przechodzą między różnymi funkcjami wizualnymi.
Jedno ujęcie ustanawia wykonawcę.
Inne rozwija historię.
Inne buduje atmosferę.
Inne podkreśla garderobę albo choreografię.
Inne reaguje na przerwę instrumentalną.
Potem wideo wraca do artysty, gdy zobaczenie występu wokalnego naprawdę coś dodaje.
Traktuj materiał performance jak interpunkcję.
Mocne zbliżenie przy ważnym wersie może być silne właśnie dlatego, że przez poprzednie dwie minuty nie oglądałeś tych samych ust w ruchu.
Przydatna struktura może wyglądać tak:
Performance → Historia → Środowisko → Performance → B-roll → Taniec → Zbliżenie → Historia → Finalny performance
To nadaje fragmentom lip sync większą wagę.
Może też zmniejszyć liczbę trudnych ujęć twarzy, które musisz wygenerować.
To jeden z powodów, dla których nasz szerszy przewodnik po zamianie muzyki w wideo z AI traktuje lip sync jako decyzję kreatywną na poziomie sceny, a nie definicję całego wideo.
Wskazówki do lepszych ujęć śpiewu i lip sync AI
Użyj jednego, wyraźnie widocznego wokalisty
Modele lip sync zwykle działają lepiej, gdy jasno wiedzą, która twarz ma iść za audio.
Przy ważnych momentach wokalnych unikaj kilku równie prominentnych twarzy w kadrze, chyba że narzędzie wprost obsługuje wielu mówców albo wykonawców.
Daj twarzy dość miejsca na ekranie
Bardzo szerokie ujęcie całego ciała może ukryć ruch ust.
Ekstremalne zbliżenie może mocniej obnażyć artefakty twarzy.
Średnie ujęcia, półzbliżenia i klasyczne zbliżenia często są bezpieczniejszym punktem startu.
Własne wskazówki Kaiber dotyczące lip sync też zalecają zwracać uwagę na odległość kamery i używać wyraźnie widocznego, zwróconego do przodu podmiotu.
Najpierw ustal spójność postaci
Jeśli struktura twarzy wokalisty zmienia się między każdym ujęciem performance, poprawa ruchu ust nie rozwiąże większego problemu ciągłości.
Zablokuj wykonawcę, zanim spędzisz czas na dopracowywaniu animacji wokalnej.
Używaj występu tam, gdzie publiczność go oczekuje
Refren, emocjonalny hook, wers prosto do kamery, zwrotka rapowa albo kulminacja wokalu zwykle bardziej korzystają z lip sync niż przejście albo fragment instrumentalny.
Najlepsze generacje zużywaj tam, gdzie widzowie najpewniej patrzą na twarz wykonawcy.
Przetestuj trudne wokale, zanim wyrenderujesz za dużo
Szybki rap, ostre spółgłoski, nakładające się wokale, ad-liby, harmonie i nietypowe frazowanie mogą być bardziej wymagające niż wolna, czysta linia wokalna.
Test reprezentatywnego fragmentu najpierw pomaga zrozumieć, jak narzędzie radzi sobie z twoją konkretną ścieżką.
Nie ignoruj pierwszej klatki
Model lip sync nadal potrzebuje wiarygodnego wykonawcy do animacji.
Włosy zasłaniające usta, ekstremalne profile, nietypowe zniekształcenie twarzy albo słaba jakość obrazu mogą wprowadzić problemy, zanim synchronizacja w ogóle się zacznie.
Czy możesz użyć lip sync z utworem z Suno?
Tak.
Gotowy utwór z Suno nadal jest plikiem audio, więc da się go użyć z narzędziami wideo AI, które przyjmują wgraną muzykę albo kompatybilny import utworu.
Ważniejsze pytanie: jaki rodzaj wideo chcesz wokół niego zbudować.
Jeśli chcesz tylko jednego avatara śpiewającego utwór, narzędzie od zdjęcia do śpiewu może wystarczyć.
Jeśli chcesz pełny teledysk, musisz też wziąć pod uwagę:
- •strukturę utworu
- •postacie
- •lokacje
- •opowieść wizualną
- •ujęcia performance
- •montaż
- •spójność scen
Ten proces opisujemy osobno w Jak stworzyć teledysk z Suno AI.
Możesz też wgrać gotową ścieżkę bezpośrednio do BeatViz Music Video Generator i budować produkcję wizualną od samego utworu.
Najczęściej zadawane pytania
Który generator teledysków AI obsługuje lip sync?
BeatViz, Neural Frames, Freebeat, Revid, Kaiber, HeyGen i Hedra obecnie oferują lip sync albo śpiew sterowany audio w różnych formach. Właściwa opcja zależy od tego, czy potrzebujesz jednej śpiewającej postaci, czy całego, wieloscenowego teledysku.
Jakie AI jest najlepsze do sprawienia, by wokalista śpiewał?
Do zamiany pojedynczego portretu w śpiewającą postać mocnymi opcjami są dedykowane narzędzia avatar i animacji zdjęcia, takie jak HeyGen i Hedra.
Do wbudowania tego wokalisty w kompletny teledysk szersze procesy od utworu do wideo dają platformy takie jak BeatViz, Neural Frames, Freebeat i Revid.
Czy AI potrafi zrobić lip sync całego utworu?
Tak, niektóre platformy obsługują kilka minut występu sterowanego audio.
Wygenerowanie jednej, ciągłej śpiewającej postaci różni się jednak od zbudowania pełnego teledysku.
W większości MV wybiórczy lip sync ważnych ujęć performance i mieszanie ich ze scenami bez śpiewu zwykle daje więcej różnorodności wizualnej.
Jaka jest różnica między lip sync a beat sync?
Lip sync synchronizuje usta wykonawcy z wokalem.
Beat sync ustawia decyzje montażowe — cięcia, przejścia albo timing scen — z rytmem muzyki.
Wideo może być zsynchronizowane z beatem, nawet jeśli nie ma w nim żadnego wokalisty.
Czy mogę zrobić wokalistę AI z jednego zdjęcia?
Tak. Narzędzia takie jak HeyGen, Hedra, Kaiber i Freebeat obecnie oferują procesy, które potrafią animować postać albo portret na podstawie audio.
Czy mogę użyć utworu z Suno do teledysku AI z lip sync?
Tak.
Gdy masz utwór, możesz użyć audio z kompatybilnymi narzędziami wideo AI. Część platform oferuje też bezpośrednie procesy importu związane z Suno.
Czy potrzebuję lip sync w każdej scenie?
Nie.
W wielu przypadkach wideo staje się bardziej kinowe, gdy materiał performance miesza się ze scenami historii, atmosferą, B-rollem, tańcem i innymi pomysłami wizualnymi.
Używaj lip sync tam, gdzie zobaczenie występu wokalisty dodaje wartość emocjonalną albo muzyczną.
Czy AI potrafi stworzyć pełny teledysk performance?
Tak, ale to bardziej złożone zadanie niż animacja portretu.
Kompletne performance MV może wymagać analizy utworu, planowania scen, spójności postaci, generowania występu, lip sync, timingu świadomego beatu, montażu i wybiórczej regeneracji.
Dlatego leżący u podstaw proces liczy się równie mocno jak model lip sync.
Zamień utwór w występ, a nie tylko w śpiewającego avatara
Przekonujący teledysk AI potrzebuje więcej niż ruszających się ust.
Wykonawca musi czuć się jak ta sama osoba z ujęcia na ujęcie.
Kamera musi zmieniać się z celem.
Historia potrzebuje przestrzeni, żeby oddychać.
Montaż musi reagować na muzykę.
A momenty, w których artysta śpiewa, powinny czuć się zamierzone.
To prawdziwa różnica między stworzeniem klipu śpiewającego AI a wyreżyserowaniem teledysku performance AI.
Jeśli masz już utwór, możesz zacząć od BeatViz AI Music Video Generator, rozwinąć koncept przez Workflow albo AI Director, a potem przejść do Editor , gdy pojedyncze ujęcia performance potrzebują ciaśniejszej kontroli.
Buduj występ wokół utworu — nie odwrotnie.