Beste AI-musikkvideogeneratorer med Lip Sync for sang- og opptredensvideoer
En sanger som står på scenen er ikke det som gjør en opptredensmusikkvideo overbevisende.
Den vanskelige delen er å få utøveren til faktisk å føles knyttet til sangen.
Munnen deres må følge vokalen. Uttrykkene deres må passe leveransen. Den samme artisten må forbli gjenkjennelig når kameraet endrer vinkel. Og like viktig: videoen må vite når den ikke skal vise dem synge.
Derfor er det å velge en AI-musikkvideogenerator med lip sync annerledes enn å velge en vanlig AI-videogenerator.
Noen verktøy er utmerkede til å få ett portrett til å synge. Andre kan synkronisere en figur til flere minutter lyd. En mindre gruppe kan kombinere lip sync med sceneplanlegging, figurkonsistens, musikkbevisst redigering og en komplett arbeidsflyt for musikkvideoer med flere scener.
Hvis du allerede har et ferdig spor og vil se hvordan de delene kan jobbe sammen, er BeatViz AI Music Video Generator designet rundt komplett sang-til-video-produksjon i stedet for isolerte AI-klipp.
Denne guiden sammenligner sju nåværende valg til AI-sangvideoer og opptredensmusikkvideoer, inkludert BeatViz, Neural Frames, Freebeat, Revid, Kaiber, HeyGen og Hedra.
Målet er ikke bare å spørre:
Kan dette verktøyet bevege en figurs munn?
Et bedre spørsmål er:
Kan dette verktøyet hjelpe med å gjøre den opptredenen om til en faktisk musikkvideo?
Hvilken AI-musikkvideogenerator støtter Lip Sync?
Flere AI-videoplattformer støtter nå en form for sang- eller vokal-lip-sync.
Den viktige forskjellen er hvordan den lip-syncen passer inn i resten av produksjonsprosessen.
| Verktøy | Lip Sync | Full musikkvideo-arbeidsflyt | Best til |
|---|---|---|---|
| BeatViz | Ja, på klippnivå | Ja | Fullstendige opptredens-MV-er med kontroll på scenenivå |
| Neural Frames | Ja, gjennom Vocal Video | Ja | Musikkreaktive videoer med valgte sangscener |
| Freebeat | Ja, Singing MV-modus | Ja | Raske automatiserte sangmusikkvideoer |
| Revid | Ja | Ja | Raske musikkvideoer som kombinerer tekster, beattiming og sangere |
| Kaiber | Ja, bilde- og video-lip-sync | Delvis / modulær | Kreative individuelle opptredenklipp |
| HeyGen | Ja | Utøverfokusert | Å få et portrett eller en avatar til å synge |
| Hedra | Ja | Figurfokusert | Lengre lyd-drevne figuropptredener |
Denne skillet betyr noe fordi en AI-sangvideo og en komplett opptredensmusikkvideo ikke nødvendigvis er det samme.
HeyGen kan for eksempel animere et portrett til en sang, mens Kaiber kan legge lyd-drevet lip sync på et bilde eller en eksisterende video. BeatViz, Neural Frames, Freebeat og Revid går lenger ved å plassere sangopptak inne i bredere musikkvideo-arbeidsflyter.
Lip Sync vs beatsynk vs tekstsynk: de er ikke det samme
En grunn til at AI-musikkvideoverktøy kan være forvirrende, er at begreper som lip sync, beatsynk og tekstsynk ofte behandles som om de betyr det samme.
Det gjør de ikke.
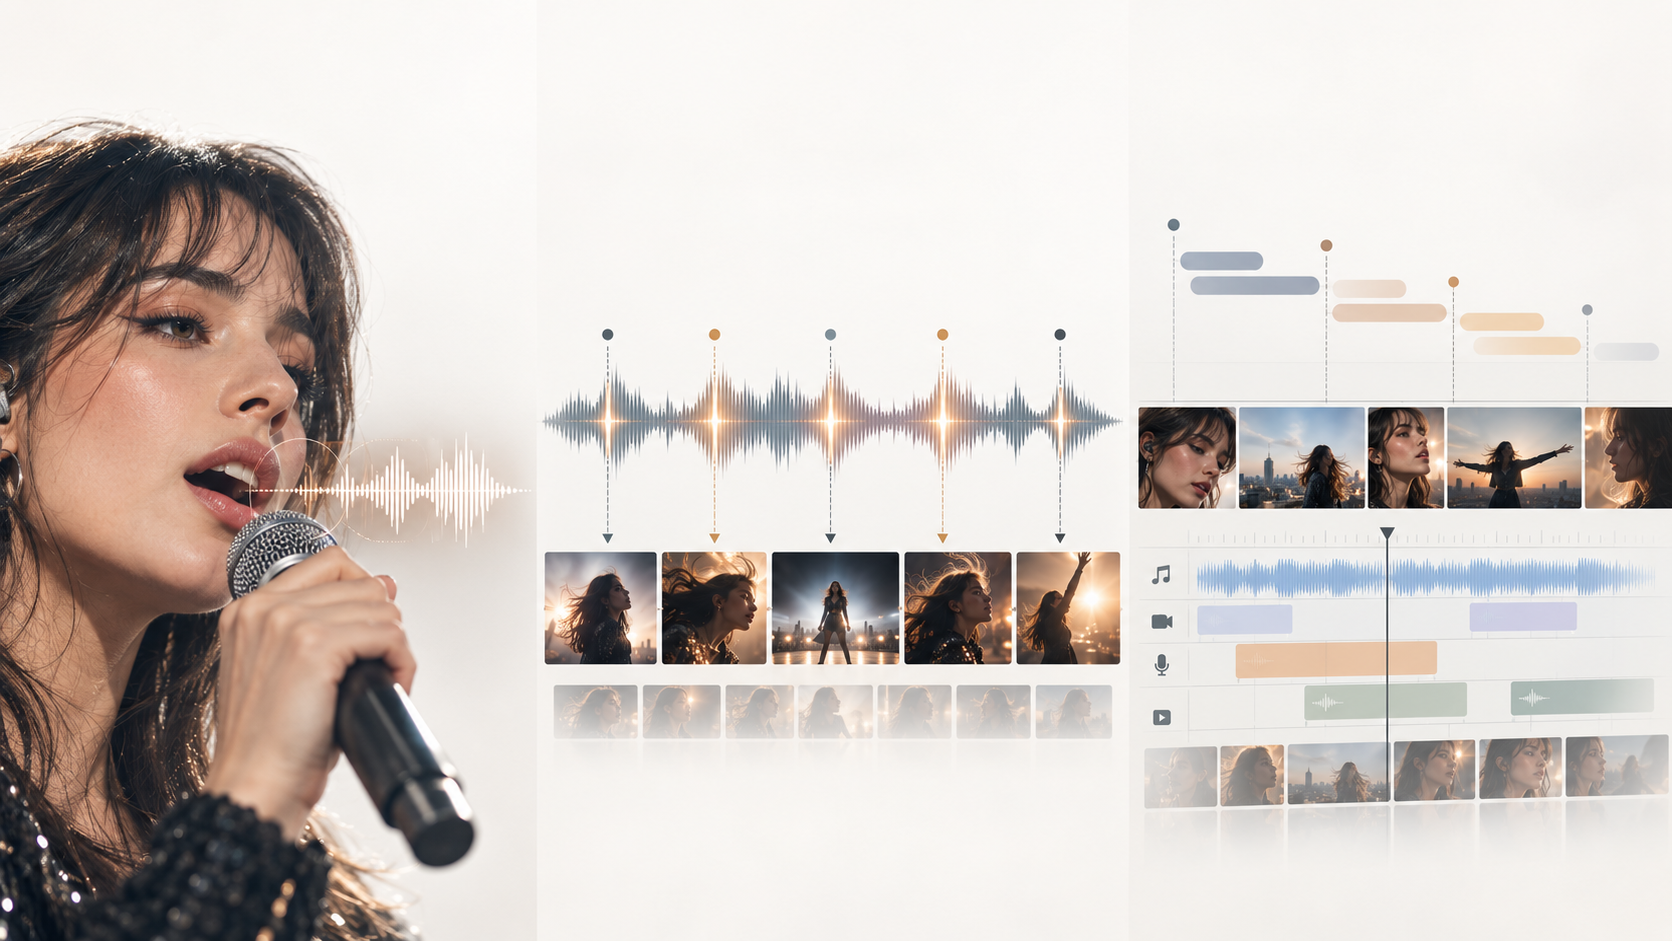
Lip Sync
Lip sync styrer forholdet mellom vokallyden og utøverens munn.
Hvis sangeren sier et ord som begynner med en lukket konsonant, bør den visuelle opptredenen speile den lyden omtrent på riktig øyeblikk.
Men overbevisende sang involverer mer enn munnformer.
Nærbilder av opptreden avhenger også av:
- •ansiktsuttrykk
- •øyebevegelse
- •hodebevegelse
- •pust og frasering
- •kroppsbevegelse
- •emosjonell levering
En teknisk synkronisert munn kan fortsatt se kunstig ut hvis alt rundt den føles frosset.
Beatsynk
Beatsynk påvirker klippet mer enn sangerens ansikt.
Kutt, overganger, kameraskift, visuelle effekter og scenevarigheter kan følge rytmen i musikken.
Et raskt refreng kan bruke kortere kutt.
En langsom bridge kan holde ett opptak lenger.
Et drop kan utløse en sceneovergang.
Det kan få en video til å føles musikalsk knyttet selv når ingen er synlig på skjermen.
Tekstsynk
Tekstsynk handler om timing av ord, undertekster eller visuelle konsepter i forhold til de faktiske tekstene.
Det kan være så enkelt som karaoke-stil-teksting.
Det kan også bety å designe en scene rundt meningen i en bestemt tekstlinje.
Revid skiller for eksempel for øyeblikket teksttiming, beattiming og valgfri sanger-lip-sync inne i musikkvideo-arbeidsflyten.
De sterkeste opptredensvideoene bruker ofte alle tre.
Lip sync styrer utøveren. Beatsynk styrer klippet. Tekstsynk hjelper med å knytte bildene til det sangen sier.
Hvordan vi sammenlignet AI-musikkvideogeneratorer med Lip Sync
Dette er ikke en kontrollert laboratoriebenchmark der samme sanger, sang, seed, prompt og GPU-forhold ble testet på tvers av hver plattform.
I stedet fokuserer sammenligningen på de nåværende dokumenterte arbeidsflytene til hvert produkt og de praktiske spørsmålene en musiker ville stille når de velger én:
- •Hvordan brukes lip sync?
- •Kan du bestemme hvilke scener som inneholder sang?
- •Kan den samme utøveren vises på tvers av flere opptak?
- •Kan verktøyet håndtere en hel sang i stedet for ett kort klipp?
- •Kan et dårlig opptredenopptak erstattes uten å bygge alt på nytt?
- •Forstår plattformen musikkstruktur, eller animerer den bare et ansikt fra en lydfil?
De forskjellene betyr mer for en full opptredens-MV enn en enkel ja-eller-nei-lip-sync-avkrysning.
7 beste AI-musikkvideogeneratorer med Lip Sync
1. BeatViz — Best til å bygge Lip Sync inn i en full opptredensmusikkvideo
BeatViz nærmer seg lip sync som én del av en større musikkvideoproduksjonsarbeidsflyt.
I stedet for å starte med et ansikt og be det synge et helt spor, kan du starte med musikken selv.
Plattformen tilbyr for øyeblikket tre sammenkoblede tilnærminger:
- •Workflow for å bygge en komplett video steg for steg.
- •AI Director for å utvikle musikkvideoen i samtaleform.
- •Editor for direkte tidslinje- og klippnivåkontroll.
Det skillet blir særlig nyttig for opptredensvideoer.
En tre minutter lang sang trenger sjelden tre minutter kontinuerlig lip sync.
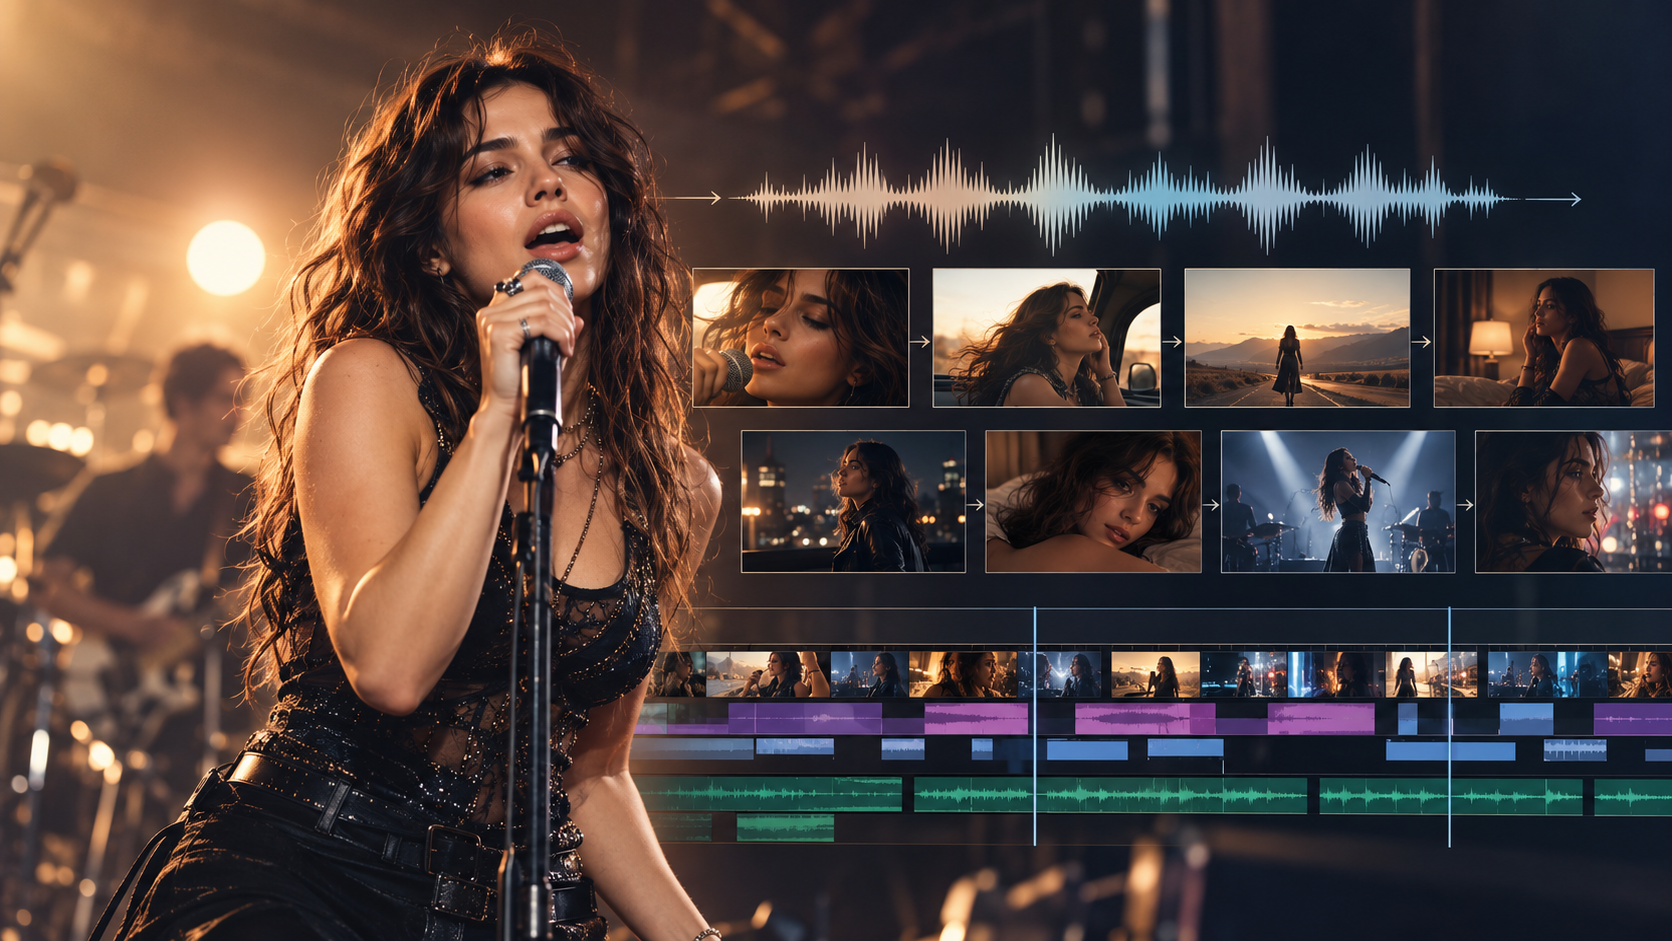
Du kan ville ha et nærbilde av opptreden i det første refrenget, bytte til narrativ footage i vers to, vende tilbake til sangeren i bridgen, og avslutte med en større opptredenssekvens.
Det betyr at lip sync fungerer bedre som en regibeslutning enn som en global effekt.
Start med utøveren, ikke munnen
God lip sync begynner før lip-sync-fasen.
Hvis artisten din endrer identitet mellom opptak, redder ikke perfekt synkroniserte lepper videoen.
I BeatViz Workflow kan du etablere sang, visuell retning, figur, scener, opptak og første rammer før endelig videogenerering.
Det gjør det lettere å behandle utøveren som en tilbakevendende figur i stedet for å lage en ny person hver gang kameraet kutter.
Hvis figurkontinuitet er hovedproblemet, se den separate guiden vår til de beste AI-musikkvideogeneratorene for figurkonsistens.

Regisser opptredenen med AI Director
En opptredens-MV trenger også kreative beslutninger.
For eksempel:
Hold første vers filmisk og historiedrevet. Bruk opptredensbilder rett mot kamera i refrenget. Vend tilbake til et nærbilde av opptreden til den siste kroken.
Det er den typen retning som kan utvikles gjennom BeatViz AI Director, i stedet for å oversette hver kreative beslutning manuelt til separate genereringsprompter.
Bruk Lip Sync der det faktisk betyr noe
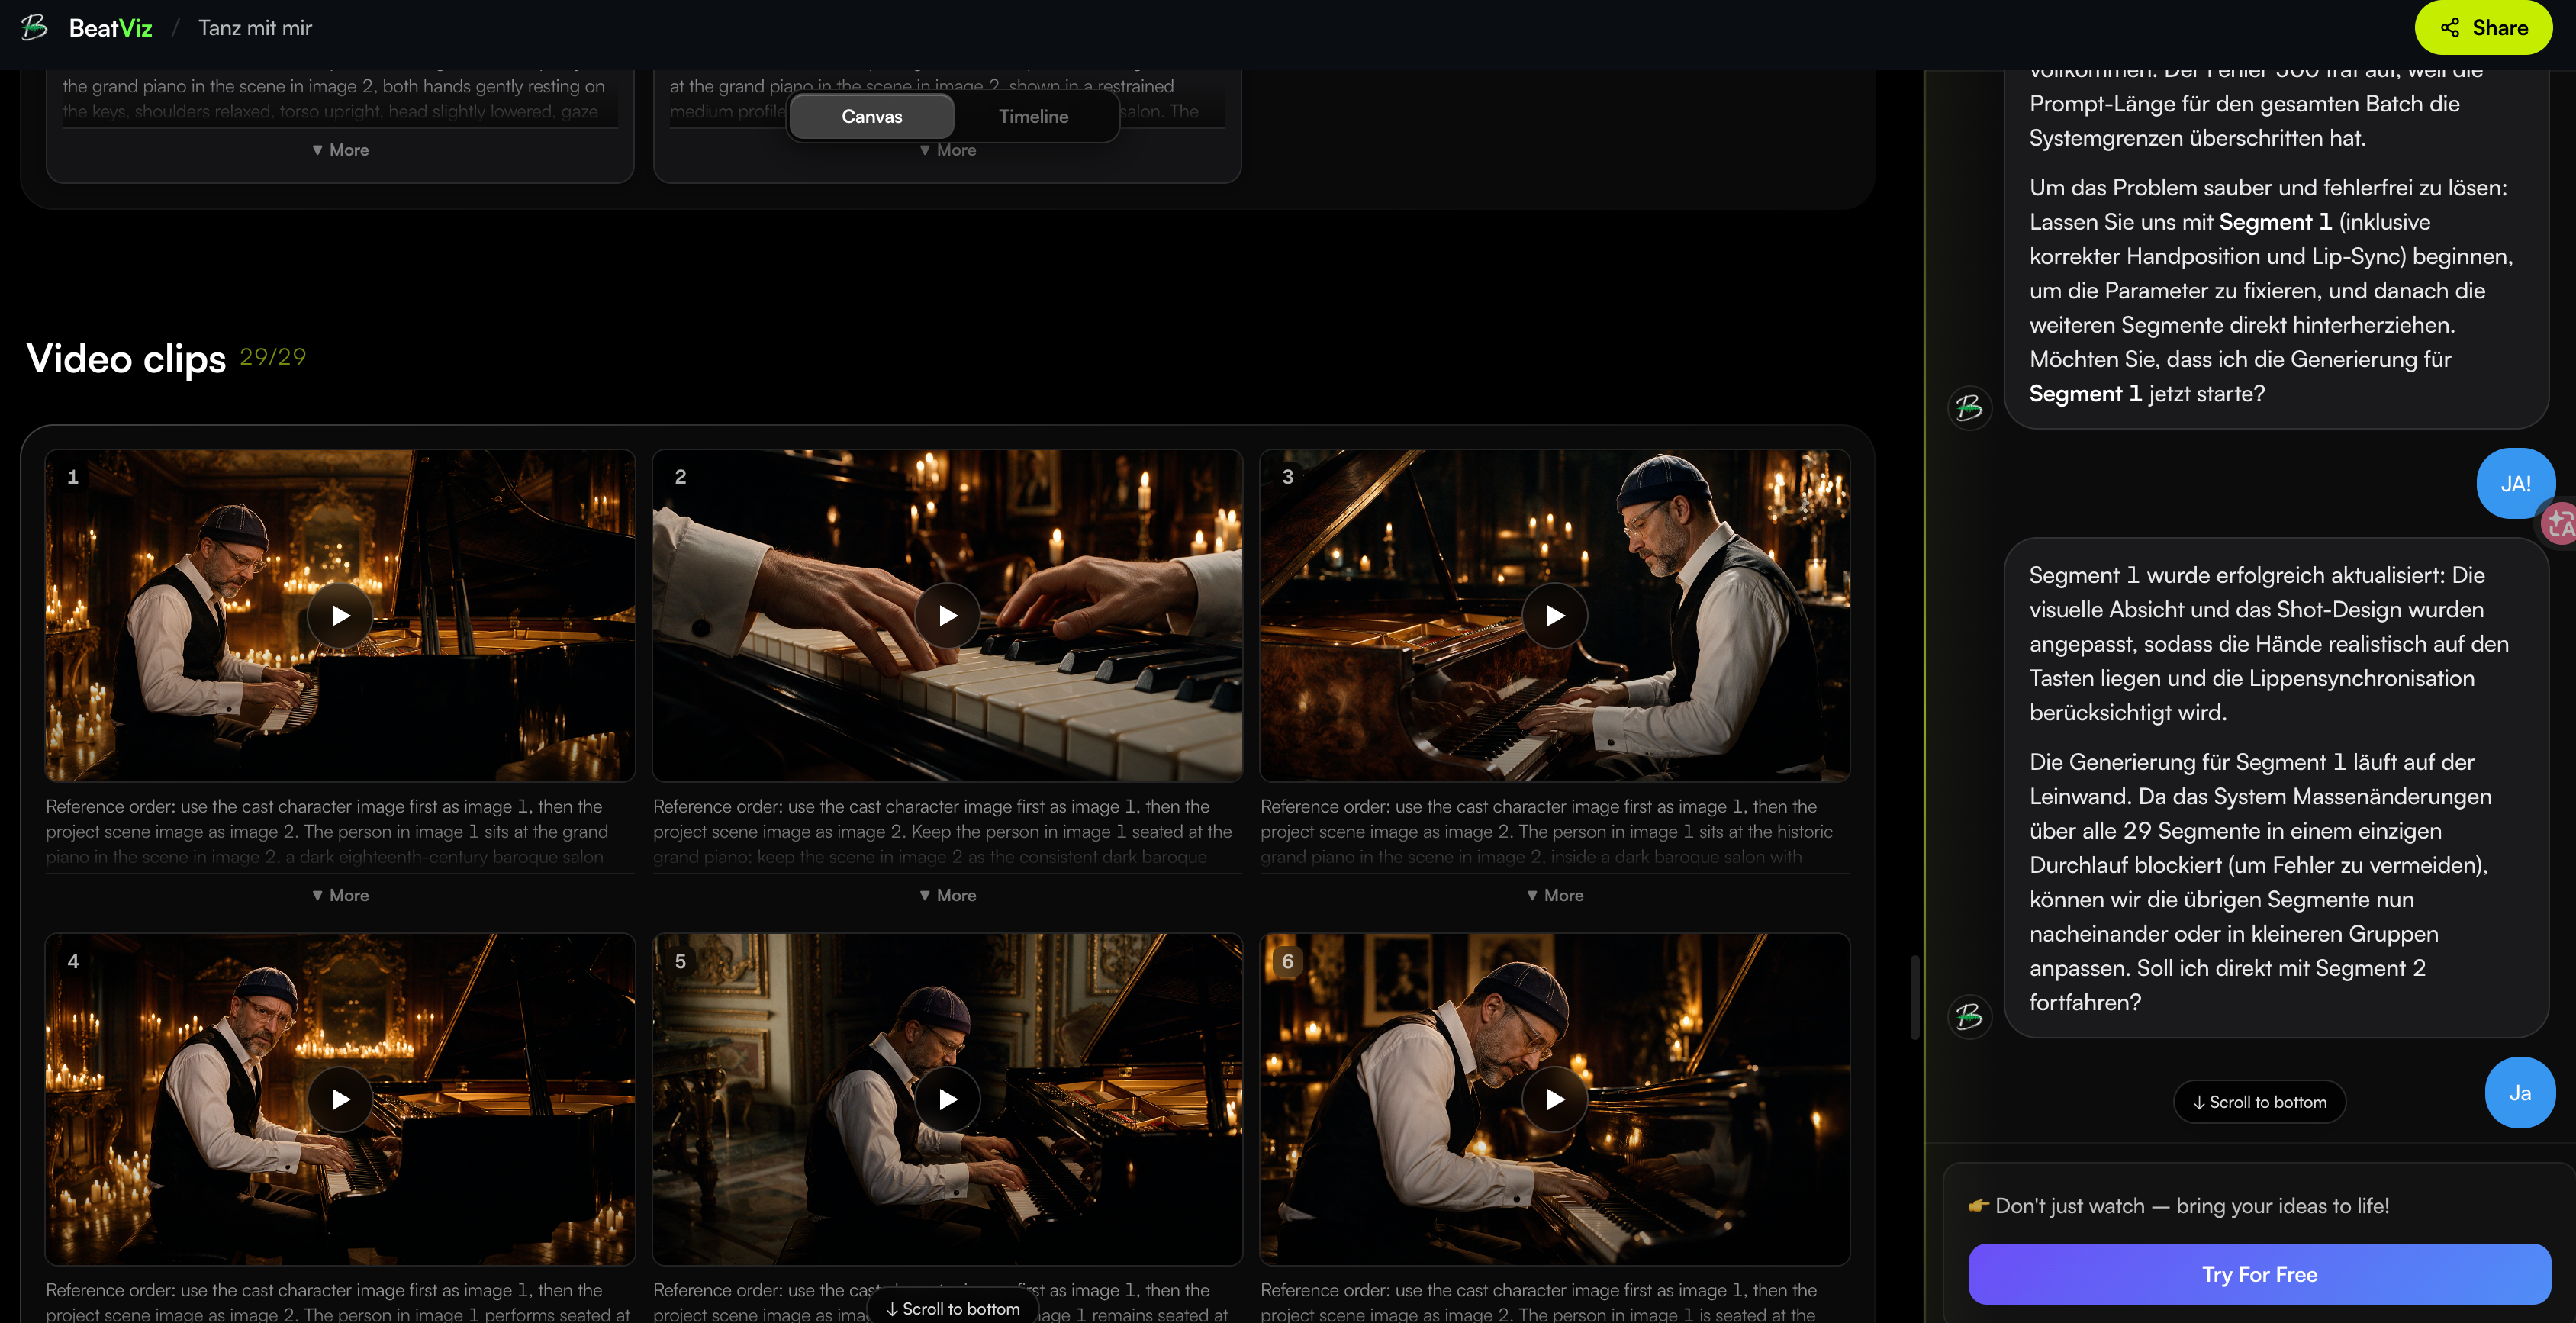
Den mest relevante delen av BeatViz for denne sammenligningen er Editor.
Når et ferdig videoklipp er plassert på lydtidslinjen, kan du velge det individuelle klippet og bruke LipSync med lyden under den samme delen.
BeatViz bruker for øyeblikket lip sync på valgt tidslinjeklipp-nivå, med individuelle lip-sync-klipp begrenset til 15 sekunder. Dette oppmuntrer naturlig til en scenebasert tilnærming: generer opptredenopptaket, juster det mot den relevante vokalfrasen, lip-sync det, og fortsett deretter å bygge resten av videoen rundt det.
Dette er nyttig når du vil ha:
- •lip sync i et refreng, men ikke i en instrumental intro
- •ett spesifikt nærbilde som synger mens omliggende opptak forblir filmiske
- •flere opptredensøyeblikk spredt gjennom en hel sang
- •muligheten til å erstatte ett svakt opptredenklipp i stedet for å regenerere hele videoen
Det gjør BeatViz særlig godt egnet til skapere som tenker i en musikkvideo-tidslinje, ikke bare en animert sanger.
Vil du at refrenget skal opptre mens versene forblir filmiske?
Start med BeatViz Workflow, utvikle den visuelle retningen i AI Director, og finpusse individuelle vokalopptak inne i Editor.
For en dypere gjennomgang av redigeringsarbeidsflyten, se BeatViz Editor-veiledningen.
2. Neural Frames — Best til vokalvideoer med musikkreaktiv kontroll
Neural Frames er et annet sterkt valg når du vil at utøveren skal eksistere inne i en større musikkvideostruktur.
Autopilot-arbeidsflyten beveger seg gjennom musikk, sporoppsett, storyboard-skaping og endelig videogenerering.
Plattformens Vocal Video-modus er spesielt designet for å la figurer synge med den opplastede sangen.
Viktigere: Vocal Video tvinger ikke nødvendigvis hver scene til å synge. Den nåværende arbeidsflyten kan slå på lip sync på valgte klipp eller spesifikke nøkkelrammer, noe som gjør den nyttig til å kombinere vokalopptreden med ikke-opptreden-footage.
Neural Frames støtter også flere kontrollerbare figurer i Autopilot og lar skapere justere individuelle scener i storyboardet før endelig generering. Dokumentasjonen lister for øyeblikket Autopilot-prosjekter på opptil 15 minutter.
Best til: skapere som vil ha et lydreaktivt videosystem med detaljert storyboardkontroll og selektive sangscener.
Mulig vurdering: grensesnittet gir deg mange kreative variabler. Den fleksibiliteten er nyttig, men noen som vil ha en enklere «last opp sang og få en ferdig MV»-opplevelse kan foretrekke en mer automatisert arbeidsflyt.
3. Freebeat — Best til raske automatiserte Singing MV-er
Freebeat er et av de mest direkte posisjonerte produktene rundt begrepet Singing MV.
Den nåværende arbeidsflyten lar skapere laste opp musikk eller importere en sang, velge en skapingsmodus og velge Singing MV når de vil ha et utøverfokusert resultat.
Freebeat sier at Singing MV-systemet kan lage en lip-synket utøver fra et foto og samtidig ta sanganalyse, sceneplanlegging, figurkontinuitet og beat-bevisst redigering. Den annonserer for øyeblikket full-lengde-generering på opptil seks minutter på kvalifiserte betalte nivåer.
Det gjør Freebeat attraktivt når automatisering er prioriteten.
I stedet for å bestemme manuelt nøyaktig hvordan hvert opptredenopptak skal konstrueres, kan du la systemet bygge mye mer av videoen automatisk.
Best til: musikere som vil gå raskt fra en sang til en sangfokusert MV med relativt lite manuelt oppsett.
Mulig vurdering: automatisering og regi-kontroll er ikke det samme. Hvis du bryr deg om å nøyaktig bestemme hvilket refreng som inneholder hvilken kameravinkel, eller å bygge individuelle opptak manuelt, sammenlign redigeringsarbeidsflyten nøye før du velger.
4. Revid — Best til å kombinere sanger-lip-sync, tekster og rask musikkvideogenerering
Revid gjør skillet mellom ulike former for synkronisering særlig tydelig.
Den nåværende musikkvideo-arbeidsflyten lar skapere laste opp et spor eller bruke en Suno-lenke, velge visuell retning, velge tekst- eller beattiming, og eventuelt slå på en sanger som lip-synker tekstene.
Det genererte resultatet åpnes i en editor der scener kan endres før eksport.
Den kombinasjonen gjør Revid særlig interessant for skapere som produserer:
- •teksttunge sanger
- •rap-videoer
- •vertikalt sosialt musikkinnhold
- •videoer der teksting og sangeropptreden må jobbe sammen
Evnen til å behandle tekster, klipptiming og sangfigur som ulike lag er nyttig.
En sang kan følge tekstene uten å vise en sanger i hvert opptak.
Best til: raske skaperorienterte musikkvideoer der tekster, sosiale formater og vokalopptreden alle betyr noe.
5. Kaiber — Best til kreative bilde- og video-lip-sync-opptak
Kaiber er et litt annerledes valg.
I stedet for å tenke bare i en fullt automatisert musikkvideo-pipeline, tilbyr Kaiber Image Lip Sync- og Video Lip Sync-arbeidsflyter.
Image Lip Sync starter med et stillbilde og lyd.
Video Lip Sync starter med eksisterende videofootage og lyd.
Kaiber dokumenterer for øyeblikket støtte for Image Lip Sync som matcher lyd opptil 300 sekunder, mens Video Lip Sync støtter lyd opptil 30 sekunder. Selskapet anbefaler også å bruke et tydelig, fremovervendt enkelt subjekt og teste kortere lydseksjoner før du binder deg til lengre genereringer.
Dette gjør Kaiber nyttig når du allerede vet nøyaktig hvordan opptredenopptaket skal se ut.
Du kan for eksempel allerede ha:
- •et sterkt sangerportrett
- •et generert opptredensbilde
- •et eksisterende filmisk videoopptak
- •et spesifikt nærbilde du vil synkronisere
I stedet for å be ett verktøy om å lage hele MV-en, kan du bruke Kaiber som én fase inne i en større arbeidsflyt.
Best til: individuelle stiliserte sangopptak og skapere som foretrekker å sette sammen sin egen produksjonspipeline.
6. HeyGen — Best til å få et foto til å synge
Noen ganger trenger du ikke en komplett musikkvideo.
Du vil bare ha en overbevisende sangfigur.
Der passer HeyGens Make Photo Sing-arbeidsflyt godt.
Det nåværende verktøyet starter med et portrett og et lydspor, og animerer deretter ansiktet til å følge sangen. HeyGen posisjonerer funksjonen rundt realistisk munnbevegelse og ansiktsuttrykk, og anbefaler et tydelig fremovervendt portrett som startbilde.
Dette gjør den nyttig til:
korte sosiale klipp, virtuelle sangere, figureksperimenter, animerte portretter, memer og opptredensinnsatser.
Men det finnes et viktig skille.
Et godt sang-avatar-verktøy er ikke automatisk et fullt musikkvideoproduksjonssystem.
Hvis hele målet ditt er:
Jeg vil at dette fotografiet skal synge sporet mitt.
er HeyGen et logisk valg.
Hvis målet ditt er:
Jeg vil ha en tre minutter lang musikkvideo med historiescener, steder, kameraskift, opptredensseksjoner og flere visuelle idéer.
trenger du sannsynligvis en bredere arbeidsflyt rundt den.
Best til: sangportretter og utøver-først-klipp.
7. Hedra — Best til lengre lyd-drevne figuropptredener
Hedra er et annet sterkt figuropptredensvalg.
De nåværende Hedra Avatar- og Character 3-arbeidsflytene er bygget rundt bilde + lyd-generering, med lip sync og ansiktsbevegelse drevet av soundtracket.
Hedra støtter for øyeblikket langform lyd-drevet avatargenerering opptil 10 minutter, og lister eksplisitt tale og sang som bruksområder.
Det gjør Hedra særlig interessant hvis det kreative konseptet involverer én figur som leverer en lang kontinuerlig vokalopptreden.
For eksempel:
en stilisert virtuell sanger, en låst-kamera studioopptreden, en animert figur som synger mot kamera, eller en langform vokalpresentasjon.
En kontinuerlig lyd-drevet figuropptak og en musikkvideo med flere locations er likevel to ulike produksjonsproblemer.
Vil du ha konstante sceneskift, historieutvikling, flere kameraoppsett og musikkvideo-pacing, kan du fortsatt trenge å bygge en separat redigeringsarbeidsflyt rundt de genererte opptredenene.
Best til: lengre sangfigur- og avataropptredener der lyd-drevet ansiktsanimasjon er hovedkravet.
Hvilket AI Lip Sync-musikkvideoverktøy bør du velge?
Det finnes ikke ett riktig svar fordi «lip-sync-musikkvideo» kan beskrive svært ulike ting.
Vil du at ett fotografi skal synge, start med en spesialist som HeyGen.
Har du allerede et sterkt bilde eller en video og trenger hovedsakelig å gjøre det om til et sangopptak, er Kaiber verdt å vurdere.
Vil du ha en lang, kontinuerlig figuropptreden, er Hedra særlig relevant.
Er prioriteten rask automatisk sang-til-video-generering, tilbyr Freebeat og Revid svært automatiserte tilnærminger.
Vil du ha et musikkbevisst storyboard med valgte Vocal Video-scener, gir Neural Frames betydelig kontroll.
Og er målet å behandle lip sync som ett element inne i en full opptredens-MV — med narrative scener, tilbakevendende figurer, opptaksplanlegging og tidslinjeredigering — er BeatViz designet rundt den produksjonsstrukturen.
Derfor hjelper det å definere den ønskede ferdige videoen før du velger lip-sync-teknologien.
Vil du ha en sang-avatar?
- •Et sosialt klipp?
- •En visualiser?
- •En lyric-video?
- •Eller en faktisk musikkvideo med flere scener?
Det er ulike jobber.
Planlegger du en full utgivelse i stedet for ett sangklipp?
Utforsk den komplette BeatViz musikkvideo-arbeidsflyten, og sjekk deretter BeatViz Pricing før du bestemmer hvor mye av sangen du vil generere og finpusse.
Hvordan BeatViz bruker Lip Sync inne i en full musikkvideo
Lip sync er mest effektivt når det er integrert i den kreative strukturen i sangen.
Tenk på et hypotetisk tre minutter langt pop-rock-spor.
Introduksjonen åpner med miljøbilder.
Første vers følger artisten gjennom en tom leilighet.
Pre-refrenget kutter nærmere sangeren.
Deretter blir refrenget en direkte opptreden.
Vers to vender tilbake til historiefotage.
Bridgen bruker ett intimt nærbilde.
Det siste refrenget utvider seg til en større opptredenssekvens.
Bare noen av de scenene trenger at munnen matcher vokalen.
Resten av videoen må fortsatt respondere på musikken.
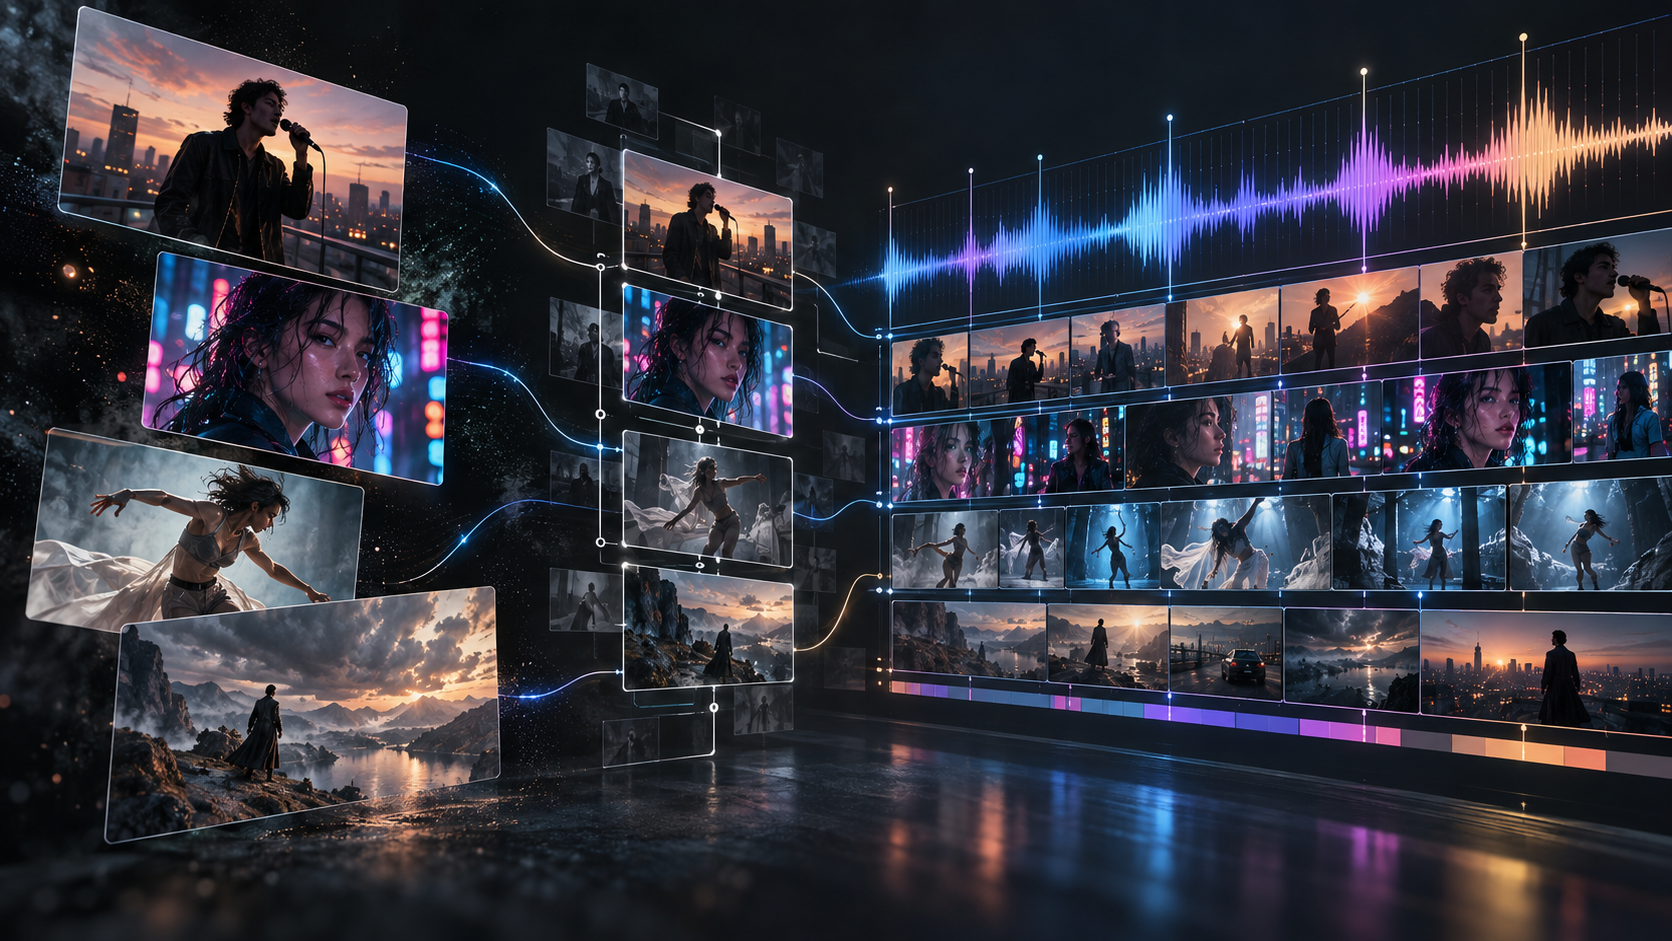
Derfor skiller BeatViz-arbeidsflyten bred kreativ planlegging fra endelig klippfinpuss.
Workflow: Bygg videoen før du finpusser sangopptakene
Start med å laste opp sporet i Workflow.
Bygg det kreative konseptet.
Etabler figuren.
Gjennomgå scenene.
Gjennomgå nøkkelrammer før du binder deg til endelig bevegelse.
Dette betyr noe fordi figurkonsistens vanligvis er lettere å løse før du genererer en lip-synket opptreden enn etterpå.
En sterk første ramme gir genereringsmodellen tydeligere informasjon om ansikt, hår, garderobe, lys, komposisjon og kameravinkel.
For en mer komplett forklaring av hele prosessen, les Slik gjør du musikk om til video med AI.
AI Director: Bestem når artisten opptrer
Tenk deretter som en regissør i stedet for en lip-sync-tekniker.
Du kan bruke AI Director til å beskrive hvilken rolle opptreden skal spille i videoen.
For eksempel:
Hold åpningen filmisk uten sang. Introduser artisten i et middels opptredenopptak i pre-refrenget. Bruk et direkte nærbilde med lip sync i refrenget, og vend deretter tilbake til narrativ footage etter kroken.
Den instruksjonen inneholder mye mer nyttig kreativ informasjon enn:
Gjør hele videoen til lip sync.
Editor: Fiks opptakene som betyr noe
Til slutt, bruk BeatViz Editor når individuelle opptak trenger mer kontroll.
Et opptredenklipp kan justeres mot relevant lyd på tidslinjen og lip-synkes uavhengig.
Hvis ett klipp feiler, kan du jobbe med den delen uten å behandle hele den ferdige musikkvideoen som disponibel.
Den scene-nivå-tilnærmingen er særlig verdifull fordi generativ video er probabilistisk.
Målet er ikke å forvente at hvert opptak er perfekt på første forsøk.
Målet er å ha en arbeidsflyt der de svake opptakene kan identifiseres og fikses uten å bygge alt rundt dem på nytt.
Hvorfor du ikke bør lip-synke hvert opptak i en musikkvideo
En av de enkleste måtene å få en AI-musikkvideo til å føles gjentakende på, er å la utøveren synge kontinuerlig.
Ekte musikkvideoer beveger seg ofte mellom ulike visuelle funksjoner.
Ett opptak etablerer utøveren.
Et annet utvikler historien.
Et annet skaper atmosfære.
Et annet fremhever garderobe eller koreografi.
Et annet responderer på en instrumental pause.
Deretter vender videoen tilbake til artisten når det å se vokalopptredenen faktisk tilfører noe.
Tenk på opptredenfootage som tegnsetting.
Et sterkt nærbilde under en viktig tekstlinje kan føles kraftfullt fordi du ikke har sett den samme munnen bevege seg i de to foregående minuttene.
En nyttig struktur kan se slik ut:
Opptreden → Historie → Miljø → Opptreden → B-roll → Dans → Nærbilde → Historie → Endelig opptreden
Dette gir lip-sync-seksjonene mer tyngde.
Det kan også redusere antallet krevende ansiktsopptredensopptak du trenger å generere.
Det er en grunn til at den bredere guiden vår om å gjøre musikk om til video med AI behandler lip sync som en kreativ beslutning på scenenivå i stedet for definisjonen av hele videoen.
Tips til bedre AI-sang og lip-sync-opptak
Bruk én tydelig synlig sanger
Lip-sync-modeller presterer generelt bedre når de tydelig kan identifisere hvilket ansikt som skal følge lyden.
For viktige vokaløyeblikk, unngå å plassere flere like fremtredende ansikter i samme ramme med mindre verktøyet spesifikt støtter flere talere eller utøvere.
Gi ansiktet nok skjermplass
Et svært vidt helkroppsopptak kan skjule leppebevegelsen.
Et ekstremt nærbilde kan gjøre ansiktsartefakter mye mer åpenbare.
Middels opptak, middels nærbilder og konvensjonelle nærbilder er ofte tryggere startpunkter.
Kaibers egen lip-sync-veiledning anbefaler på samme måte å merke seg kameraavstand og bruke et tydelig synlig, fremovervendt subjekt.
Etabler figurkonsistens først
Hvis sangerens ansiktsstruktur endrer seg mellom hvert opptredenopptak, løser det ikke det større kontinuitetsproblemet å forbedre munnbevegelsen.
Lås utøveren før du bruker tid på å finpusse vokalanimasjonen.
Bruk opptreden der publikum forventer det
Et refreng, en emosjonell krok, en tekstlinje rett mot kamera, et rapvers eller et vokalklimaks har vanligvis mer nytte av lip sync enn en overgang eller instrumental passasje.
Bruk de beste genereringene der seere mest sannsynlig ser på utøverens ansikt.
Test krevende vokal før du renderer for mye
Rask rap, aggressive konsonanter, overlapping vokal, ad-libs, harmonier og uvanlig frasering kan være mer krevende enn en langsom, ren vokallinje.
Å teste en representativ del først kan hjelpe deg med å forstå hvordan verktøyet håndterer det spesifikke sporet ditt.
Ikke ignorer den første rammen
Lip-sync-modellen trenger fortsatt en troverdig utøver å animere.
Hår som dekker munnen, ekstreme profiler, uvanlig ansiktsforvrengning eller dårlig bildekvalitet kan introdusere problemer før synkroniseringen i det hele tatt begynner.
Kan du bruke Lip Sync med en Suno-sang?
Ja.
Et ferdig Suno-spor er fortsatt en lydfil, så det kan brukes med AI-videoverktøy som tar imot opplastet musikk eller kompatible sangimporter.
Det viktigere spørsmålet er hva slags video du vil bygge rundt den.
Vil du bare ha én avatar som synger sporet, kan et foto-til-sang-verktøy være nok.
Vil du ha en full musikkvideo, må du også vurdere:
- •sangstruktur
- •figurer
- •steder
- •visuell historiefortelling
- •opptredensbilder
- •redigering
- •scenekonsistens
Vi dekker den arbeidsflyten separat i Slik lager du en musikkvideo med Suno AI.
Du kan også laste opp det ferdige sporet direkte inn i BeatViz Music Video Generator og bygge den visuelle produksjonen fra sangen selv.
Ofte stilte spørsmål
Hvilken AI-musikkvideogenerator støtter lip sync?
BeatViz, Neural Frames, Freebeat, Revid, Kaiber, HeyGen og Hedra tilbyr alle for øyeblikket lip-sync- eller lyd-drevne sangfunksjoner i ulike former. Riktig valg avhenger av om du trenger én sangfigur eller en hel musikkvideo med flere scener.
Hva er den beste AI-en for å få en sanger til å synge?
For å gjøre ett portrett om til en sangfigur er dedikerte avatar- og fotoanimasjonsverktøy som HeyGen og Hedra sterke valg.
For å bygge den sangeren inn i en komplett musikkvideo gir plattformer som BeatViz, Neural Frames, Freebeat og Revid bredere sang-til-video-arbeidsflyter.
Kan AI lip-synke en hel sang?
Ja, noen plattformer støtter flere minutter lyd-drevet opptreden.
Å generere én kontinuerlig sangfigur er likevel annerledes enn å bygge en full musikkvideo.
For de fleste MV-er skaper det vanligvis mer visuell variasjon å lip-synke viktige opptredensbilder selektivt og blande dem med ikke-opptreden-scener.
Hva er forskjellen mellom lip sync og beatsynk?
Lip sync synkroniserer en utøvers munn med vokal.
Beatsynk justerer redigeringsbeslutninger som kutt, overganger eller scenetiming mot rytmen i musikken.
En video kan være beatsynket uten å inneholde noen sanger i det hele tatt.
Kan jeg lage en AI-sanger fra ett foto?
Ja. Verktøy som HeyGen, Hedra, Kaiber og Freebeat gir for øyeblikket arbeidsflyter som kan animere en figur eller et portrett ved hjelp av lyd.
Kan jeg bruke en Suno-sang til en AI lip-sync-musikkvideo?
Ja.
Når du har sangen, kan du bruke lyden med kompatible AI-videoverktøy. Noen plattformer tilbyr også direkte Suno-relaterte importarbeidsflyter.
Trenger jeg lip sync i hver scene?
Nei.
I mange tilfeller blir videoen mer filmisk når opptredenfootage blandes med historiescener, atmosfære, B-roll, dans og andre visuelle idéer.
Bruk lip sync der det å se sangeren opptre tilfører emosjonell eller musikalsk verdi.
Kan AI lage en full opptredensmusikkvideo?
Ja, men dette er en mer kompleks oppgave enn å animere et portrett.
En komplett opptredens-MV kan kreve sanganalyse, sceneplanlegging, figurkonsistens, opptredensgenerering, lip sync, beat-bevisst timing, redigering og selektiv regenerering.
Derfor betyr den underliggende arbeidsflyten like mye som lip-sync-modellen.
Gjør sangen om til en opptreden, ikke bare en sang-avatar
En overbevisende AI-musikkvideo trenger mer enn en bevegelig munn.
Utøveren må føles som den samme personen fra opptak til opptak.
Kameraet må endre seg med hensikt.
Historien trenger rom til å puste.
Klippet må respondere på musikken.
Og øyeblikkene der artisten synger, bør føles bevisste.
Det er den virkelige forskjellen mellom å lage et AI-sangklipp og å regissere en AI-opptredensmusikkvideo.
Hvis du allerede har sangen, kan du starte med BeatViz AI Music Video Generator, utvikle konseptet gjennom Workflow eller AI Director, og gå inn i Editor når individuelle opptredensbilder trenger strammere kontroll.
Bygg opptredenen rundt sangen din — ikke omvendt.